
Este material foi criado para profissionais, gestores, empreendedores e equipes de tecnologia que querem compreender inteligência artificial de forma didática e, ao mesmo tempo, enxergar os requisitos de dados, segurança e infraestrutura necessários para usar IA em ambiente empresarial.
A história da inteligência artificial: de uma pergunta filosófica a uma infraestrutura global
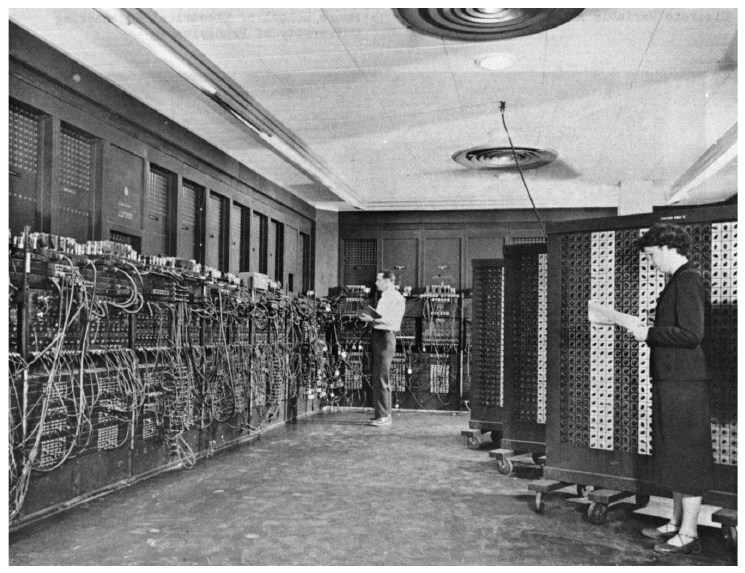
Antes de existir o termo "inteligência artificial", cientistas já tentavam transformar raciocínio em procedimentos formais. A computação eletrônica nasceu em um contexto no qual cálculos militares, lógica matemática e teoria da informação começaram a convergir. Máquinas como o ENIAC mostraram que operações antes dependentes de trabalho humano podiam ser automatizadas em velocidade inédita, mas programar ainda era um processo físico e trabalhoso.
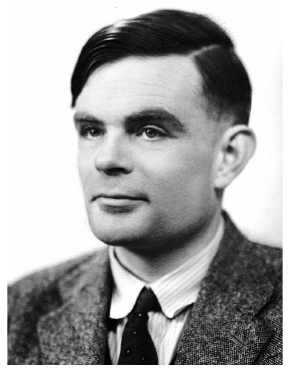
Em 1950, Alan Turing publicou "Computing Machinery and Intelligence" e deslocou a discussão de "máquinas realmente pensam?" para uma questão operacional: uma máquina poderia se comportar, em uma conversa, de forma suficientemente convincente para ser confundida com um ser humano? O chamado jogo da imitação tornou-se um dos marcos intelectuais da área.
Em 1955, John McCarthy, Marvin Minsky, Nathaniel Rochester e Claude Shannon propuseram um projeto de verão em Dartmouth. O encontro de 1956 é amplamente tratado como o nascimento da inteligência artificial como disciplina. O ponto central da proposta era ambicioso: aspectos da aprendizagem e da inteligência poderiam ser descritos com precisão suficiente para que uma máquina os simulasse.
A partir daí, a IA passou por ciclos de entusiasmo e frustração. Nas décadas de 1960 e 1970 surgiram sistemas simbólicos e experimentos como ELIZA. Quando promessas superaram a capacidade de hardware, dados e algoritmos, vieram os chamados "invernos da IA", períodos de redução de investimento. Nos anos 1980, sistemas especialistas recuperaram interesse ao codificar regras de especialistas humanos para domínios específicos.
Em 1997, o supercomputador Deep Blue, da IBM, venceu Garry Kasparov em uma partida de seis jogos. O feito mostrou a força da busca massivamente paralela e de hardware especializado. Ainda não era a IA generativa atual, mas alterou a percepção pública sobre o que computadores podiam fazer.
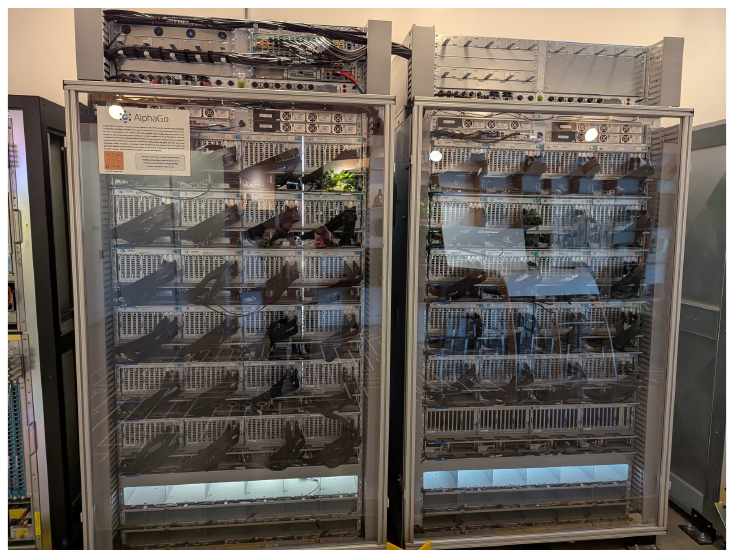
A virada seguinte veio com dados em escala, GPUs e redes neurais profundas. Em 2012, AlexNet apresentou resultados muito superiores no ImageNet e ajudou a consolidar o deep learning como abordagem dominante em visão computacional. Em 2016, AlphaGo derrotou Lee Sedol por 4 a 1 combinando redes neurais, busca e reinforcement learning, demonstrando que sistemas podiam aprender estratégias altamente complexas.
Em 2017, o artigo "Attention Is All You Need" apresentou a arquitetura Transformer. Em vez de processar sequências apenas passo a passo, os mecanismos de attention passaram a relacionar diferentes partes do contexto com grande eficiência de paralelização. Essa base arquitetural abriu caminho para os grandes modelos de linguagem modernos.
Em 30 de novembro de 2022, o ChatGPT foi apresentado em formato conversacional e acelerou a adoção pública de IA generativa. Entre 2023 e 2026, a fronteira avançou para modelos multimodais, raciocínio, geração de vídeo, programação e agentes capazes de usar ferramentas. A discussão empresarial mudou: já não é apenas "o que a IA consegue responder?", mas "quais processos ela pode executar, com quais dados, controles e infraestrutura?"
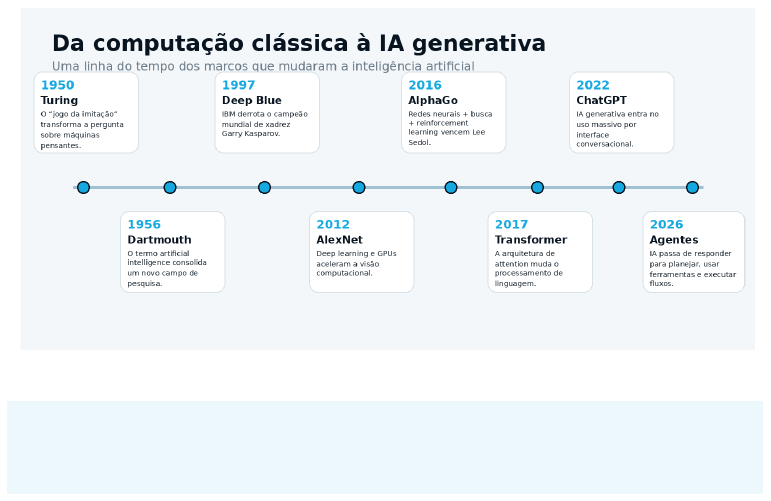
Ideia-chave: a história da IA não é uma linha reta. O avanço resulta da combinação de três fatores: melhores algoritmos, mais dados e mais capacidade computacional. Quando um deles fica para trás, o progresso desacelera.
Do ENIAC aos data centers de IA
O contraste entre os primeiros computadores eletrônicos e os clusters modernos é didático. O ENIAC ocupava salas inteiras e era reprogramado com cabos e painéis. Hoje, uma infraestrutura de IA concentra milhares de aceleradores, redes de altíssima velocidade e storage distribuído. A escala física voltou a ser central, agora para sustentar modelos com bilhões ou trilhões de parâmetros e cargas de inferência contínuas.
O que é inteligência artificial, em linguagem simples
Inteligência artificial é um campo da computação dedicado a sistemas capazes de executar tarefas que normalmente associamos a percepção, aprendizagem, raciocínio, previsão, linguagem, geração de conteúdo ou tomada de decisão. A definição é ampla porque IA não é um produto único: ela é uma família de técnicas e arquiteturas.
Um filtro de spam, um sistema de recomendação, um detector de fraude, um modelo que identifica objetos em vídeo e um assistente que escreve um relatório podem todos ser considerados aplicações de IA, embora usem tecnologias diferentes.
A distinção mais útil para quem está começando é separar IA, machine learning, deep learning e IA generativa. Machine learning é um subconjunto da IA no qual modelos aprendem padrões a partir de dados. Deep learning é um subconjunto do machine learning baseado em redes neurais com várias camadas. IA generativa é uma classe de sistemas, frequentemente baseados em deep learning, treinados para criar conteúdo novo.
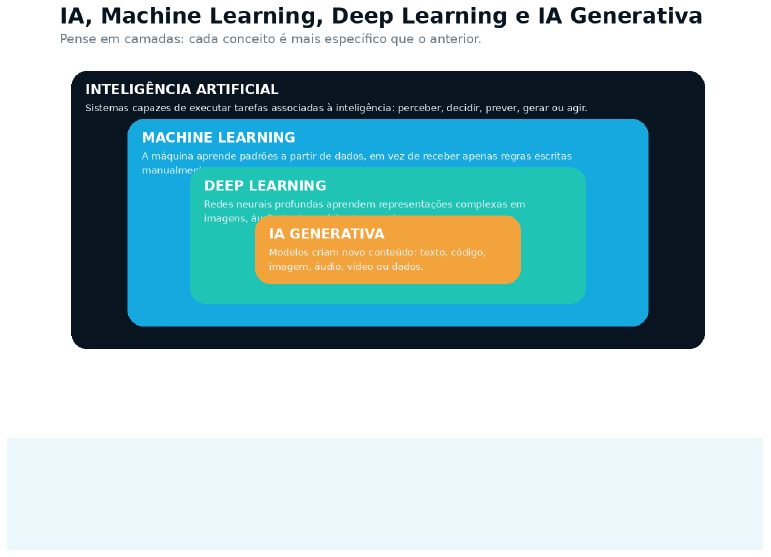
Não confunda automação com IA: uma automação pode seguir regras fixas sem aprender nada. IA se torna relevante quando o sistema precisa reconhecer padrões, lidar com incerteza, interpretar linguagem ou gerar respostas. Muitas soluções empresariais combinam as duas coisas.
Como as máquinas aprendem: dados, treinamento e inferência
Em programação tradicional, o desenvolvedor escreve regras explícitas e o software aplica essas regras aos dados. Em machine learning, fornecemos exemplos e um algoritmo ajusta parâmetros para reduzir erros. O resultado desse processo é um modelo.
O treinamento é a etapa em que o modelo ajusta seus parâmetros. Já a inferência é o momento em que um modelo treinado recebe um dado novo e produz uma previsão, classificação, recomendação ou geração. Essa diferença tem impacto direto em infraestrutura: treinamento costuma demandar grandes blocos de GPU e longos períodos de computação; inferência pode variar desde uma CPU até clusters de aceleradores, dependendo do tamanho do modelo e da latência desejada.
Três paradigmas aparecem com frequência. No aprendizado supervisionado, cada exemplo tem um rótulo e o modelo aprende a associar entrada e saída. No não supervisionado, o sistema procura estrutura em dados sem rótulos explícitos. No reinforcement learning, um agente aprende por tentativa e erro a maximizar recompensas.
Na prática empresarial, o ciclo de ML inclui coleta de dados, tratamento, divisão entre treino e teste, treinamento, validação, implantação e monitoramento. Modelos degradam quando o comportamento do mundo muda, fenômeno conhecido como drift. Por isso, IA em produção é uma disciplina operacional contínua, não um projeto que termina no primeiro deploy.
Exemplo didático — previsão de churn: uma operadora pode treinar um modelo com histórico de consumo, chamados, pagamentos e cancelamentos. O objetivo não é "adivinhar" aleatoriamente, mas aprender padrões associados a clientes que cancelaram. Na inferência, o modelo calcula a probabilidade de churn para clientes ativos. O valor nasce quando essa previsão é integrada a uma ação: oferta, atendimento ou intervenção comercial.
Redes neurais e deep learning: por que deram um salto
Redes neurais artificiais são modelos compostos por unidades matemáticas organizadas em camadas. Cada conexão carrega pesos que são ajustados durante o treinamento. Quanto mais profundas e adequadas ao problema forem as arquiteturas, maior a capacidade de aprender representações complexas.
O avanço do deep learning não aconteceu por uma única invenção. GPUs permitiram executar muitas operações em paralelo; grandes bases de dados forneceram exemplos; novas técnicas de treinamento melhoraram estabilidade e generalização; e bibliotecas de software democratizaram o desenvolvimento.
Convolutional Neural Networks ganharam destaque em imagens. Redes recorrentes e suas variantes foram importantes para sequências. Transformers tornaram-se dominantes em linguagem e expandiram para visão, áudio e multimodalidade. O princípio comum é aprender representações diretamente dos dados, reduzindo a necessidade de especificar manualmente todas as características relevantes.
Por que GPU? Treinar redes neurais exige enorme volume de multiplicações de matrizes. GPUs foram projetadas para computação altamente paralela e por isso se tornaram a base de muitas cargas de IA. A escolha entre GPU, CPU ou outros aceleradores depende do modelo, orçamento, latência e escala.
IA generativa e LLMs: como a nova geração funciona
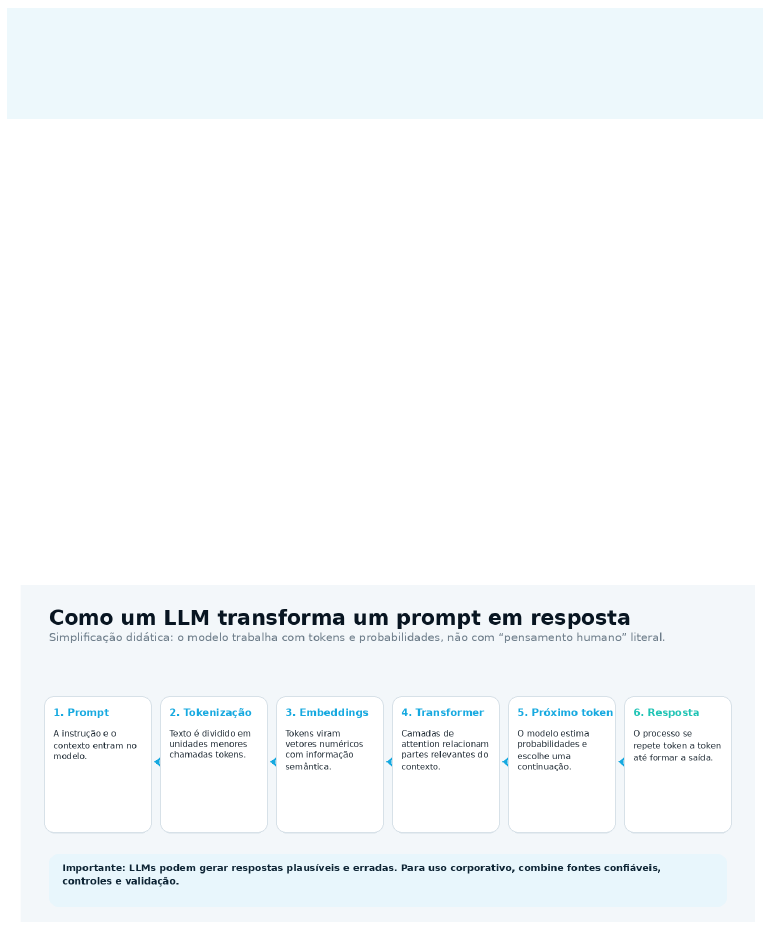
IA generativa cria novos conteúdos com base em padrões aprendidos. Em modelos de linguagem, o mecanismo fundamental é prever sequências de tokens condicionadas ao contexto anterior. Essa descrição parece simples, mas modelos em grande escala aprendem regularidades de linguagem, conhecimento factual, estruturas de código e relações semânticas capazes de suportar tarefas muito diferentes.
Tokens são unidades em que o texto é dividido. Embeddings representam tokens ou trechos como vetores numéricos. O Transformer aplica mecanismos de attention para calcular quais partes do contexto são mais relevantes em cada etapa. O modelo então estima a distribuição de probabilidade do próximo token e repete o processo até formar a resposta.
Um LLM não é um banco de dados tradicional. Ele comprime padrões em parâmetros e pode produzir informação plausível que não corresponde à realidade. Isso explica as "alucinações". Quanto maior a criticidade da tarefa, mais importante é limitar fontes, exigir evidências, registrar decisões e manter validação humana quando necessário.
O contexto é outro conceito essencial. Cada modelo possui uma janela de contexto que determina quanto conteúdo pode considerar em uma interação. Contextos maiores ajudam em documentos longos, mas não eliminam a necessidade de arquitetura. Jogar todo o acervo corporativo dentro do prompt é caro, lento e inseguro; RAG e ferramentas de busca selecionam apenas o que importa.
Um bom prompt define objetivo, contexto, restrições, formato e critérios de qualidade. Em aplicações profissionais, o prompt é apenas uma camada. A qualidade depende também do modelo, dos dados, das ferramentas, da orquestração e dos testes.
Fine-tuning ou RAG? RAG é apropriado quando o problema principal é trazer conhecimento atualizado e rastreável. Fine-tuning é mais útil para alterar comportamento, estilo, formato ou desempenho em um domínio. Muitas arquiteturas combinam ambos.
RAG: IA conectada aos dados da empresa
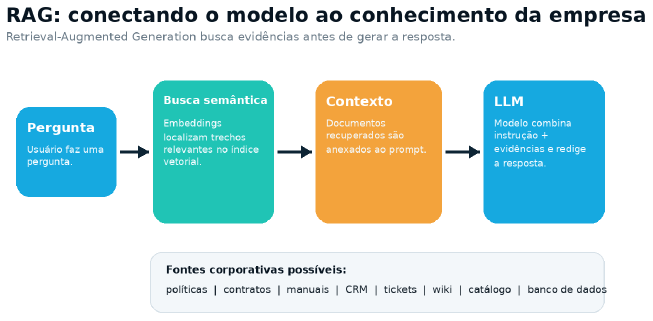
RAG, sigla para Retrieval-Augmented Generation, adiciona uma etapa de recuperação de informação antes da geração. Quando o usuário pergunta, a aplicação busca trechos relevantes em fontes autorizadas e envia essas evidências ao modelo. A resposta pode então ser redigida com base em conteúdo corporativo atualizado.
Uma implementação típica começa por ingestão de documentos, limpeza, divisão em chunks, geração de embeddings e indexação em um mecanismo de busca vetorial ou híbrido. Na consulta, a pergunta também é transformada em embedding, o sistema recupera candidatos, aplica filtros e eventualmente um reranker, e só então monta o contexto final para o LLM.
RAG melhora rastreabilidade e atualização, mas não é garantia automática de verdade. O retrieval pode recuperar o documento errado, perder um trecho importante ou expor conteúdo sem autorização. Sistemas maduros aplicam controle de acesso no nível da fonte, metadados, filtros, citações, avaliação e logs.
Exemplo empresarial: um assistente interno pode responder "qual é a política de backup para este tipo de ambiente?" buscando a versão vigente do documento, citando o trecho utilizado e respeitando as permissões do usuário. Isso é muito diferente de depender apenas da memória geral do modelo.
Agentes de IA: da resposta à execução
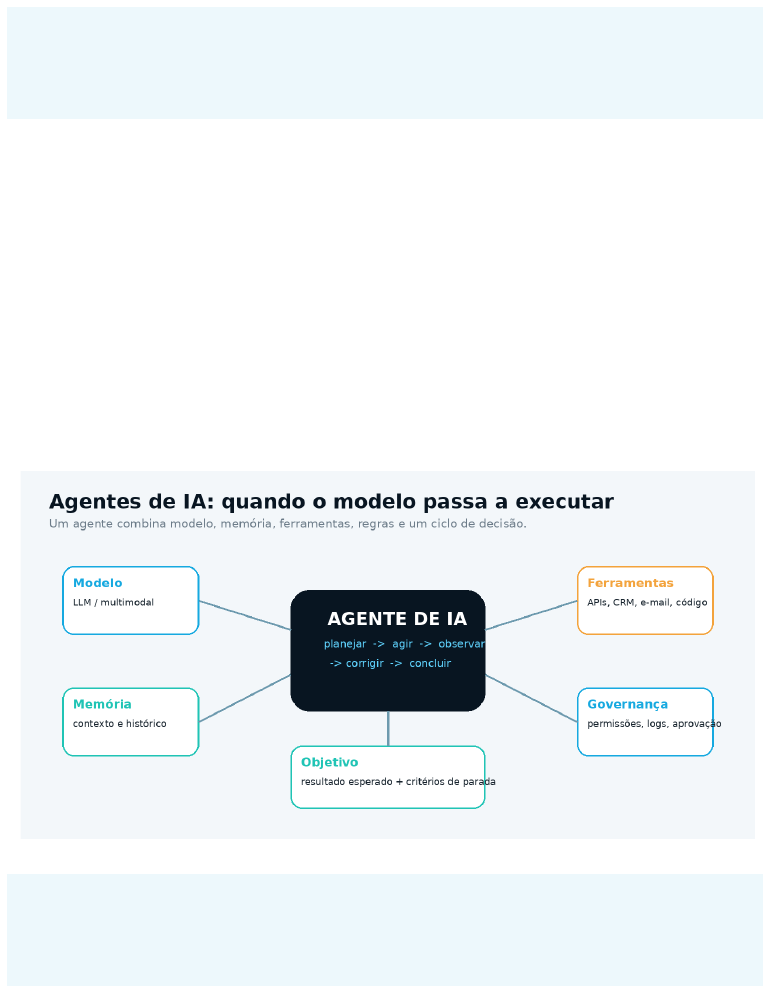
Agentes de IA ampliam o papel de um modelo. Em vez de apenas produzir texto, um agente recebe um objetivo, planeja passos, chama ferramentas, observa resultados e decide o que fazer em seguida. Ferramentas podem incluir APIs, bancos de dados, CRM, ITSM, navegadores, repositórios de código, planilhas ou sistemas internos.
Essa capacidade torna agentes atraentes para processos com múltiplas etapas: qualificar leads, consolidar dados de contas, preparar propostas, classificar tickets, investigar incidentes, gerar código, validar documentação ou executar rotinas controladas. Mas autonomia exige governança proporcional.
Quanto maior o poder de ação, maior o risco de erro. Um agente com permissão de leitura apresenta um perfil de risco diferente de um agente capaz de apagar dados, aprovar pagamentos ou alterar infraestrutura. O desenho correto inclui menor privilégio, limites de ação, validação de parâmetros, aprovações humanas, logs e mecanismos de rollback.
Regra de ouro: autonomia deve ser conquistada por evidência. Comece com "assistir", evolua para "recomendar", depois "executar com aprovação" e somente então avalie execução autônoma em tarefas de baixo risco e alta observabilidade.
Onde a IA gera valor nas empresas
O melhor projeto de IA não começa pela pergunta "qual modelo usar?", mas por "qual processo queremos melhorar e como vamos medir?". Casos de uso de alto valor geralmente combinam volume, repetição, dados disponíveis e impacto econômico.
Em atendimento, IA pode classificar contatos, resumir histórico, sugerir respostas e recuperar políticas. Em vendas, pode pesquisar contas, enriquecer CRM, preparar follow-ups e priorizar oportunidades. Em operações, pode resumir incidentes, correlacionar alarmes e acelerar troubleshooting. Em desenvolvimento, pode gerar, revisar e testar código. Em documentos, pode extrair campos, comparar cláusulas e produzir sínteses.
No ambiente de data center e cloud, IA pode apoiar capacity planning, previsão de falhas, análise de logs, detecção de anomalias, otimização energética, NOC assistido e atendimento técnico. O ganho é maior quando a IA está conectada a dados operacionais confiáveis e a workflows existentes.
| Área | Caso de uso | Arquitetura típica | Indicador de valor |
|---|---|---|---|
| Atendimento | Resposta assistida com base em políticas | LLM + RAG + CRM | tempo médio, resolução, qualidade |
| Vendas | Pesquisa e preparação de oportunidades | Agente + CRM + fontes autorizadas | tempo por conta, conversão, pipeline |
| Operações TI | Resumo e triagem de incidentes | LLM + logs + ITSM + regras | MTTR, backlog, precisão |
| Documentos | Extração e comparação | Multimodal/OCR + LLM + validação | tempo, erro, produtividade |
| Engenharia | Copiloto de código e testes | LLM + repositório + CI/CD controlado | lead time, bugs, cobertura |
| Data Center/NOC | Anomalias e correlação operacional | ML temporal + agente + observabilidade | incidentes, disponibilidade, energia |
Infraestrutura para IA: GPU, storage, rede e data center
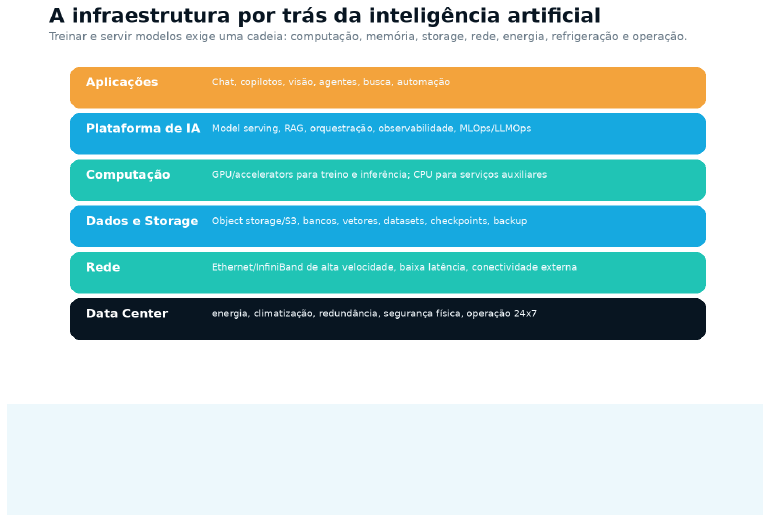
IA é software, mas a experiência do usuário é limitada pela infraestrutura física. Modelos grandes exigem computação acelerada, memória de alta largura de banda, storage capaz de alimentar datasets e checkpoints, rede com baixa latência e operação elétrica e térmica consistente.
O dimensionamento começa pelo tipo de carga. Treinamento de modelos do zero é o cenário mais intensivo e raramente é necessário para uma empresa comum. Fine-tuning pode exigir um ou poucos nós, dependendo do modelo e da técnica. Inferência pode rodar em GPU dedicada, GPU compartilhada, aceleradores em cloud ou até CPU para modelos compactos.
Além do acelerador, memória é crítica. Se o modelo não cabe na memória disponível, pode ser necessário quantizar, distribuir entre GPUs ou escolher um modelo menor. Storage também influencia o ciclo: datasets, embeddings, artefatos, logs e checkpoints crescem rapidamente. Object storage compatível com S3 é especialmente útil para datasets e artefatos em escala.
Rede torna-se um gargalo quando várias GPUs trabalham em conjunto. Para clusters de treinamento, largura de banda e latência entre aceleradores são determinantes. Em inferência empresarial, conectividade entre aplicação, dados e modelo também afeta a experiência final.
Por fim, energia, refrigeração, segurança física e disponibilidade são parte do projeto. Servidores de alta densidade podem exigir potências por rack muito superiores às de ambientes tradicionais. Data centers preparados para cargas de IA precisam avaliar densidade, redundância, refrigeração e expansão.
Cloud, on-premises ou híbrido?
Não existe uma resposta universal. Cloud acelera experimentação e elasticidade. On-premises ou bare metal pode oferecer previsibilidade, controle e economia em cargas constantes. Arquiteturas híbridas são comuns quando dados sensíveis permanecem privados e picos ou modelos específicos usam capacidade externa.
LLM as a Service (LLMaaS)
LLMaaS oferece modelos por API ou endpoint gerenciado, evitando que cada empresa monte toda a camada de serving. Para clientes corporativos, os critérios mais relevantes incluem isolamento, privacidade, SLA, escolha de modelos, controle de custos, observabilidade e residência dos dados.
Bare metal para IA
Servidores bare metal fazem sentido quando a carga exige acesso direto ao hardware, alta utilização, configurações específicas ou previsibilidade de desempenho. O modelo econômico deve comparar custo total, ocupação real, energia, suporte e ciclo de atualização.
Storage S3 e IA
Datasets, documentos, imagens, áudio, checkpoints e artefatos podem ser armazenados como objetos. A arquitetura deve planejar versionamento, criptografia, políticas de retenção, throughput e custo de movimentação.
Segurança, privacidade e governança de IA
Uma política de IA corporativa precisa tratar dados, modelos, usuários, ferramentas e decisões. O risco não está apenas no modelo: ele surge de toda a cadeia. Dados sensíveis podem ser enviados para um endpoint inadequado; um RAG pode ignorar permissões; um agente pode executar uma ação indevida; um prompt malicioso pode tentar desviar instruções.
Classificação de dados é o primeiro controle. A organização deve definir o que pode ser enviado a serviços externos, o que precisa permanecer em ambiente privado e quais informações exigem anonimização ou mascaramento. Contratos, retenção e finalidade de uso também precisam ser avaliados.
Prompt injection é uma classe de ataque na qual conteúdo de usuário ou documento tenta alterar o comportamento do sistema. Em agentes, isso pode levar a chamadas de ferramentas indesejadas. A defesa inclui separação de instruções, allowlists de ferramentas, validação de argumentos, least privilege, confirmação de ações críticas e sanitização de conteúdo.
Alucinações são um risco de qualidade e segurança. Reduzir temperatura não resolve tudo. Respostas críticas devem ser fundamentadas em fontes, avaliadas por regras ou modelos de validação e, quando necessário, submetidas a revisão humana.
Observabilidade é indispensável. Registre prompts e respostas conforme a política de privacidade, fontes recuperadas, ferramentas chamadas, latência, custo, erros e feedback. Sem telemetria, é difícil saber se um sistema de IA melhorou o processo ou apenas adicionou complexidade.
LGPD e IA: no Brasil, projetos de IA que tratam dados pessoais devem ser desenhados em conjunto com os princípios e obrigações aplicáveis da LGPD. Este guia é educativo e não substitui análise jurídica ou de privacidade específica para cada caso.
- Controle de identidade e acesso para usuários, modelos e ferramentas.
- Criptografia em trânsito e em repouso; gerenciamento seguro de segredos e chaves.
- Filtragem e classificação de dados antes do envio ao modelo.
- RAG com controle de acesso na fonte e segregação por tenant ou perfil.
- Logs e trilhas de auditoria para ações de agentes.
- Avaliação contínua de qualidade, segurança, bias e regressões.
- Human-in-the-loop para decisões financeiras, legais, de infraestrutura ou alto impacto.
- Plano de incidentes específico para aplicações de IA.
Como implantar IA na empresa sem transformar a PoC em um projeto infinito
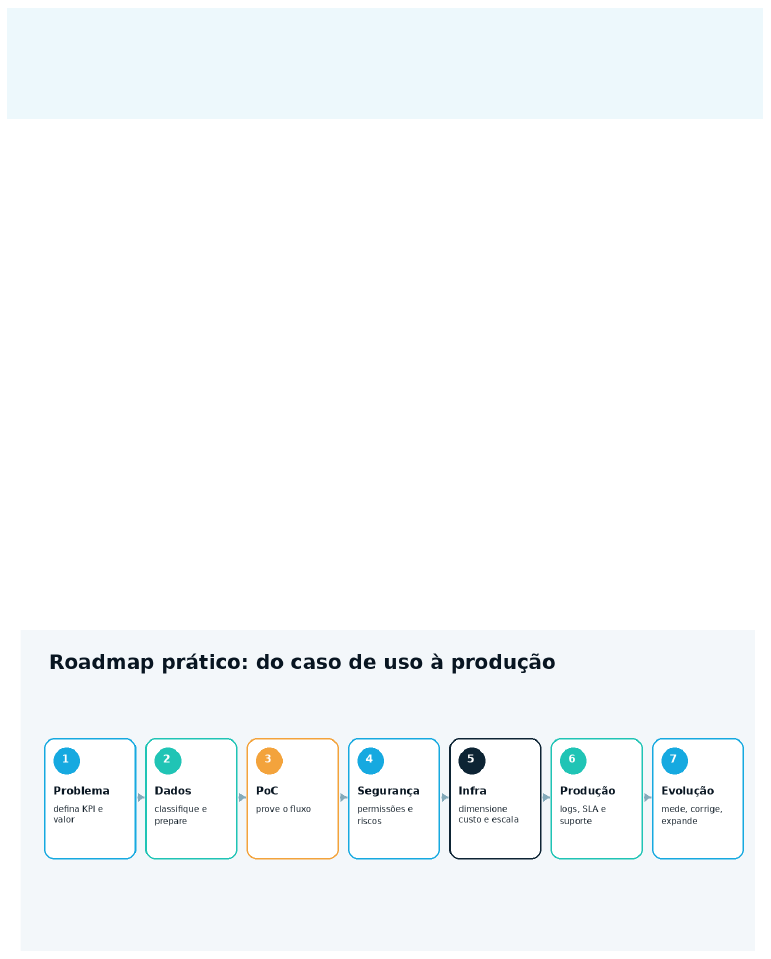
Muitas iniciativas de IA falham não porque o modelo seja incapaz, mas porque o problema foi mal definido. Uma PoC deve existir para testar hipóteses específicas: qualidade mínima, integração, latência, custo, segurança e impacto operacional.
Comece com um processo que tenha dono, dados e métrica. Desenhe uma baseline humana ou do sistema atual. Em seguida, construa um conjunto de testes representativo antes de escolher o fornecedor final. Isso evita medir qualidade apenas por algumas demonstrações impressionantes.
Na passagem para produção, reavalie infraestrutura, governança, suporte, observabilidade e recuperação. Um protótipo em notebook não é uma arquitetura operacional. Para sistemas críticos, defina SLO/SLA, capacidade, contingência, versionamento de prompts/modelos e critérios de rollback.
Checklist antes de escalar um projeto de IA:
- O problema e o KPI estão claros?
- Existe dado suficiente e legalmente utilizável?
- As permissões estão definidas?
- Há um conjunto de testes representativo?
- A solução tem observabilidade?
- O custo por transação é aceitável?
- Existe plano para falhas, indisponibilidade e rollback?
- Um responsável de negócio aprova o resultado?
O cenário de IA em 2026: escala, agentes e infraestrutura
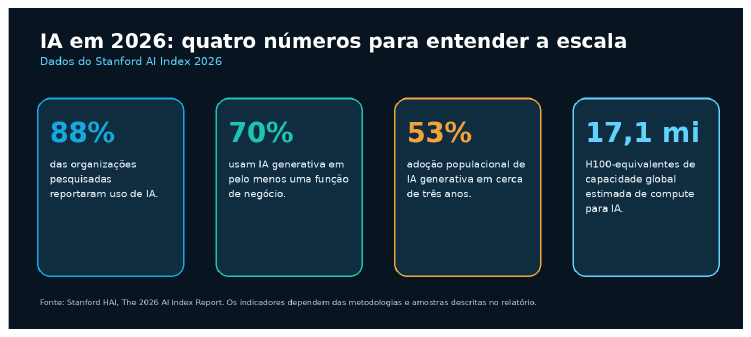
O Stanford AI Index 2026 mostra que a adoção organizacional continua crescendo e que a IA generativa já aparece em funções de negócio de grande parcela das organizações pesquisadas. Ao mesmo tempo, o relatório destaca aumento de investimento, expansão acelerada de capacidade computacional e maior atenção a governança.
Esse cenário sugere uma mudança de maturidade. A primeira fase de IA generativa foi dominada por chats generalistas. A segunda está sendo definida por integração: modelos conectados a dados, ferramentas, sistemas corporativos e infraestrutura otimizada para custo e latência.
Agentes ainda estão em fase inicial em muitas funções de negócio, o que é importante: expectativas devem ser calibradas. Há valor real, mas sistemas autônomos precisam provar confiabilidade. O diferencial competitivo tende a migrar do acesso ao mesmo modelo para a qualidade dos dados, integração, processos, experiência, segurança e operação.
Para empresas de infraestrutura digital, isso cria uma oportunidade direta. A IA aumenta a demanda por capacidade computacional, storage, conectividade, energia, resiliência e serviços gerenciados. Em outras palavras: o crescimento da IA também é um crescimento da infraestrutura necessária para sustentá-la.
Como a EnQ Digital pode apoiar uma jornada de IA
Uma estratégia de IA empresarial precisa conectar aplicação e infraestrutura. A EnQ Digital atua em infraestrutura digital com soluções de Data Center, Cloud Virtual, Bare Metal, storage compatível com S3, conectividade e serviços associados. Isso permite desenhar ambientes para aplicações tradicionais e cargas emergentes de inteligência artificial.
Para um projeto de IA, a discussão pode começar pelo workload: tamanho do modelo, volume de documentos, quantidade de usuários, latência, disponibilidade, privacidade e custo esperado. A partir daí, é possível avaliar uma arquitetura em cloud, bare metal, data center ou híbrida.
O ponto de partida não precisa ser um cluster gigantesco. Muitas empresas geram valor com modelos existentes, RAG e agentes conectados aos seus dados. A infraestrutura deve crescer conforme a demanda e a criticidade do processo.
- Cloud Virtual para aplicações, APIs, bancos e componentes de orquestração.
- Bare Metal dedicado para workloads que pedem desempenho previsível e acesso direto ao hardware.
- Storage S3 para dados, documentos, artefatos, backups e datasets.
- Data Center e colocation para ambientes de missão crítica e expansão de capacidade.
- Conectividade e segurança para integrar usuários, dados e serviços de IA.
Glossário essencial de IA
| Termo | Definição |
|---|---|
| Agente de IA | Sistema que usa um modelo para planejar e executar ações com ferramentas. |
| Algoritmo | Procedimento ou conjunto de regras para resolver um problema. |
| API | Interface usada para sistemas trocarem comandos e dados. |
| Attention | Mecanismo que pondera relações entre diferentes partes de um contexto. |
| Chunk | Trecho em que um documento é dividido para indexação e recuperação. |
| Context window | Quantidade máxima de tokens que um modelo considera em uma interação. |
| Deep Learning | Machine learning baseado em redes neurais profundas. |
| Embedding | Representação vetorial que captura relações semânticas. |
| Fine-tuning | Ajuste adicional de um modelo para comportamento ou domínio específico. |
| GPU | Processador altamente paralelo usado em muitas cargas de IA. |
| Hallucination | Saída plausível, mas incorreta ou sem suporte em fonte confiável. |
| Inference | Uso de um modelo treinado para produzir uma saída nova. |
| LLM | Large Language Model, modelo de linguagem de grande escala. |
| LLMOps | Práticas de operação, avaliação, observabilidade e governança de LLMs. |
| Machine Learning | Métodos em que modelos aprendem padrões a partir de dados. |
| Model serving | Camada que disponibiliza um modelo para receber requisições. |
| Multimodal | Modelo capaz de trabalhar com mais de uma modalidade, como texto e imagem. |
| Prompt | Instrução e contexto enviados a um modelo generativo. |
| Prompt injection | Tentativa de alterar ou desviar instruções do sistema por conteúdo malicioso. |
| Quantization | Redução da precisão numérica para diminuir memória e custo computacional. |
| RAG | Arquitetura que recupera fontes relevantes antes de gerar uma resposta. |
| Reranker | Componente que reorganiza resultados recuperados para melhorar relevância. |
| Reinforcement Learning | Aprendizado por tentativa e erro com recompensas. |
| S3/Object Storage | Armazenamento de objetos útil para documentos, datasets e artefatos. |
| Token | Unidade em que texto é representado para processamento por um modelo. |
| Transformer | Arquitetura baseada em attention, central em muitos modelos modernos. |
| Vector database | Sistema otimizado para armazenar e buscar vetores/embeddings. |
Perguntas frequentes
O que é inteligência artificial?
É o campo que desenvolve sistemas capazes de executar tarefas associadas a percepção, linguagem, aprendizagem, previsão, geração ou decisão. IA é o campo amplo. Machine learning é uma abordagem dentro da IA em que modelos aprendem padrões a partir de dados.
O que é IA generativa?
É a classe de sistemas que cria novo conteúdo, como texto, código, imagem, áudio ou vídeo, com base em padrões aprendidos.
O que é um LLM?
É um grande modelo de linguagem treinado para processar e gerar sequências de linguagem. Muitos assistentes conversacionais atuais usam LLMs.
O que é RAG em inteligência artificial?
RAG é uma arquitetura que busca informações em fontes externas e envia os trechos relevantes ao modelo antes da geração da resposta.
O que são agentes de IA?
São sistemas que combinam modelos com ferramentas, memória e regras para executar tarefas em múltiplas etapas.
Uma empresa precisa treinar seu próprio modelo?
Na maioria dos casos, não. Modelos existentes, combinados com RAG, fine-tuning ou ferramentas, atendem grande parte das necessidades empresariais.
IA precisa de GPU?
Nem sempre. Modelos menores podem rodar em CPU. Modelos grandes, baixa latência e alto volume frequentemente se beneficiam de GPUs ou aceleradores.
Cloud ou bare metal é melhor para IA?
Depende do perfil da carga. Cloud favorece elasticidade; bare metal pode favorecer controle e previsibilidade; arquiteturas híbridas combinam os dois.
Como proteger dados ao usar IA?
Classifique dados, defina provedores e ambientes permitidos, aplique criptografia, controle de acesso, logs, segregação de dados e validação de respostas.
Qual o primeiro projeto de IA para uma empresa?
Comece por um problema repetitivo e mensurável, com dados disponíveis e baixo risco operacional. Defina KPI antes de construir a PoC.
Como medir retorno de um projeto de IA?
Compare a solução com a baseline usando métricas como tempo, custo, conversão, erro, satisfação, MTTR, disponibilidade ou volume processado.
Fontes
- Alan M. Turing, Computing Machinery and Intelligence, Mind, 1950.
- McCarthy, Minsky, Rochester e Shannon, A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence, 1955.
- Krizhevsky, Sutskever e Hinton, ImageNet Classification with Deep Convolutional Neural Networks, NeurIPS 2012.
- Vaswani et al., Attention Is All You Need, 2017.
- Google DeepMind, AlphaGo.
- OpenAI, Introducing ChatGPT, 30 nov. 2022.
- Stanford HAI, The 2026 AI Index Report.
Nota editorial: este material é informativo. Números de mercado e referências refletem as fontes consultadas e devem ser revistos periodicamente, pois o setor de inteligência artificial muda rapidamente.