
Um NVIDIA Vera Rubin NVL72 não é apenas um rack de GPUs de altíssima densidade. Ele é o núcleo de uma AI Factory: uma plataforma que converte grandes volumes de dados e energia elétrica em treinamento de modelos, inferência, raciocínio de IA, simulação científica e resultado de negócio em escala. Este guia percorre a cadeia completa de decisões — do business case ao dimensionamento térmico e hidráulico, seleção de CDU, comissionamento e operação.
O encadeamento é sempre o mesmo: a demanda define a escala; a escala define potência e carga térmica; a carga térmica define vazão, ΔT e ΔP; e o ΔP define a bomba, a CDU e a planta hidráulica. Pular uma etapa transfere incerteza para a obra, onde a correção custa mais e compromete prazo.
Sobre este material: os números aqui são referenciais públicos de plataforma e de pré-projeto. A NVIDIA ainda classifica várias especificações Rubin como preliminares. O Reference Design e o Site Planning Guide da configuração efetivamente adquirida devem prevalecer sobre qualquer cálculo preliminar deste texto.
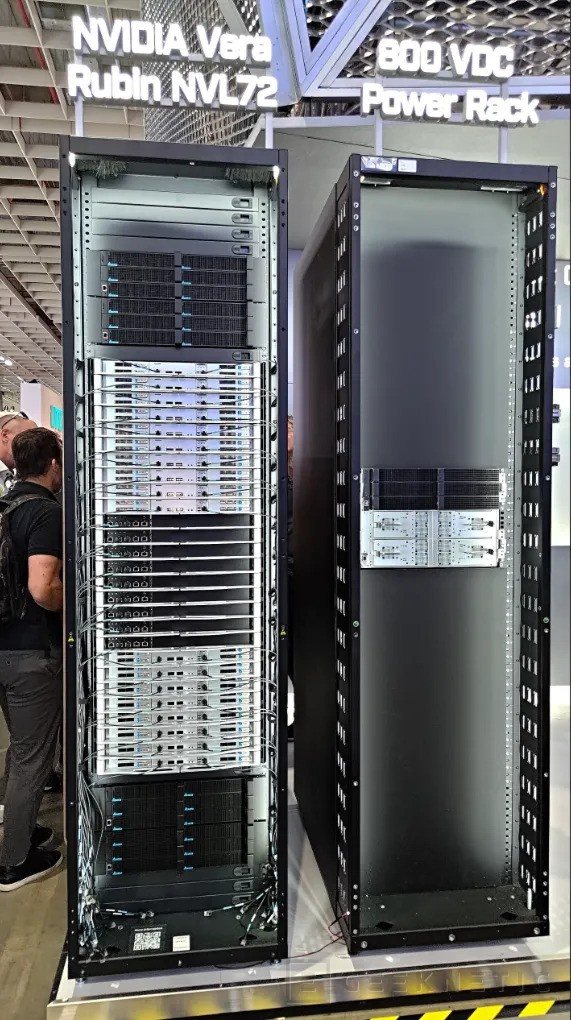
Sumário executivo
Cada parte responde a uma decisão específica. Gestores começam pelas três primeiras linhas; engenharia avança pelas disciplinas técnicas; operação concentra-se em comissionamento, telemetria e indicadores; compras usa as matrizes e o RFI para estruturar cotação, equalização técnica e aceite.
| Parte | Conteúdo | Decisão principal |
|---|---|---|
| Business case | Quando uma AI Factory se justifica | Construir, alugar GPU em cloud ou híbrido? |
| Aplicações | Setores, workloads e objetivos | Que carga vai ocupar o cluster? |
| Cases reais | Blackwell GB200/GB300 em produção | Que modelo econômico já foi validado? |
| Arquitetura | Rubin GPU, Vera CPU, HBM4, NVLink 6 | O que o rack entrega como sistema? |
| Cooling | DLC, FWS, CDU, TCS e 45 °C | Como o calor sai do chip até a atmosfera? |
| Dimensionamento | kW, LPM, m³/h, ΔT, ΔP e Pump Head | Que vazão e que pressão o projeto exige? |
| Seleção de CDU | Critérios, marketplace DSX e fabricantes | Qual CDU atende ao operating point real? |
| Elétrica | Cabinet TDP, kVA e consumo | Quanta potência e energia reservar? |
| Operação | BMS, comissionamento, riscos e RFI | Como provar e sustentar o desempenho? |
Por que construir um supercomputador desta classe
O objetivo central é reduzir drasticamente o tempo para treinar, ajustar e executar modelos e simulações que seriam impraticáveis em infraestrutura convencional — preservando baixa latência entre GPUs, grande memória agregada e alta eficiência por unidade de trabalho. O valor não está apenas nos FLOPS.
- Time-to-solution: reduzir semanas ou meses de treinamento e simulação para dias ou horas.
- Modelos maiores: treinar, ajustar e servir LLMs, modelos multimodais e Mixture-of-Experts com centenas de bilhões ou trilhões de parâmetros.
- Raciocínio em escala: sustentar inferência com long context, agentes e cadeias de raciocínio que consomem muito mais compute que um chatbot tradicional.
- Soberania e privacidade: manter dados, modelos e propriedade intelectual dentro de infraestrutura controlada pela organização ou pelo país.
- Convergência AI + HPC: usar a mesma fábrica para IA, análise massiva de dados, simulação numérica e workloads científicos.
- Economia por token: em cargas grandes e contínuas, desempenho por watt, utilização e velocidade de comunicação determinam o TCO.
- Monetização: provedores de cloud e data centers podem transformar a infraestrutura em GPU-as-a-Service, training-as-a-service e inference-as-a-service.
Quando faz sentido — e quando não faz
Um cluster NVL72 se justifica quando existe demanda sustentada por computação paralela, grandes datasets, forte comunicação GPU-GPU, necessidade de baixa latência, soberania de dados ou volume de inferência suficiente para amortizar a infraestrutura. Para projetos pequenos, experimentais ou com utilização esporádica, cloud pública ou clusters menores tendem a apresentar melhor relação econômica.
| Indicador | Sinal de que uma AI Factory pode fazer sentido |
|---|---|
| Treinamento | Modelos proprietários grandes, treinamento recorrente ou fine-tuning contínuo. |
| Inferência | Bilhões de tokens/dia, baixa latência e agentes executando fluxos complexos. |
| Dados | Petabytes ou datasets estratégicos que não devem sair do domínio controlado. |
| HPC | Simulações altamente paralelas: CFD, FEA, clima, dinâmica molecular ou seismic. |
| Negócio | Capacidade usada continuamente ou revendida como serviço de GPU/IA. |
| Soberania | Requisitos de residência de dados, segurança, compliance ou propriedade intelectual. |
Para quais áreas a plataforma é útil
A mesma infraestrutura atende IA generativa e HPC. O ganho aparece principalmente quando o problema pode ser paralelizado e exige grande largura de banda de memória e comunicação entre aceleradores.
| Área | Workloads típicos | Objetivo |
|---|---|---|
| AI Labs / LLM | Foundation models, MoE, multimodal, reasoning, fine-tuning e RL. | Criar modelos proprietários e reduzir tempo de treinamento. |
| Cloud / Data Center | GPUaaS, bare metal GPU, inference endpoints, clusters dedicados. | Monetizar capacidade e atender clientes de IA/HPC. |
| Bancos e finanças | Fraude, AML, risco, pricing, modelos tabulares, agentes e análise documental. | Processar grandes bases e executar IA privada com baixa latência. |
| Saúde e life sciences | Drug discovery, dinâmica molecular, genômica, protein design e imagem médica. | Reduzir ciclos de pesquisa e testar mais hipóteses. |
| Indústria e engenharia | CFD, FEA, digital twins, generative engineering, robótica e visão industrial. | Diminuir prototipagem física e acelerar otimização. |
| Energia, óleo e gás | Seismic imaging, reservoir simulation, otimização de rede e manutenção preditiva. | Aumentar resolução e reduzir tempo de decisão operacional. |
| Clima e meio ambiente | Weather forecasting, climate modeling e assimilação de dados. | Executar previsões mais rápidas e de maior resolução. |
| Telecom | Planejamento de RF, otimização de rede, IA para NOC e modelos de tráfego. | Automatizar operação e prever congestionamentos e falhas. |
| Governo / Sovereign AI | LLMs nacionais, pesquisa, defesa cibernética e serviços públicos. | Preservar soberania de dados e capacidade estratégica de IA. |
| Cybersecurity | Detecção em larga escala, análise de malware e SOC com agentes. | Correlacionar grandes volumes de telemetria e acelerar resposta. |
| Mídia e conteúdo | Geração de vídeo, imagem, áudio, tradução e renderização neural. | Produzir conteúdo multimodal em grande escala. |
| Pesquisa científica | Física, química, materiais, astronomia, bioinformática e métodos híbridos. | Explorar espaços de solução antes inviáveis por custo computacional. |
Exemplo prático: uma instituição pode usar o mesmo cluster durante o dia para inferência e agentes corporativos e, em janelas planejadas, alocar milhares de GPUs para treinamento, simulação ou processamento científico via Kubernetes/Slurm. O valor vem da utilização compartilhada e da capacidade de orquestrar workloads distintos.
Cases reais com Blackwell B200 e GB200 NVL72
Os sistemas Blackwell anteriores ao Rubin já demonstram como uma AI Factory é utilizada em produção. Esses casos ajudam a entender o tipo de workload e o modelo econômico que o Vera Rubin tende a ampliar.
Nomenclatura: B200 e B300 referem-se às gerações de GPU Blackwell e Blackwell Ultra. GB200 e GB300 combinam Grace CPU + Blackwell GPU no Superchip e, no NVL72, formam o sistema rack-scale com 72 GPUs.
| Case | Sistema | O que demonstra |
|---|---|---|
| CoreWeave | GB200 NVL72 | Em abril de 2025 a NVIDIA anunciou milhares de GPUs Grace Blackwell ativas; Cohere, IBM e Mistral AI passaram a treinar e servir modelos de raciocínio e agentic AI. |
| Oracle / OCI | GB200 NVL72 liquid-cooled | Primeira onda de racks em operação, com milhares de GPUs Blackwell para OCI e DGX Cloud, combinando Quantum InfiniBand e Spectrum-X Ethernet. |
| NeoSpace | GB200 NVL72 via OCI | Case latino-americano: NeoData em ambiente multi-cloud para um dos maiores bancos privados da América Latina, com mais de 60 milhões de clientes. |
| DeepL | GB200 | Treinamento de modelos Mixture-of-Experts de próxima geração, buscando eficiência tanto em treinamento quanto em inferência. |
| Microsoft / OpenAI | GB300 NVL72 | Cluster Azure em grande escala: throughput, latência, memória e rede escalando como um único sistema. |
| Lambda | GB300 NVL72 | AI Factory de mais de 100 MW em Kansas City, planejada com mais de 10.000 GPUs — energia e data center convertidos em capacidade vendável. |
| Together AI / 5C | B200, GB200 e GB300 | AI Factory em Maryland com B200 e nova instalação em Memphis com GB200/GB300 para aplicações AI-native. |
| Global AI | 128 racks GB300 NVL72 | Mais de 9.000 GPUs em Nova York: o rack deixa de ser unidade isolada e vira bloco repetível de uma AI Factory. |
O que esses cases ensinam: o objetivo não é simplesmente possuir GPUs. O valor aparece quando compute, NVLink, rede scale-out, storage, software, energia e cooling são tratados como uma única fábrica capaz de entregar tokens, treinamento, simulações e serviços com previsibilidade operacional.
Por que o Vera Rubin é o próximo passo
Em 2026, a NVIDIA informou que o Vera Rubin NVL72 entrou em ramp de produção, com racks operando em parceiros como CoreWeave, Google Cloud, Microsoft Azure, Oracle Cloud Infrastructure e Nebius. A Microsoft anunciou Rubin para futuros sites Fairwater, enquanto a CoreWeave passou a integrar sistemas Rubin para workloads de treinamento, inferência e agentic AI.
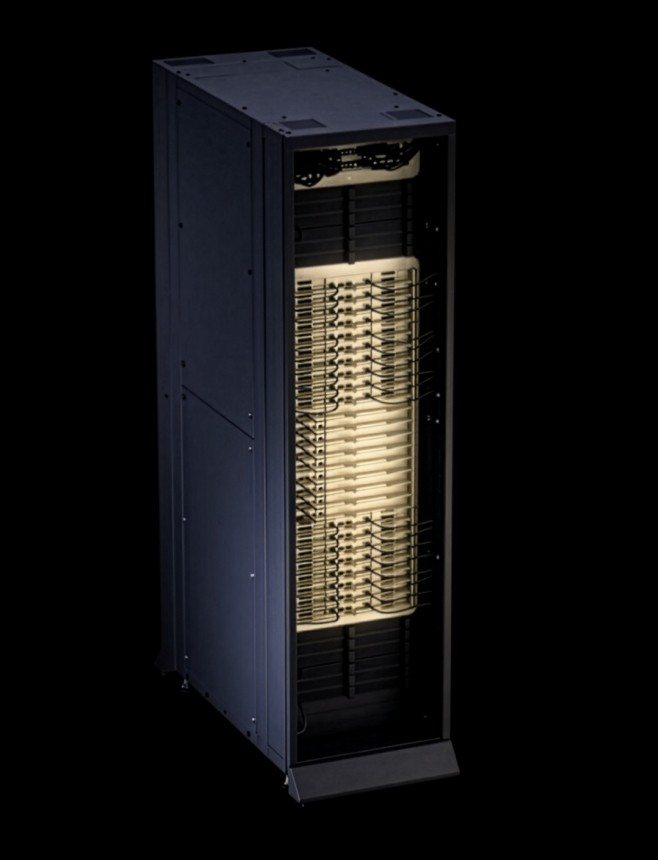
Mensagem executiva: Vera Rubin deve ser entendido como infraestrutura estratégica para AI Factory e HPC — alto CAPEX e alta densidade, mas capaz de concentrar em poucos racks uma capacidade impossível para servidores convencionais.
Arquitetura sistêmica da AI Factory
A Vera Rubin é uma arquitetura de infraestrutura de IA em escala de rack e POD, desenhada para que computação, memória, comunicação, rede, armazenamento, segurança, potência e resfriamento funcionem como um sistema coordenado. Em modelos atuais, desempenho não depende apenas de FLOPS: é preciso movimentar pesos, ativações e KV cache, sincronizar aceleradores, manter baixa latência e entregar mais tokens por watt.
A mudança estratégica é clara: de servidor isolado para domínio de execução em escala de rack; de pico de FLOPS para tokens úteis por watt e por megawatt; de treinamento puro para treinamento, pós-treinamento e inferência agentiva; de interconexão periférica para memória e comunicação como parte do acelerador.
A plataforma reúne Rubin GPU, Vera CPU, NVLink 6 Switch, ConnectX-9 SuperNIC, BlueField-4 DPU e novas famílias de networking e racks especializados — compute, CPU, storage e Ethernet. O NVL72 é o núcleo de compute desse ecossistema.
A GPU Rubin em detalhes
A Rubin GPU é orientada a workloads de raciocínio, geração, recuperação de dados e uso de ferramentas. A combinação de HBM4, Transformer Engine e NVLink 6 busca manter os aceleradores ocupados mesmo em cargas com comunicação intensa e múltiplas etapas de inferência.
| Item | Rubin GPU | Vera Rubin NVL72 |
|---|---|---|
| Transistores | 336 bilhões | — |
| SMs / Tensor Cores | 224 / 896 | 72 GPUs |
| NVFP4 inferência | 50 PFLOPS | 3.600 PFLOPS |
| Memória | 288 GB HBM4 | 20,7 TB HBM4 |
| Largura de banda HBM4 | 22 TB/s | 1.580 TB/s agregado |
| Interconexão | NVLink 6: 3,6 TB/s | 260 TB/s no rack |
Leitura correta: os valores acima são especificações e picos divulgados para a plataforma. Desempenho de aplicação depende de framework, kernel, precisão, modelo, batch, contexto e estratégia de paralelismo.
Memória HBM4 e NVLink 6
Em inferência, especialmente na fase de decode, mover pesos e estado do modelo pode ser tão determinante quanto executar multiplicações. Por isso o Vera Rubin combina capacidade de memória, grande largura de banda e uma malha de comunicação de baixa latência.
- Até 288 GB de HBM4 por GPU Rubin e até 22 TB/s de largura de banda de memória por GPU.
- Mais espaço para pesos, ativações, KV cache e concorrência, com menor necessidade de descarregar estado para camadas mais lentas.
- Até 3,6 TB/s de scale-up por GPU para o domínio NVLink, com comunicação all-to-all entre as GPUs do NVL72.
- NVLink-C2C de alta largura de banda para comunicação coerente CPU-GPU.
- Redução do overhead de sincronização e do tempo perdido em transferência em workloads MoE e distribuídos.
Por que isso importa: modelos Mixture-of-Experts distribuem tokens entre especialistas. Quanto mais tempo o rack gasta transferindo pesos e sincronizando GPUs, menor é a fração de energia convertida em trabalho útil. HBM4 e NVLink 6 atacam diretamente esse gargalo.
Treinamento, inferência e IA agentiva
Um agente não responde apenas a uma pergunta: ele planeja, chama ferramentas, consulta fontes, verifica resultados e pode gerar várias sequências de tokens antes de concluir uma tarefa. Isso aumenta o volume de inferência e torna a latência por etapa crítica.
| Treinamento | Inferência e agentic AI |
|---|---|
| Modelos MoE e foundation models de grande escala. | Serviços interativos com baixa latência. |
| Tensor, pipeline e expert parallelism. | Long-context e grandes KV caches. |
| Alta comunicação para sincronização e roteamento de tokens. | Alta concorrência e batching contínuo. |
| HBM4 para manter parâmetros e estados próximos do compute. | Otimização por tokens/s, tokens/W e custo por milhão de tokens. |
Em cenários específicos a NVIDIA posiciona o Vera Rubin para entregar ganhos expressivos em tokens por megawatt e custo por milhão de tokens frente a gerações anteriores. Trate esses números como referências de plataforma, condicionadas a modelo, software, precisão e configuração.
Rede, armazenamento e segurança
A plataforma não termina na GPU. Para manter 72 aceleradores ocupados, tráfego east-west, acesso ao storage e proteção do workload precisam ser tratados como partes do computador.
- Rede: ConnectX-9 SuperNIC para scale-out de altíssima largura de banda; Quantum-X800 InfiniBand e Spectrum-X Ethernet para clusters multi-rack; RDMA e caminhos de baixa latência; arquiteturas spine-leaf e ópticas de alta densidade dimensionadas junto ao compute.
- Armazenamento contextual: a arquitetura BlueField-4/STX amplia o papel do storage para além de repositório de arquivos, aproximando camadas de contexto e KV cache do domínio de execução — combinado, em projetos reais, com NVMe, parallel file systems, object storage e políticas de tiering.
- Segurança: BlueField-4 para processamento de rede, offload e políticas; Confidential Computing e proteção de dados em uso, trânsito e repouso conforme suporte da plataforma; isolamento de tenants em cloud e GPUaaS; secure boot, firmware assinado, observabilidade e RAS em escala de rack.
Vera Rubin versus Blackwell
A comparação deve ser feita no nível de sistema. Rubin não é apenas uma atualização de GPU: altera a forma como o data center entrega computação para IA, com novas exigências de memória, rede, potência e refrigeração.
| Critério | Blackwell / GB200 | Vera Rubin / NVL72 |
|---|---|---|
| Foco | Treinamento e inferência em escala | IA agentiva, long-context e eficiência |
| Memória | HBM3e, conforme modelo | HBM4, até 288 GB/GPU |
| Interconexão | NVLink 5 | NVLink 6 |
| Rack de referência | GB200 NVL72 | Vera Rubin NVL72 |
| Resfriamento | Direct liquid cooling | Direct liquid cooling, rack integrado |
| Economia | Alto throughput | Foco em tokens por watt e por MW |
Visão técnica do rack
O NVIDIA Vera Rubin NVL72 é um sistema rack-scale da terceira geração MGX. O rack integra 72 GPUs Rubin e 36 CPUs Vera, interligadas por NVLink 6, com networking ConnectX-9 e BlueField-4. O objetivo é fazer o rack operar como um grande acelerador único dentro da AI Factory.
| Parâmetro | Referência |
|---|---|
| GPUs | 72 × NVIDIA Rubin |
| CPUs | 36 × NVIDIA Vera |
| HBM4 total | 20,7 TB |
| Bandwidth HBM4 | até 1.580 TB/s |
| CPU memory | 54 TB LPDDR5X |
| Memória rápida total DGX | 75 TB |
| NVLink | 6ª geração |
| NVLink switch system | 9 × L1 NVLink Switch Units |
| Scale-out | ConnectX-9 / BlueField-4 |
| Cabinet TDP de facilities | até 330 kW — referência DSX |
Estrutura física: 18 compute trays e 9 NVLink 6 switch trays. Cada compute tray integra 2 Vera Rubin Superchips, totalizando 4 GPUs Rubin e 2 CPUs Vera. O design do tray é modular, cable-free, hose-free e fanless, com manifold interno redesenhado. O rack MGX de terceira geração usa rack manifolds UQD08 e busbars refrigerados a líquido para correntes elevadas.
Especificação de cada compute tray
O compute tray é a unidade de serviço e de cálculo repetida 18 vezes no rack. Cada tray concentra compute, networking, cooling, gerenciamento e power delivery.
| Item | Por compute tray |
|---|---|
| Vera Rubin Superchips | 2 |
| Rubin GPUs | 4 |
| Vera CPUs | 2 |
| HBM4 total | 1.152 GB (4 × 288 GB) |
| HBM4 bandwidth | 88 TB/s agregado |
| CPU cores | 176 Olympus cores |
| CPU memory | até 3 TB LPDDR5X |
| NVFP4 inference | 200 PFLOPS por tray |
| NVLink 6 | 14,4 TB/s agregado |
| Networking | ConnectX-9 + BlueField-4 |
| Cooling | Direct Liquid Cooling, tray fanless |
Atenção à potência por lâmina: a documentação pública detalha capacidade e arquitetura do tray, mas o Max Power/TDP elétrico definitivo por compute tray deve ser obtido no Site Planning/Reference Design final. Não derive o circuito elétrico apenas dividindo 330 kW por 18.
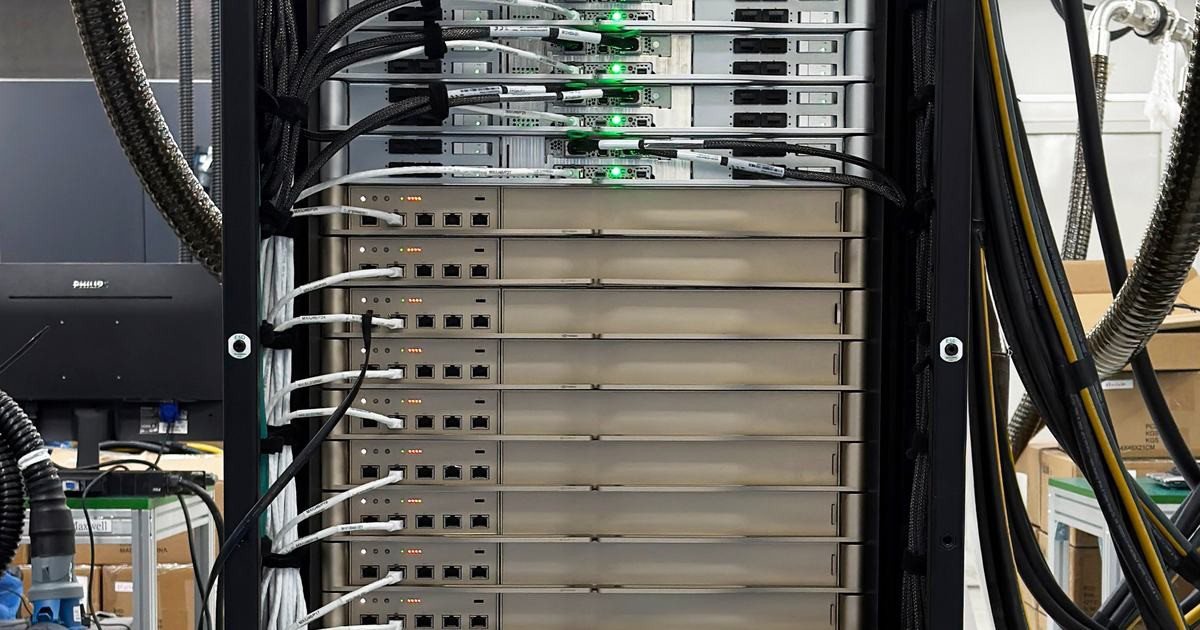
Sumário executivo de facilities
O Vera Rubin NVL72 representa uma mudança de escala no projeto de infraestrutura física para IA. Para facilities, a referência NVIDIA DSX evolui para um Cabinet TDP de até 330 kW por rack e para uma estratégia de refrigeração líquida de alta temperatura.
| Parâmetro-base para pré-projeto | Valor de referência |
|---|---|
| Cabinet TDP DSX | 330 kW por rack |
| TCS design flow | ≥ 1,5 LPM/kW |
| Vazão de referência por rack | ≥ 495 LPM (29,7 m³/h) |
| Tipo de CDU | Liquid-to-liquid |
| Redundância de CDU | N+1 |
| Cooling design point | 45 °C |
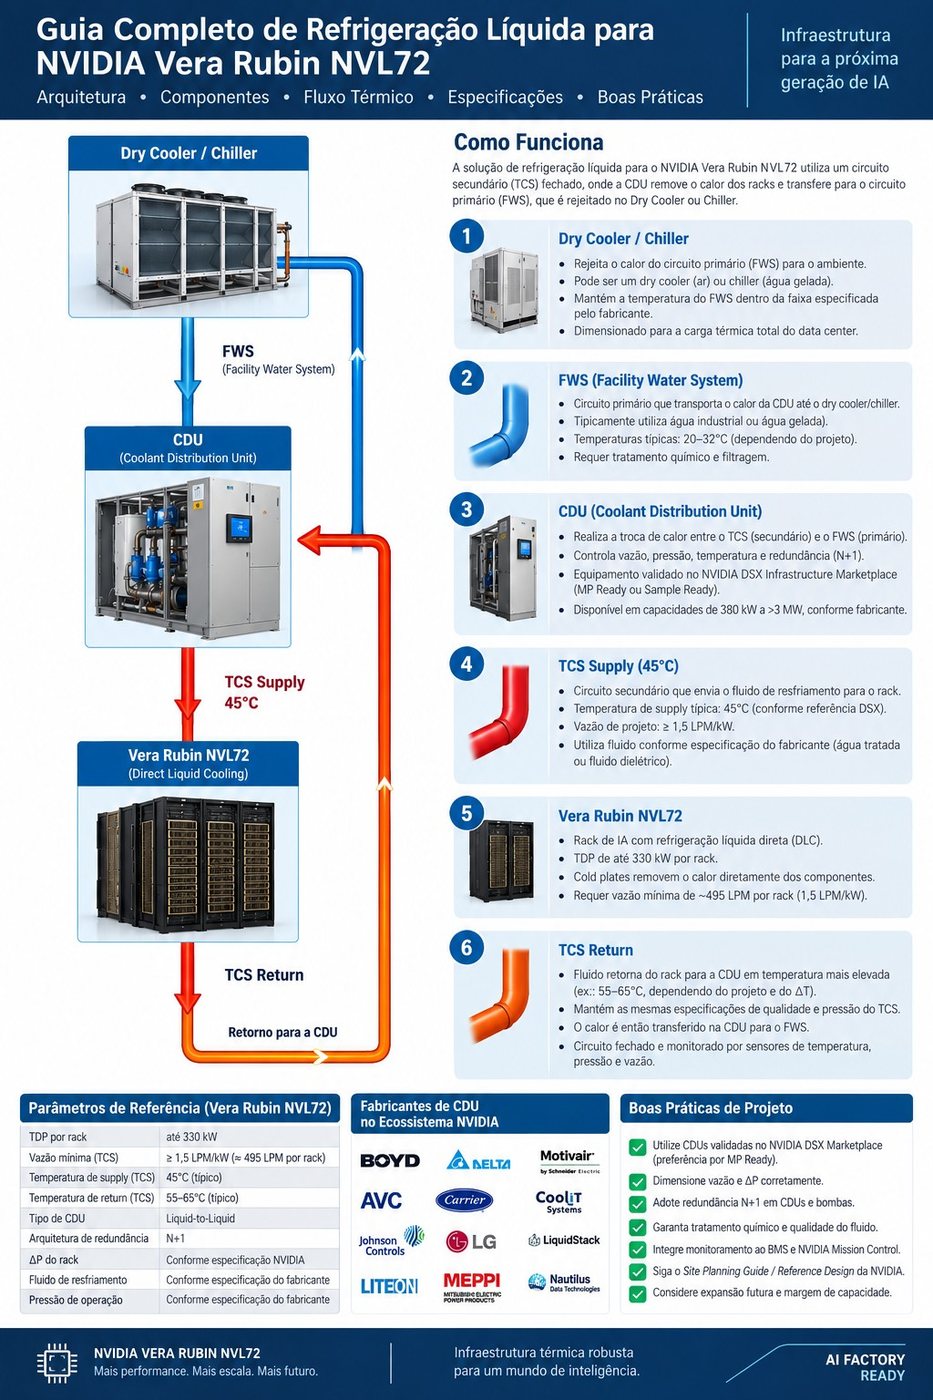
Arquitetura DLC: FWS, CDU, TCS e rack
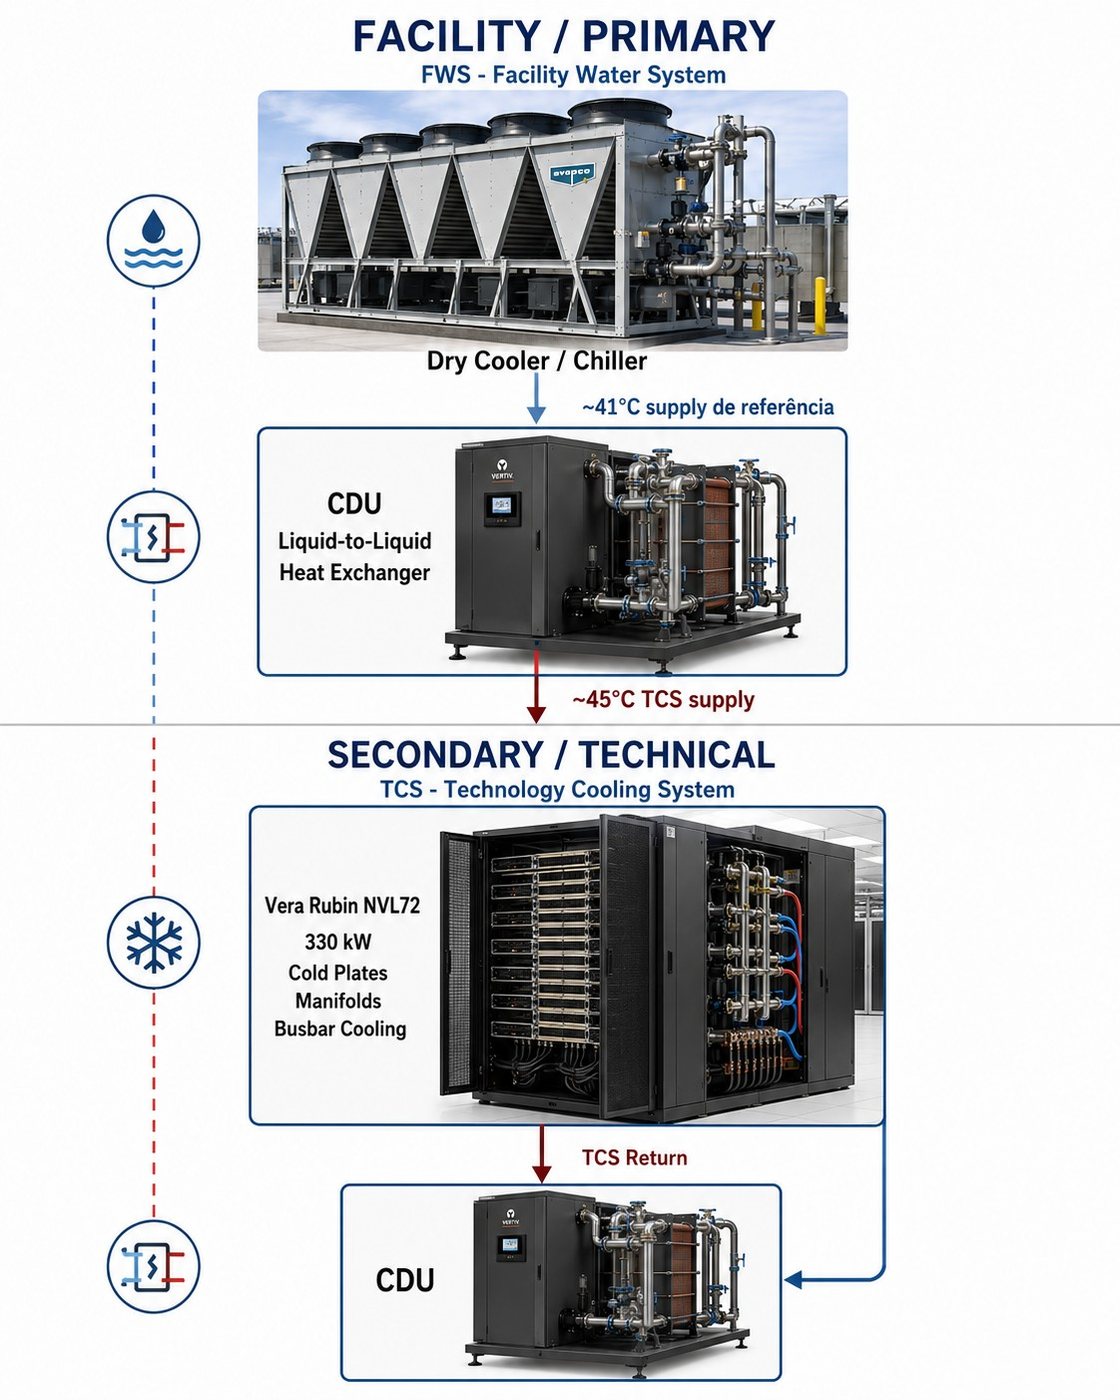
A solução usa dois circuitos hidráulicos separados por um trocador de calor. Entender essa separação é o que evita os erros mais caros do projeto.
O que são FWS, CDU e TCS
FWS — Facility Water System. É o circuito primário do data center. Transporta calor entre as CDUs e a planta de rejeição térmica — normalmente chillers, dry coolers, bombas e trocadores da Central Utility Building. O FWS não deve ser confundido com o fluido técnico que circula dentro dos racks. Utiliza tipicamente água industrial ou água gelada, com temperaturas na faixa de 20–32 °C dependendo do projeto, e requer tratamento químico e filtragem.
CDU — Coolant Distribution Unit. É a interface térmica e hidráulica entre o FWS e o TCS. Em uma CDU liquid-to-liquid, um heat exchanger mantém os dois circuitos separados. A CDU controla temperatura, vazão, pressão e differential pressure, e normalmente inclui bombas redundantes, filtragem, sensores, controles e integração ao BMS. Está disponível em capacidades de 380 kW a mais de 3 MW conforme fabricante.
TCS — Technology Cooling System. É o circuito secundário, de qualidade técnica, que sai da CDU e alimenta diretamente os manifolds e cold plates do equipamento de TI. Para o projeto Vera Rubin, o TCS precisa ser dimensionado pelo operating point térmico e hidráulico do rack, e não apenas pela capacidade nominal em kW da CDU.
Regra prática: FWS = água da instalação | CDU = separação e controle | TCS = fluido técnico que chega ao rack | DLC = remoção de calor diretamente no chip.
45 °C de cooling: por que isso muda o data center
A NVIDIA descreve os racks MGX como projetados para operar com warm-water inlet de 45 °C. Em um cenário de referência, água de facility na ordem de 41 °C alimenta a CDU, que fornece aproximadamente 45 °C ao rack. O objetivo é ampliar a janela de rejeição de calor sem depender continuamente de compressão mecânica.
- Maior possibilidade de dry cooling e free cooling em vários climas.
- Menor consumo de compressores e potencial redução de PUE.
- Mais do orçamento elétrico do site pode ser direcionado ao compute.
- A arquitetura liquid-to-liquid permite separar a qualidade do fluido de TI da água do facility.
- 45 °C é um design point: temperaturas, approach e limites finais devem vir do projeto contratado.
Não confundir: 45 °C de TCS supply não significa que o Facility Water obrigatoriamente entra na CDU a 45 °C. A CDU precisa de uma diferença térmica (approach) e o design FWS/TCS deve ser verificado pelo fabricante.
Dimensionamento térmico e hidráulico
O DSX informa que o Cabinet TDP escala até 330 kW para o Vera Rubin NVL72. Para pré-projeto de cooling, esse é o valor de referência mais consistente para dimensionar heat rejection, CDU e distribuição, até que o Site Planning final indique valores específicos de MaxP/MaxQ. O DSX define ainda um TCS design flow de pelo menos 1,5 LPM/kW.
Cálculo por rack: 330 kW × 1,5 LPM/kW = 495 LPM = 29,7 m³/h por Vera Rubin NVL72.
| Racks | Carga térmica | TCS mínimo | Vazão |
|---|---|---|---|
| 1 | 330 kW | 495 LPM | 29,7 m³/h |
| 2 | 660 kW | 990 LPM | 59,4 m³/h |
| 4 | 1,32 MW | 1.980 LPM | 118,8 m³/h |
| 8 | 2,64 MW | 3.960 LPM | 237,6 m³/h |
| 16 | 5,28 MW | 7.920 LPM | 475,2 m³/h |
ΔT: transformando kW e vazão em temperaturas
O balanço térmico de um circuito de água pode ser aproximado por Q = ṁ × Cp × ΔT. Em água, 495 LPM equivalem a aproximadamente 8,25 kg/s. Para 330 kW, o ΔT teórico é da ordem de 9,6 °C.
Exemplo didático: se o TCS entrar a 45 °C e remover 330 kW a cerca de 495 LPM com propriedades próximas às da água, o retorno teórico ficaria próximo de 54–55 °C. Esse valor é apenas indicativo; o coolant e as temperaturas finais devem seguir o OEM e a CDU.
- Maior ΔT pode reduzir a vazão exigida para a mesma carga, mas deve respeitar os limites do rack.
- Maior concentração de glicol altera densidade, viscosidade e capacidade térmica.
- A capacidade publicada de uma CDU depende do approach temperature e do operating point.
- Use as curvas do fabricante, não apenas a potência nominal de catálogo.
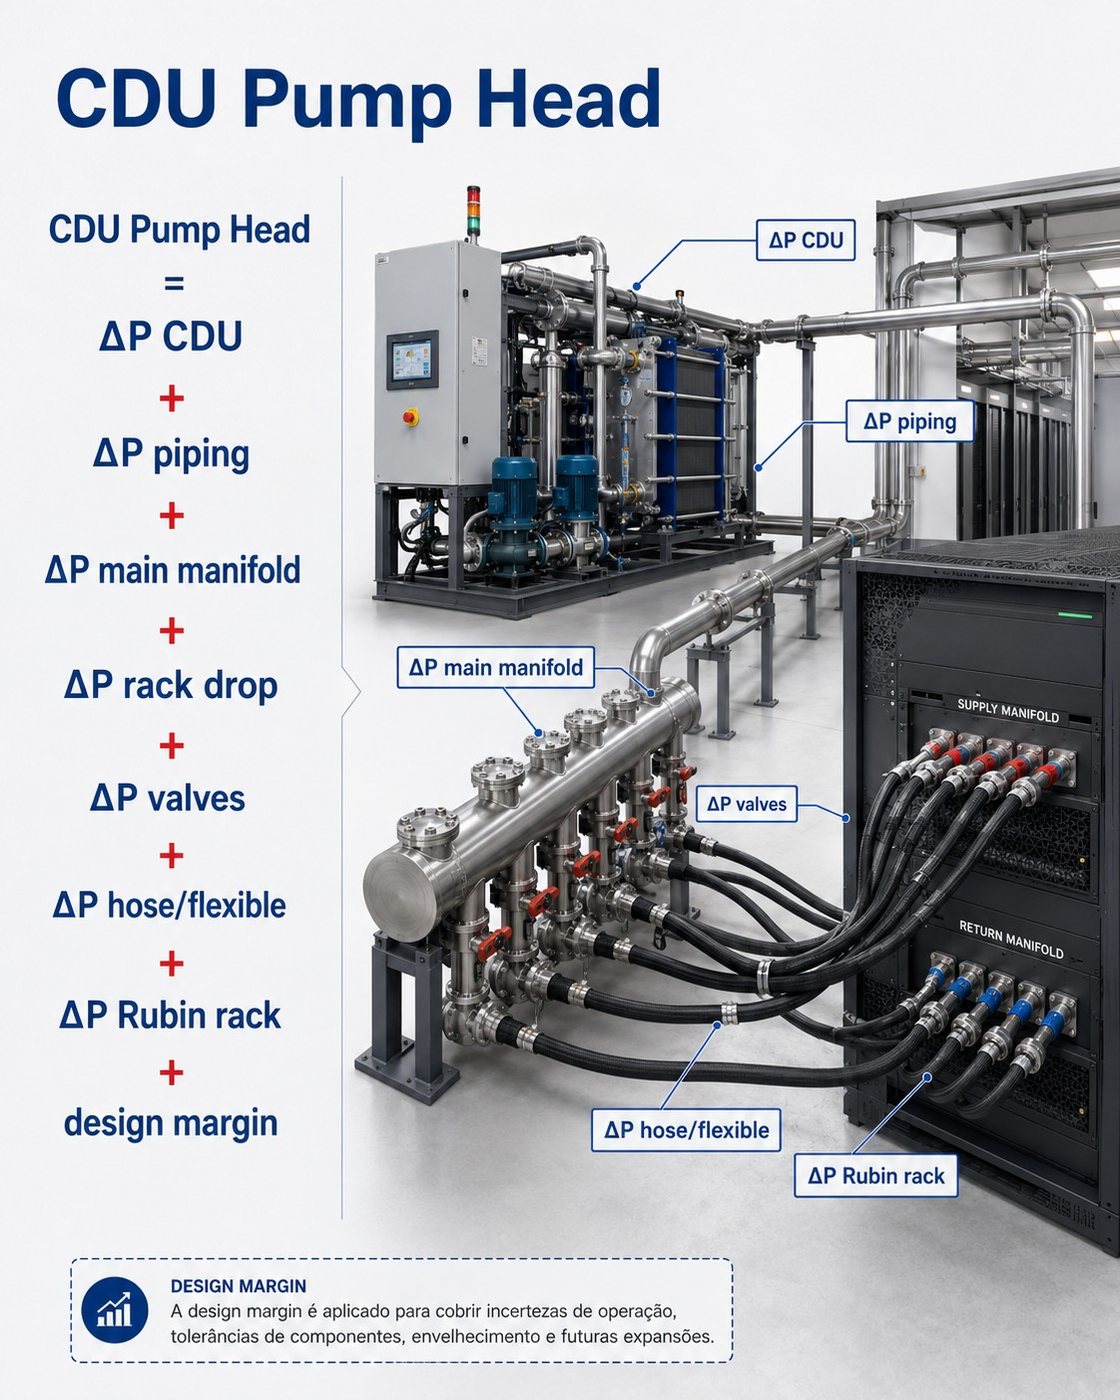
Como interpretar ΔP e o Pump Head
ΔP lê-se "Delta P" e significa diferença de pressão. Em um circuito hidráulico, representa a perda de pressão entre dois pontos. Se o rack recebe 3,0 bar e retorna 2,2 bar, o ΔP do rack é 0,8 bar.
Pump Head total: ΔP CDU + ΔP piping + ΔP main manifold + ΔP rack drop + ΔP valves + ΔP hose/flexible + ΔP Rubin rack + design margin.
A bomba da CDU deve fornecer vazão suficiente no Pump Head requerido. Uma CDU de muitos megawatts pode não atender ao projeto se sua curva de bomba não entregar a vazão necessária no ΔP real do circuito.
- Obter do OEM o ΔP do rack na vazão nominal e na máxima.
- Calcular perdas de carga dos headers de supply e return.
- Somar válvulas, filtros, conexões, flexíveis, manifolds e acessórios.
- Aplicar margem coerente para tolerâncias, envelhecimento, fouling e expansão.
- Verificar NPSH, cavitação e operação das bombas em paralelo quando aplicável.
Manifolds, cold plates e interface do rack
Na terceira geração MGX, a NVIDIA descreve novos manifolds internos de tray, rack manifolds UQD08 e busbars refrigerados a líquido capazes de suportar correntes muito elevadas. O compute tray foi redesenhado para um conjunto cable-free, hose-free e fanless.
- O supply manifold distribui o coolant pelos trays; o return manifold coleta o fluido aquecido.
- Universal Quick Disconnects (UQD08) facilitam conexão e manutenção.
- Cold plates transferem calor diretamente de GPU, CPU e demais componentes ao fluido.
- A interface externa do rack — diâmetro, padrão de conexão, working pressure e posição — deve vir do desenho mecânico do OEM.
Informação obrigatória para o projeto: não assuma que o conector interno UQD08 é o mesmo conector externo do rack. Solicite o Rack Supply/Return Interface Drawing com quantidade de conexões, diâmetro, tipo, altura, orientação, pressão e requisitos de isolamento.
Como selecionar a CDU
A seleção não deve ser feita apenas por "MW da CDU". É necessário validar simultaneamente capacidade térmica, vazão, pressão disponível, approach, fluido, materiais, redundância, alimentação e controles.
| Critério | O que validar |
|---|---|
| Capacidade térmica | ≥ carga dos racks no operating point e ATD definidos |
| Vazão secundária | ≥ 1,5 LPM/kW como referência DSX |
| Pump Head | Suficiente para o ΔP total calculado |
| Tipo | Liquid-to-liquid na referência DSX |
| Redundância | N+1 em grupos de CDU |
| Bombas | Redundância, failover e curva validada |
| Fluido e materiais | Compatibilidade química e wetted materials |
| Filtragem | Rating compatível com o OEM |
| Controles | Constant flow ou constant ΔP conforme estratégia |
| Integração | BMS, DSX Exchange e Mission Control |
| Manutenção | Isolamento, bypass e troca sem impacto indevido |
Exemplo: para 1 rack são 330 kW e ≥ 495 LPM. Uma CDU nominal de 380 kW / 600 LPM pode parecer suficiente, mas a decisão só é válida se ela entregar esses valores no ΔP e no approach reais do projeto.
DSX Marketplace: MP Ready x Sample Ready
O NVIDIA DSX Infrastructure Marketplace publica CDUs submetidas à CDU Self-Qualification Suite e indica o status da cadeia de fornecimento. MP Ready não é sinônimo isolado de homologação: é um indicador de prontidão para produção em massa, enquanto a coluna Validation Type mostra os testes técnicos realizados.
| Status | Significado prático |
|---|---|
| MP Ready | Mass Production Ready: produto em estágio de fornecimento em escala. |
| Sample Ready | Produto disponível em estágio de amostra/qualificação, ainda sem o mesmo status de produção em massa. |
| Validation Type | Lista os ensaios realizados: hydraulic constant flow/DP, thermal capacity, pump failover, flow accuracy, group control e outros. |
Os ensaios publicados incluem Hydraulic Test (Constant Flow e Constant DP), Pumping Capacity, Thermal Test (Nominal Capacity e Low Load), Flow Sensor Accuracy, Cold Start Test, Pump Failover, Group Control e Wetted Materials Compatibility.
Fabricantes de CDU no ecossistema DSX
A lista pública é dinâmica. Os valores abaixo refletem a consulta de 04/09/2026 e devem ser reconfirmados antes da compra.
| Fabricante | Modelo | Capacidade @ 4 °C ATD | Flow @ 35 psi | Status |
|---|---|---|---|---|
| AVC | CDU1000-LTL-RW | 1,2 MW | 1.600 LPM | Sample Ready |
| Boyd | ROL2300 | 1,1 MW | 2.600 LPM | MP Ready |
| Carrier | 65LL | 1,2 MW | 2.500 LPM | Sample Ready |
| CoolIT | CHx1500 | 1,5 MW | 1.950 LPM | — |
| Delta | RDF106CDT5192 | 1,0 MW | 1.500 LPM | MP Ready |
| Delta | CDU3000 | 2,0 MW | 3.200 LPM | — |
| Johnson Controls | SACDU-1050 | 1,0 MW | — | — |
| LG Electronics | LGE | 600 kW | 850 LPM | — |
| LiquidStack | L2L CDU800 | 800 kW | 1.200 LPM | — |
| LiquidStack | D1PM20 | 2,5 MW | 3.750 LPM | — |
| LITEON | LC-LL-WCDU-6011(S) | 380 kW | 600 LPM | Sample Ready |
| MEPPI | ME-CDU 1200 | 1,25 MW | — | — |
| Motivair | MCDU50 | 1,7 MW | 1.136 LPM | MP Ready |
| Motivair | MCDU55 | 1,3 MW | 1.616 LPM | Sample Ready |
| Nautilus | EcoCore FCD | 3,6 MW | 3.300 LPM | — |
Estratégia de aquisição no Brasil
Para implantação no Brasil, é recomendável separar três critérios: presença local do fabricante, disponibilidade do modelo exato e status de validação do modelo no ecossistema NVIDIA. Uma empresa pode ter operação brasileira sem manter em estoque local a CDU específica do projeto Rubin.
| Fabricante / ecossistema | Evidência pública no Brasil | Observação |
|---|---|---|
| Schneider Electric / Motivair | Portfólio brasileiro de liquid cooling e CDUs | Publica CDUs Motivair e serviços locais; validar o modelo DSX específico. |
| Delta Electronics | GoCool LTL no site brasileiro | GoCool-1000/1200/1500/3000; validar equivalência e status do modelo exato no DSX. |
| Johnson Controls / Silent-Aire | Página brasileira de data centers e liquid cooling | Boa presença de serviços; validar SACDU, modelo e lead time. |
| Carrier | Presença regional/global e CDU 65LL | Confirmar disponibilidade local e status de supply chain. |
| LG | Operação local | Confirmar modelo de CDU, suporte e BOM para Rubin. |
Recomendação de compra: emitir RFI/RFQ para pelo menos três fornecedores e exigir curva de bomba, thermal map por ATD, materiais molhados, qualidade do coolant, redundância, integração BMS, FAT/SAT, peças de reposição e compromisso de suporte no Brasil.
Potência elétrica, kVA e consumo
O DSX publica 330 kW como Cabinet TDP. Para aproximação de infraestrutura elétrica, kVA = kW / fator de potência. O dimensionamento final, porém, deve usar o electrical site planning e os limites de alimentação do rack, não apenas o TDP térmico.
| Fator de potência | Cálculo | Equivalência |
|---|---|---|
| PF 0,95 | 330 kW / 0,95 | 347,4 kVA |
| PF 0,98 | 330 kW / 0,98 | 336,7 kVA |
| PF 0,99 | 330 kW / 0,99 | 333,3 kVA |
A NVIDIA não publica um consumo médio universal do Rubin. Treinamento, inferência, comunicação e perfis MaxP/MaxQ produzem cargas diferentes. Use cenários de utilização somente para orçamento de energia, nunca para reduzir a capacidade física instalada.
| Cenário | Potência média | Energia em 730 h |
|---|---|---|
| 50% do envelope | 165 kW | 120,5 MWh/mês |
| 70% | 231 kW | 168,6 MWh/mês |
| 80% | 264 kW | 192,7 MWh/mês |
| 90% | 297 kW | 216,8 MWh/mês |
| 100% | 330 kW | 240,9 MWh/mês |
Requisitos integrados para o data center
| Domínio | Pontos a validar |
|---|---|
| Espaço | U ocupado, peso, acesso, rota de movimentação, piso e área de manutenção. |
| Energia | kW/kVA por rack, arquitetura A/B, UPS, PDU, proteção, aterramento, harmônicas e expansão. |
| Térmico | CDU, vazão, ΔP, supply/return, temperatura, qualidade do fluido e leak detection. |
| Rede | InfiniBand/Ethernet, fibra, transceptores, latência, cabeamento e spine-leaf. |
| Storage | NVMe, parallel file system, object storage, throughput e metadata. |
| Operação | NOC, DCIM/BMS, telemetria, spare parts, treinamento, RMA e procedimentos de emergência. |
Checklist de recebimento: confirmar modelo e revisão; obter desenho dimensional e de peso; solicitar Max-P/TDP, vazão nominal, mínima e máxima e ΔP; validar supply/return e CDU; executar FAT/SAT, teste hidráulico, teste de carga e validação de rede.
BMS, Mission Control e observabilidade
O cooling de uma AI Factory precisa ser observável em tempo real. A documentação DSX publica um catálogo de pontos para integração entre BMS e o ecossistema NVIDIA/DSX Exchange.
| Ponto | Uso operacional |
|---|---|
| CDULiquidSupplyTemperature | Temperatura de TCS supply |
| CDULiquidReturnTemperature | Temperatura de TCS return |
| CDULiquidDifferentialPressure | ΔP do circuito secundário |
| CDULiquidFlow | Vazão em LPM |
| CDULiquidSystemPressure | Pressão do sistema e do return |
| Leak detection / alarms | Eventos de vazamento e anormalidade |
| CDU availability/status | Disponibilidade e estado operacional |
- Alarmes por temperatura, vazão, ΔP e pressão fora da faixa.
- Trend histórico para detectar fouling, filtro saturado e degradação de bomba.
- Interlock e lógica de isolamento conforme matriz de causa e efeito.
- Integração dos eventos de facility com Mission Control/DSX para operação coordenada de power e cooling.
RFI técnico: 12 informações obrigatórias
Antes do projeto executivo, estas doze informações precisam sair do fabricante ou do representante — não de estimativa.
| # | Informação | Por que é indispensável |
|---|---|---|
| 1 | Quantidade exata de Vera Rubin NVL72 | Define escala total, potência, cooling, vazão, CDU, redundância e expansão. |
| 2 | Max-P/TDP confirmado por rack | Base para energia e carga térmica, no perfil operacional contratado. |
| 3 | TCS design flow por rack | Vazão nominal para remover a carga e dimensionar bombas, headers e CDU. |
| 4 | TCS minimum/maximum flow | Limites operacionais contra subfluxo, excesso de vazão e operação fora do envelope. |
| 5 | TCS supply/return temperatures | Determina ΔT, approach da CDU, eficiência térmica e capacidade de rejeição. |
| 6 | ΔP do rack na vazão nominal e máxima | Necessário para calcular Pump Head e selecionar bombas e válvulas. |
| 7 | Working pressure e maximum allowable pressure | Define limites de segurança do circuito, hoses, válvulas e conexões. |
| 8 | Coolant / water-quality specification | Especifica fluido, química, pH, condutividade, filtragem e materiais compatíveis. |
| 9 | Rack Supply/Return connection type e dimensions | Define diâmetro, tipo, posição, quantidade e padrão das interfaces hidráulicas. |
| 10 | CDU approved/validated models | Alinha a seleção ao DSX Marketplace e à configuração OEM. |
| 11 | BMS/Mission Control telemetry requirements | Define sensores, protocolos, alarmes e pontos de integração IT/OT. |
| 12 | Site Planning Guide / Reference Design final | Documento de autoridade para validar o projeto executivo antes da implantação. |
Pacote mínimo esperado na resposta: tabela preenchida com valores nominais, mínimos e máximos e respectivas unidades; curvas hidráulicas do rack e da CDU nos operating points relevantes; desenhos mecânicos das interfaces supply/return; especificação química do coolant e materiais molhados; lista de alarmes, sensores, protocolos e pontos de integração BMS/DSX; e documentos finais de Site Planning, FAT/SAT e critérios de aceite.
Exemplo de pré-dimensionamento com 8 racks
Este exemplo serve apenas para sizing inicial. O projeto executivo deve fechar ΔP, curvas das bombas, topologia hidráulica, diversificação, redundância, expansão e envelope elétrico.
| Parâmetro | Valor de pré-projeto |
|---|---|
| Racks Vera Rubin | 8 |
| GPUs Rubin | 576 |
| CPUs Vera | 288 |
| Cabinet TDP agregado | 2,64 MW |
| TCS design flow mínimo | 3.960 LPM |
| Vazão equivalente | 237,6 m³/h |
| Cooling architecture | Liquid-to-liquid CDU group |
| CDU redundancy | N+1 |
| TCS supply design point | Classe 45 °C |
| BMS | Supply/return temp, flow, ΔP, pressure, alarms |
Seleção da CDU: não use apenas 2,64 MW dividido pela capacidade nominal. Verifique também se o grupo de CDUs entrega ≥ 3.960 LPM no Pump Head total e no approach térmico do projeto, mantendo N+1. Para clusters maiores, a distribuição deve ser concebida como planta hidráulica de alta capacidade, com headers principais, isolamento por rack e ramal, balanceamento, instrumentação e estratégia de manutenção concorrente.
Comissionamento e testes
Um sistema DLC de alta densidade precisa ser comissionado como infraestrutura de missão crítica. O FAT da CDU e o SAT do sistema devem validar não só a potência térmica, mas o comportamento hidráulico e de controle.
- Flushing e limpeza das tubulações antes da conexão ao rack.
- Análise química do coolant e verificação de materiais compatíveis.
- Teste hidrostático conforme pressão admissível e procedimento do fabricante.
- Verificação de vazão por ramal e balanceamento dos racks.
- Teste de ΔP em carga nominal e máxima.
- Teste de pump failover e perda de alimentação A/B.
- Teste de válvulas de isolamento e bypass.
- Leak detection e causa/efeito no BMS.
- Validação de sensores de temperatura, pressão e vazão.
- Teste de perda do FWS, recuperação e sequência de restart.
- Teste de operação N+1 com uma CDU indisponível.
- Registro de baseline para operação e manutenção preditiva.
Critério de aceite: a entrega deve incluir curvas as-built, parâmetros de controle, setpoints, matriz de alarmes, water-quality baseline, lista de peças críticas e procedimento de resposta a vazamentos.
Principais riscos de projeto
| Risco | Impacto |
|---|---|
| CDU escolhida apenas por MW | Pode faltar vazão ou Pump Head no operating point real. |
| ΔP do rack desconhecido | Impossibilita dimensionar corretamente as bombas. |
| Conector do rack assumido | Pode gerar incompatibilidade mecânica e retrabalho. |
| Water quality indefinida | Risco de corrosão, fouling e falha de cold plates. |
| Sem N+1 real | Manutenção ou falha de CDU pode afetar múltiplos racks. |
| Sem isolamento por rack | Aumenta o blast radius de manutenção e vazamento. |
| Sem BMS/telemetria adequada | Perda de detecção precoce de degradação. |
| Usar consumo médio para sizing | Cria risco de insuficiência em MaxP. |
| Ignorar ATD/approach | A capacidade nominal da CDU pode não existir nas temperaturas do projeto. |
| Não validar disponibilidade local | Risco de lead time, spare parts e suporte insuficiente no Brasil. |
Glossário rápido
| Termo | Definição |
|---|---|
| DLC | Direct Liquid Cooling — refrigeração direta por líquido. |
| FWS | Facility Water System — circuito primário da instalação. |
| TCS | Technology Cooling System — circuito secundário que atende o equipamento de TI. |
| CDU | Coolant Distribution Unit — interface FWS/TCS com trocador, bombas e controles. |
| ΔP | Delta P — diferença ou perda de pressão entre dois pontos. |
| ΔT | Delta T — diferença de temperatura entre supply e return. |
| Pump Head | Pressão ou altura manométrica que a bomba precisa fornecer para vencer as perdas do circuito. |
| Cold plate | Trocador em contato térmico com chip ou componente. |
| Manifold | Coletor e distribuidor de supply e return. |
| UQD08 | Universal Quick Disconnect usado na arquitetura MGX de terceira geração. |
| ATD | Approach Temperature Difference do heat exchanger ou da CDU. |
| MP Ready | Mass Production Ready — status de supply chain no NVIDIA DSX Marketplace. |
| Sample Ready | Estágio de amostra e qualificação no Marketplace. |
| BMS | Building Management System. |
| DSX | Arquitetura e ecossistema NVIDIA para AI Factory, incluindo facilities, hardware e IT/OT. |
Documentos que devem ser solicitados
- NVIDIA Vera Rubin NVL72 Reference Design — NVOnline #1151654.
- NVIDIA DSX — Vera Rubin Facilities Infrastructure Reference Design — NVOnline #1145739.
- NVIDIA DSX Facilities Infrastructure Design Guide — NVOnline #1152370.
- Site Planning / Power & Cooling Specification final da configuração adquirida.
- Rack Supply/Return Interface Drawing e coolant/water-quality specification.
Data de corte: conteúdo técnico e lista de fornecedores verificados em 04/09/2026. O NVIDIA DSX Marketplace é dinâmico; revalide status, capacidade, flow e disponibilidade no momento da contratação.
Referências técnicas
- NVIDIA Vera Rubin NVL72 — especificações oficiais
- NVIDIA DGX Vera Rubin NVL72
- NVIDIA DSX Facilities Infrastructure Reference Design Overview
- NVIDIA DSX Infrastructure Marketplace — CDU
- NVIDIA Technical Blog — Vera Rubin POD
- NVIDIA Technical Blog — Inside the Vera Rubin Platform
- NVIDIA Mission Controls to BMS Data Catalog
- NVIDIA — Vera Rubin worldwide deployments
- NVIDIA — CoreWeave GB200 NVL72
- NVIDIA — Oracle OCI GB200 NVL72
- NVIDIA Case Study — NeoSpace / Finanças
- NVIDIA — GB300 deployments e AI Infrastructure in America
Conclusão
A principal inovação do Vera Rubin é sistêmica. O valor não está em uma GPU isolada, mas na combinação de compute, HBM4, NVLink 6, rede scale-out, storage, segurança, energia e Direct Liquid Cooling operando como uma única fábrica de computação.
Para empresas e data centers, a oportunidade está em transformar energia e infraestrutura física em capacidade útil de IA: treinamento de modelos, inferência agentiva, GPUaaS, pesquisa científica, simulação e serviços soberanos. O desafio também é sistêmico — elétrica, hidráulica, conectividade, software, observabilidade, operação e suporte precisam evoluir no mesmo ritmo do acelerador.
A pergunta correta: em vez de perguntar apenas quantas GPUs cabem no rack, o projeto deve responder quantos tokens úteis, agentes concluídos, simulações e workloads de negócio o data center consegue produzir por megawatt — com disponibilidade, segurança e previsibilidade operacional.
- Consolidar a demanda real de treinamento, inferência e HPC.
- Confirmar Max-P/TDP e o TCS design flow da configuração contratada.
- Calcular o Pump Head total antes de escolher a CDU.
- Emitir RFI para pelo menos três fornecedores com o pacote mínimo de dados.
- Definir critérios de comissionamento antes da contratação.
- Planejar telemetria, operação e manutenção desde o início.
EnQ Digital: infraestrutura inteligente para empresas que não podem parar — estratégia, engenharia, implantação, operação e evolução orientadas a risco e desempenho.