
Virtualização abstrai o hardware físico para executar múltiplos sistemas isolados no mesmo host. Uma VM (máquina virtual) é uma máquina completa com vCPU, RAM, disco, rede e sistema operacional próprios; uma VPS (servidor virtual privado) é geralmente essa mesma tecnologia comercializada como serviço, normalmente com plano e SLA definidos.
Sobre este material: conteúdo consolidado a partir de referências técnicas e da experiência de projeto da EnQ Digital, com data de corte em 2026. Preços, especificações e disponibilidade devem ser confirmados antes da contratação.
VM, VPS e virtualização
Cinco conceitos organizam o vocabulário: VM é a máquina completa (vCPU, RAM, disco, rede e sistema operacional); VPS é a VM comercializada como serviço, normalmente com plano e SLA; host é o servidor físico que executa o hipervisor; guest é o sistema operacional dentro da VM; e tenant é o cliente ou domínio lógico isolado.
VM descreve a tecnologia. VPS descreve geralmente o serviço entregue ao cliente. Uma VPS é normalmente uma VM, mas uma VM interna de um cluster corporativo não é necessariamente vendida como VPS. A qualidade de uma VPS depende do conjunto: host, política de overcommit, storage, rede, segurança, backup, suporte e transparência operacional.
Como a virtualização funciona
O hipervisor apresenta hardware virtual e arbitra o uso dos recursos físicos. No caminho de execução, a vCPU é agendada sobre threads ou núcleos físicos, a memória virtual é mapeada para páginas de RAM do host, discos virtuais usam arquivos, volumes ou blocos em storage local/compartilhado, vNICs conectam-se a bridges, vSwitches, port groups ou redes overlay, e drivers paravirtualizados reduzem o overhead de I/O.
Extensões de hardware como Intel VT-x/VT-d e AMD-V/IOMMU permitem virtualização assistida, isolamento e passthrough de dispositivos; Secure Boot e TPM virtual apoiam cadeias de confiança. O hipervisor isola e agenda; o sistema convidado ainda precisa de patch, hardening, monitoramento, backup e gestão de identidade — essa responsabilidade não desaparece com a virtualização.
Hipervisores tipo 1 e tipo 2
A escolha do hipervisor influencia disponibilidade, integração, licenciamento e operação. Hipervisores tipo 1 executam diretamente no hardware e são a referência para data center e produção; hipervisores tipo 2 executam sobre um sistema operacional e são mais adequados a laboratório e desktop.
Entre as plataformas comuns estão VMware ESXi/vSphere e VCF, Microsoft Hyper-V, KVM/QEMU em distribuições Linux e plataformas como Proxmox VE, e Nutanix AHV e outras soluções integradas. Os critérios de escolha devem avaliar em conjunto compatibilidade de hardware, recursos de HA, live migration, storage, rede, backup, APIs, ecossistema, capacitação da equipe e custo total.
Hardware do host
A camada virtual não elimina limites físicos; ela os concentra.
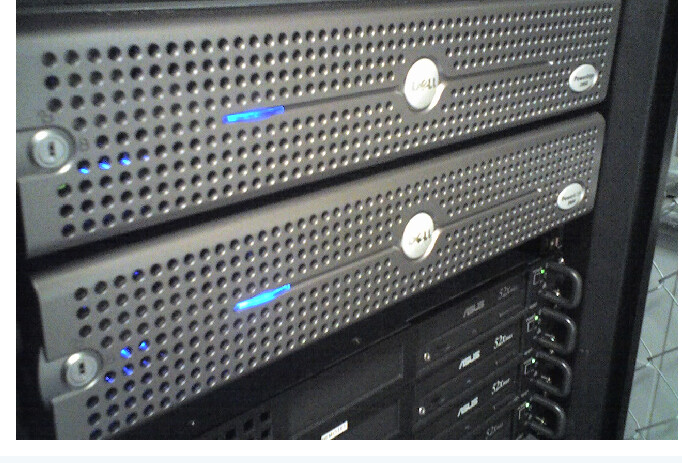
Os elementos a decidir incluem a CPU (sockets, cores, frequência, cache, TDP e geração), a RAM ECC (capacidade, canais, velocidade e expansão), o PCIe (lanes para NIC, HBA, NVMe e GPU), o storage (NVMe/SAS, RAID, SAN, NAS, Ceph ou HCI), a rede (10/25/40/100 GbE e redundância) e o BMC (gestão fora de banda e automação).
Fontes A/B, ventiladores hot-swap, interfaces redundantes e caminhos separados reduzem falhas locais. Para HA real, são necessários múltiplos hosts e dados acessíveis após a falha de um nó — resiliência de um único servidor não é o mesmo que alta disponibilidade de verdade.
CPU, vCPU e overcommit
vCPU não equivale automaticamente a um núcleo físico dedicado. O hipervisor agenda vCPUs em CPUs lógicas; workloads que aguardam tempo de CPU acumulam CPU Ready, e limites, reservas e shares influenciam a disputa por recursos.
As métricas relevantes incluem uso do host e da VM, CPU Ready/co-stop (ou métrica equivalente), frequência efetiva, steal time e throttling, e a relação vCPU:pCPU por cluster e por perfil de carga. A boa prática é consolidar com base em percentis e simultaneidade — bancos, aplicações licenciadas por core e cargas de baixa latência podem exigir menor overcommit, afinidade ou núcleos dedicados. Mais vCPUs podem, contraintuitivamente, piorar o desempenho se a VM precisar aguardar uma janela maior de escalonamento: dimensione pela carga medida, não pela intuição.
Memória, NUMA e ballooning
RAM costuma ser o primeiro limite de densidade de um cluster. Os mecanismos de gestão de memória incluem reserva (garante capacidade física), limite (restringe consumo máximo), ballooning (recupera memória com cooperação do guest), compressão e swap (últimas linhas de defesa, que aumentam latência) e transparent page sharing (depende da plataforma e política).
VMs grandes devem respeitar os limites dos nós NUMA — acesso remoto à memória pode aumentar latência, e vNUMA e posicionamento precisam estar alinhados ao sistema operacional e à aplicação. No dimensionamento de capacidade, inclua RAM do hipervisor, cache, agentes e margem N+1: não trate memória provisionada como consumo médio sem verificar picos e working set reais.
Storage virtual
Latência, IOPS e throughput são recursos compartilhados entre VMs e atividades de infraestrutura. Entre as opções de storage estão o local (baixa latência e simplicidade, com atenção a mobilidade e HA), SAN FC/iSCSI (compartilhamento e recursos maduros, com atenção a fabrics, multipath e custo), NFS (operação simples, com atenção a rede e servidor de arquivos), HCI/Ceph (escala distribuída, com atenção a rede, quorum e rebuild) e NVMe-oF (alta performance, com atenção a projeto e compatibilidade).
Os controles essenciais incluem thin provisioning com alerta de capacidade, multipath com caminhos físicos distintos, QoS para evitar noisy neighbor, TRIM/UNMAP, cache e alinhamento conforme a plataforma, e monitoramento de latência no guest, no host, no datastore e no array.
Rede virtual
A conectividade virtual combina NICs físicas, switches virtuais e políticas de segmentação.
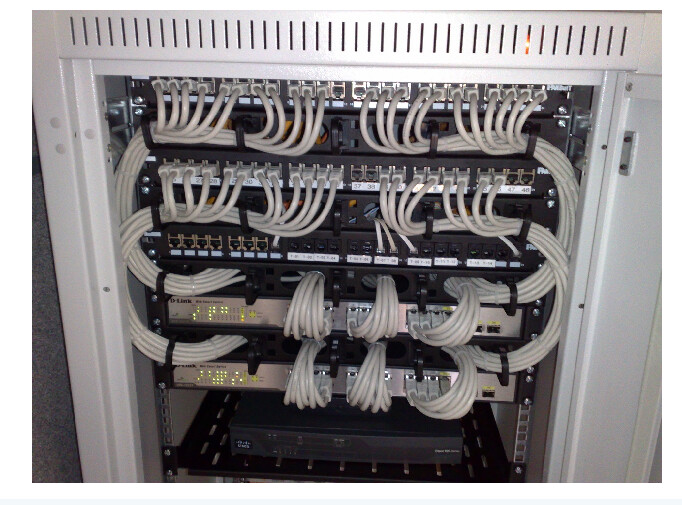
Os planos de rede a considerar são gestão do hipervisor, tráfego das VMs/tenants, live migration, storage, backup e replicação, e cluster e gestão fora de banda. Para disponibilidade, distribua uplinks entre switches físicos, valide LACP/MLAG ou roteamento e mantenha MTU consistente — o desenho deve sobreviver à perda de uma NIC, switch ou caminho.
VLANs, VRFs, VXLAN/EVPN, overlays e microsegmentação ampliam escala e isolamento na virtualização de rede, mas exigem observabilidade ponta a ponta para não se tornarem pontos cegos operacionais.
Topologia em 3 camadas
Uma arquitetura básica separa borda, virtualização e dados.
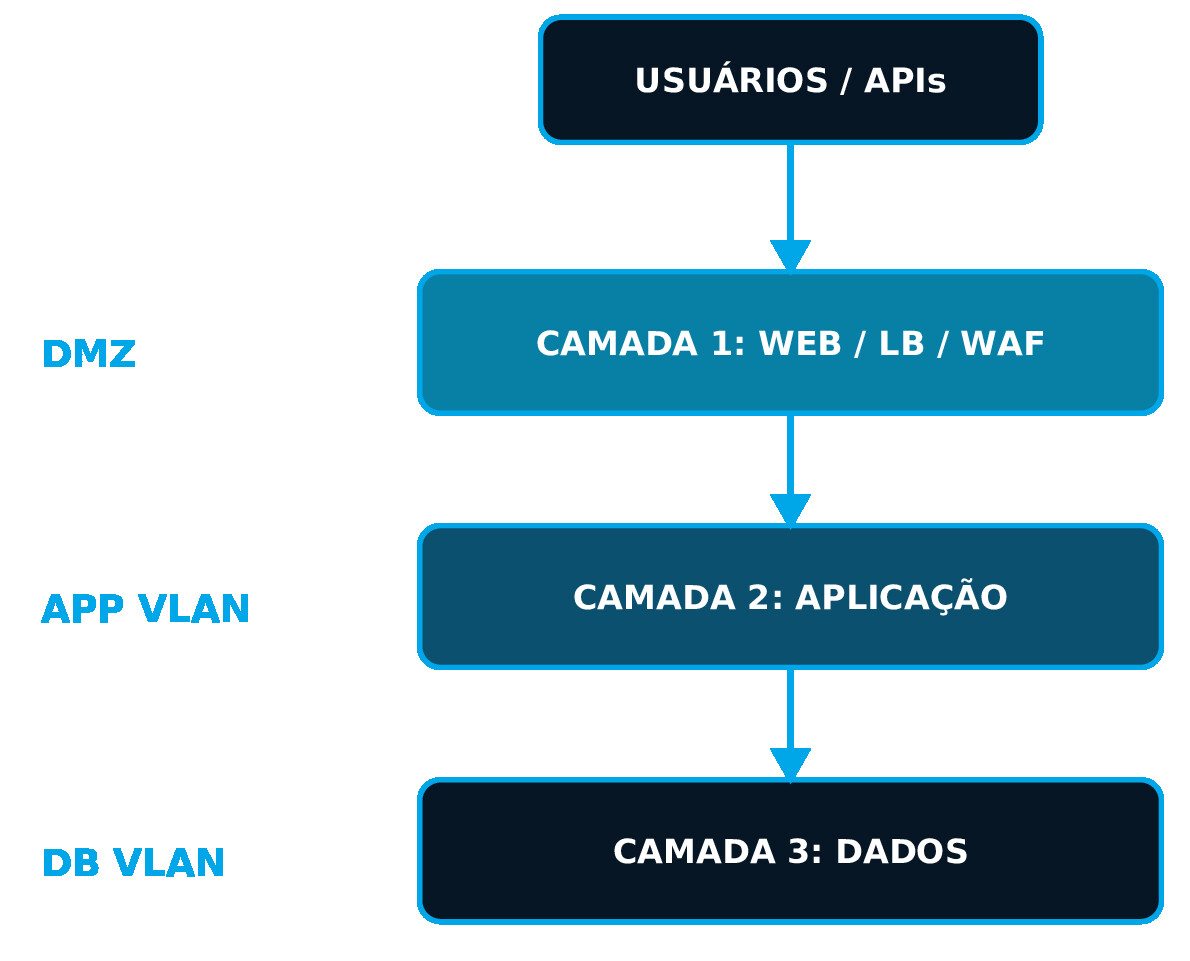
A camada 1 (Borda/DMZ) reúne proteção DDoS, roteadores, firewall HA, WAF e load balancer. A camada 2 (Compute) reúne o cluster de hipervisores e as redes dos tenants. A camada 3 (Dados) reúne storage, bancos, backup e replicação. Gestão, monitoramento e backup devem usar planos segregados e alcançar apenas os componentes necessários para cada função.
Segurança e isolamento
A segurança depende de controles no provedor, no hipervisor, na rede, no guest e no processo. Os controles centrais incluem MFA, RBAC e contas administrativas separadas; rede de gestão isolada com acesso por VPN/bastion; hardening e patch do host e dos guests; microsegmentação com regras deny-by-default; EDR, gestão de vulnerabilidade, logs centralizados e SIEM; e criptografia em trânsito e em repouso conforme o risco.
QoS, limites, reservas e monitoramento reduzem o impacto de noisy neighbor entre tenants — mas isolamento lógico não substitui avaliação de criticidade: cargas com exigência máxima podem requerer host dedicado. O acesso ao console do hipervisor é privilegiado por natureza: registre ações, aplique segregação de funções e proteja backups e snapshots contra exclusão.
Templates, clones e snapshots
Esses recursos aceleram a operação, mas têm propósitos diferentes e não devem ser confundidos entre si. Um template é a imagem padrão para novas VMs, mas não substitui a gestão de patches. Um clone é uma cópia independente ou vinculada, mas não substitui backup externo. Um snapshot serve para retorno curto antes de uma mudança, mas não substitui backup de longo prazo. Uma golden image é um baseline testado e versionado, mas não substitui hardening contínuo.
Snapshots longos crescem, aumentam a cadeia de dependência e podem degradar o I/O — defina proprietário, validade, alerta e remoção controlada para cada um. Ferramentas como cloud-init e Sysprep devem automatizar hostname, rede, chaves e identidade na primeira inicialização, evitando clonar segredos, IDs e agentes com estado entre VMs.
Alta disponibilidade
HA reinicia ou mantém serviços após falhas, conforme a capacidade e a tecnologia disponíveis. Os pré-requisitos incluem cluster com quorum confiável, capacidade N+1 ou superior, storage acessível ou replicado, redes redundantes, compatibilidade de CPU para migração, e health checks com políticas de reinício definidas.
Live migration move uma VM entre hosts com pouca ou nenhuma interrupção, facilitando a manutenção — mas não substitui HA, backup ou proteção contra falha da própria aplicação. Anti-affinity mantém réplicas, controladores de domínio e nós do mesmo serviço em hosts ou domínios de falha diferentes. Teste a perda de host, switch, datastore e alimentação: HA sem teste permanece uma suposição, não uma garantia.
Backup e recuperação
Backup deve ser independente do ambiente primário e testado regularmente. A estratégia envolve política 3-2-1 com cópia externa, imutabilidade ou air gap contra ransomware, backup consistente com a aplicação para bancos e diretórios, criptografia, retenção e controle de acesso separado, e testes regulares de restauração de arquivo, VM e serviço.
A frequência de backup define o potencial de perda (RPO); o método e a capacidade de restore influenciam o tempo de recuperação (RTO) — meça a restauração completa, incluindo rede, DNS, certificados e dependências. Backup em nível de imagem simplifica a recuperação da VM inteira; agentes podem oferecer granularidade e consistência específica dentro do guest. Ambientes críticos frequentemente combinam ambas as abordagens.
Disaster Recovery
DR recupera serviços em outro domínio de falha, com modelos que variam por custo e tempo de recuperação: backup externo (custo menor, recuperação mais lenta), cold standby (custo baixo/médio, recuperação em horas), warm standby (custo médio, recuperação em minutos/horas), hot/ativo-passivo (custo alto, recuperação em minutos) e ativo-ativo (custo muito alto, baixa interrupção).
O runbook de DR deve cobrir a ordem de subida e as dependências entre serviços, a replicação, consistência e ponto de corte dos dados, redes, DNS, IPs, certificados e firewall do site alternativo, critérios de declaração de desastre e de retorno ao site primário, e comunicação, responsáveis e evidências de teste.
Operação e observabilidade
O serviço virtual precisa ser observado do hardware à aplicação, ponta a ponta.
Os indicadores a acompanhar incluem saúde de host, BMC, fontes, discos e temperatura; CPU Ready, memória ativa, ballooning e swap; latência/IOPS de datastore e filas; drops, erros, throughput e latência de rede; e disponibilidade de serviços e experiência real do usuário. Na governança, inventário, CMDB, capacity planning, patches, mudanças, incidentes, problemas e ciclo de vida devem ter responsáveis e evidências documentadas.
Automação com Ansible
O Ansible padroniza a configuração dentro das VMs e, quando suportado, integra plataformas de virtualização. Suas automatizações típicas cobrem baseline Linux/Windows e hardening, usuários, chaves, pacotes, serviços e certificados, agentes de monitoramento, backup e EDR, patching em lotes com health checks, configuração de middleware e aplicações, e inventário dinâmico a partir da própria plataforma de virtualização.
Para segurança, use vault ou secrets manager, contas de serviço com menor privilégio, logs, revisão e pipelines — playbooks devem ser idempotentes e testados antes de chegar à produção. O fluxo seguro de patching segue: selecionar lote → retirar do balanceador → atualizar → testar → reintegrar → avançar.
Terraform e OpenTofu
Infraestrutura como código torna o provisionamento de VMs e redes declarativo, versionado e revisável. Os recursos típicos gerenciados incluem VM, template, CPU, RAM e disco, redes, VLANs, IPs e regras, datastores, tags, pastas e políticas, DNS, load balancer e integrações, e outputs para inventário Ansible e CMDB.
Proteja o state com backend remoto, criptografia, lock, versionamento e controle de acesso — segredos podem aparecer no state, então trate-o sempre como dado sensível. O pipeline típico segue: commit → lint/validate → plan → revisão → apply → cloud-init → Ansible → testes → observabilidade, com Terraform e OpenTofu usando versões fixadas e detecção de drift. Automação reduz variabilidade; governança reduz o raio de impacto da automação.
Containers x VMs
Containers compartilham o kernel; VMs virtualizam uma máquina completa. Em kernel, a VM tem um kernel próprio enquanto o container compartilha o do host. Em isolamento, a VM é mais forte por padrão, enquanto o container depende do runtime e da política aplicada. Em inicialização, a VM leva segundos a minutos, enquanto o container leva milissegundos a segundos. Em densidade, a VM é média e o container é alta. Em suporte a sistema operacional diferente do host, a VM permite e o container fica limitado ao kernel compartilhado.
Kubernetes frequentemente roda sobre VMs para separar tenants, facilitar o ciclo de vida e consumir recursos de clusters consolidados. Bare Metal pode ser preferido quando o objetivo é desempenho máximo ou uso direto de aceleradores.
Desempenho e benchmark
Um benchmark confiável deve reproduzir o perfil real de uso e considerar a disputa entre tenants no mesmo host. As métricas relevantes cobrem CPU (tempo, ready, steal e frequência), RAM (working set, faults, ballooning e swap), storage (IOPS, throughput, latência média e percentis), rede (throughput, PPS, latência, jitter e perda) e aplicação (transações, filas, tempo de resposta e erro).
Use dataset, concorrência, duração e janela representativos do uso real, testando em horário de carga com backup e tarefas de infraestrutura ativos simultaneamente. O desempenho de uma VPS não deve ser inferido apenas por vCPU e RAM anunciados: geração da CPU, política de compartilhamento, storage e rede podem mudar radicalmente o resultado final.
Dimensionamento
Dimensione pelo consumo medido, pelo crescimento esperado, pelas falhas possíveis e pelo licenciamento envolvido. Como exemplo ilustrativo, um perfil web leve tende a 2 vCPU / 4 GB / 80 GB, com atenção à escala horizontal; um perfil de aplicação tende a 4 vCPU / 8-16 GB / 150 GB, com atenção a latência e integrações; um perfil de banco médio tende a 8 vCPU / 32 GB / NVMe, com atenção a IOPS, backup e licença; e um perfil VDI é dimensionado por usuário/concurrency, com atenção a GPU, login storm e perfil de uso.
Em nível de cluster, some os picos simultâneos — não apenas as médias —, reserve capacidade para a falha de um host, considere manutenção, rebuild e crescimento futuro, e separe perfis de alta I/O ou baixa latência dos demais. Os valores citados são exemplos didáticos; a proposta final deve nascer de telemetria real ou de uma prova de conceito.
Licenciamento
A virtualização pode alterar significativamente o custo de software, e várias perguntas precisam de resposta antes da contratação: a licença é por core físico, vCPU, socket, VM, host ou usuário? Há mínimo de cores por processador ou servidor? A mobilidade entre hosts exige licenciar todo o cluster? O ambiente de DR tem direito passivo ou exige licença adicional? Recursos de gestão, backup e segurança são licenciados separadamente?
Edições e direitos de virtualização do Windows e de outras aplicações comerciais variam bastante — bancos, middleware e software comercial podem exigir regras próprias, então confirme sempre contrato, métrica e versão diretamente com o fabricante ou parceiro. No software open source, a ausência de licença proprietária não elimina o custo de suporte, atualização, capacitação e operação contínua.
VM x VPS x Bare Metal x Cloud
O melhor modelo depende da carga e da responsabilidade operacional desejada. Em controle, VM privada é alto, VPS gerenciada é médio/alto, Bare Metal é máximo, cloud pública é variável e container/PaaS tem menor infraestrutura sob gestão direta. Em elasticidade, VM privada e VPS ficam em média, Bare Metal em baixa/média, e cloud pública e container/PaaS em alta. Em previsibilidade, VM privada, VPS e Bare Metal tendem a alta, enquanto cloud pública é variável e container/PaaS depende do serviço específico.
VPS favorece rapidez e previsibilidade; VM privada favorece governança e integração; Bare Metal favorece isolamento e performance; cloud favorece elasticidade e serviços gerenciados. A escolha correta nasce do workload, não de uma preferência tecnológica isolada.
Migração para VM/VPS
A migração deve mapear dependências, compatibilidade e janela de execução antes de qualquer corte. As etapas típicas são: inventário de servidores, aplicações, dados e licenças; assessment de CPU, RAM, I/O, rede e dependências; desenho de destino, segurança, backup e monitoramento; piloto, teste de carga e restauração; replicação ou conversão P2V/V2V; cutover com critérios de go/no-go e rollback; e hypercare, aceite e otimização pós-migração.
Entre os métodos possíveis estão backup/restore, replicação, migração de VM, export/import e reconstrução automatizada — o menor downtime nem sempre é o método de menor risco. Antes do corte, valide DNS, certificados, firewall, sincronismo de dados, desempenho, backup, observabilidade e o plano de retorno em caso de problema.
VPS EnQ Digital
A EnQ Digital estrutura VPS e ambientes virtuais conforme capacidade, criticidade, sistema operacional, rede, backup, segurança e nível de gestão contratado. Os perfis comerciais de referência incluem o plano Bronze (2 vCPU, 4 GB, indicado para sites, serviços leves e homologação), o plano Silver (4 vCPU, 8 GB, indicado para aplicações corporativas médias) e o plano Gold (8 vCPU, 16 GB, indicado para cargas mais intensivas e bancos pequenos).
As possibilidades de solução incluem Linux ou Windows conforme disponibilidade e licença; IPs, VLANs, VPN e regras de firewall conforme o projeto; backup, monitoramento e suporte conforme o SLA contratado; escala de CPU, RAM e storage mediante capacidade; integração com Bare Metal, colocation, storage S3 e conectividade; e automação com Ansible e Terraform/OpenTofu conforme o escopo. Os perfis citados são referências de portfólio — preços, storage, tráfego, sistema operacional, SLA e recursos adicionais devem constar na proposta comercial vigente.
Checklist e conclusão
Uma boa contratação transforma especificações em compromissos verificáveis. O checklist final deve cobrir: modelo e geração de CPU, política de vCPU e overcommit; RAM, reservas, limites e possibilidade de expansão; storage — tipo, capacidade, IOPS, latência e proteção; rede — banda, tráfego, IPs, DDoS, VLAN/VPN e firewall; SLA, suporte, manutenção e responsabilidade pelo guest; backup — frequência, retenção, imutabilidade e restore; localidade, compliance, portabilidade e processo de saída; e licenças, instalação, migração e custos adicionais.
Um ambiente de VM/VPS bem projetado entrega previsibilidade e agilidade sem abrir mão de governança. O valor real aparece quando hardware, hipervisor, rede, segurança, backup e operação são tratados como um único sistema — não como escolhas isoladas feitas em momentos diferentes do projeto.
Créditos das fotografias: servidores rack — Dsv, domínio público; switches e patch panels em rack de 19 polegadas — Dsimic, CC BY-SA 4.0; técnico em rack de data center — Derrick Coetzee, CC0 1.0. Fontes: Wikimedia Commons. Imagens recortadas/redimensionadas apenas para diagramação.