
Este guia técnico reúne, em uma única visão, a plataforma VMware da geração atual: o hipervisor ESXi, o vCenter Server como plano de controle, e as duas ofertas empacotadas — VMware vSphere Foundation (VVF) e VMware Cloud Foundation (VCF) — com licenciamento por núcleo, gestão, identidade, automação, segurança, desempenho e continuidade.
A proposta é servir arquitetos, engenheiros, gestores de infraestrutura, pré-vendas e tomadores de decisão. Os exemplos de capacidade são modelos de dimensionamento, não garantias para qualquer workload — devem ser recalculados com as medições reais de CPU, memória, latência, IOPS, throughput, RPO e RTO.
Sobre este material: conteúdo consolidado a partir de fontes oficiais da Broadcom/VMware disponíveis até 2 de setembro de 2026, incluindo VMware Cloud Foundation 9.x e VMware vSphere Foundation na geração atual. Licenciamento, métricas promocionais, versões, suporte e disponibilidade podem mudar — confirme a proposta comercial, o Product Guide e os termos contratuais vigentes antes de comprar ou renovar.
Visão executiva e mapa da plataforma
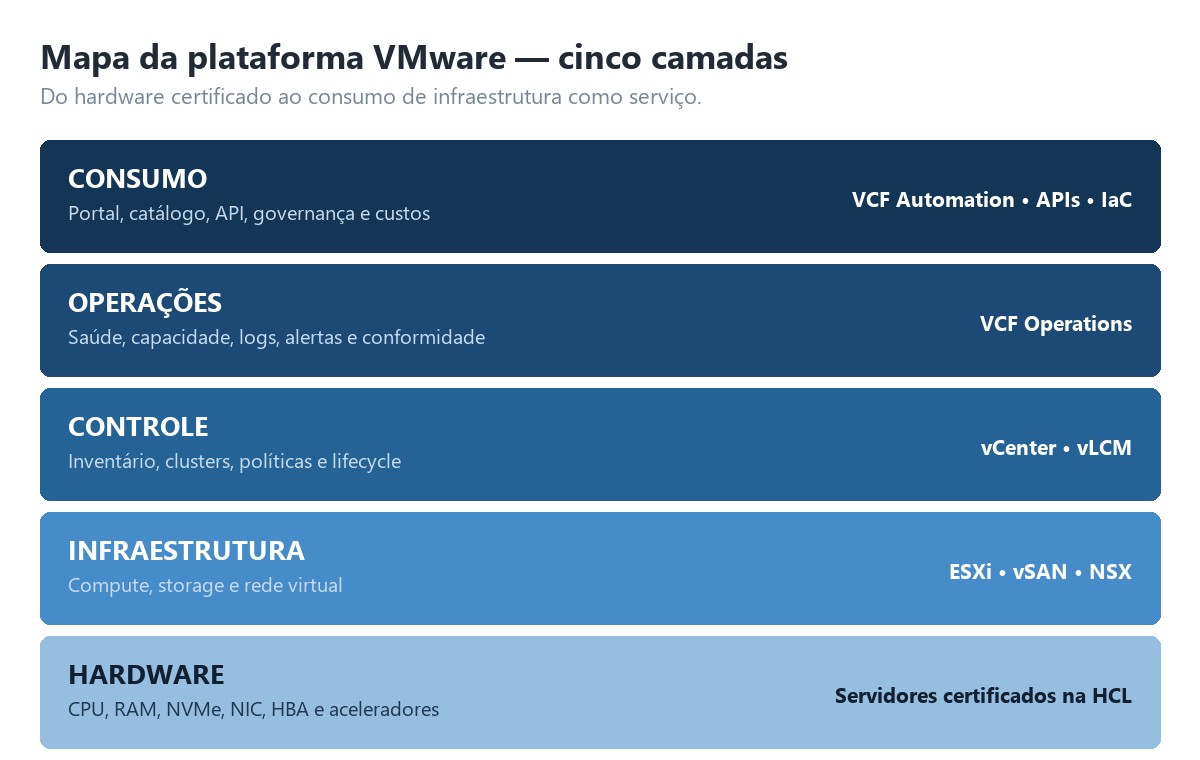
A pilha VMware começa no ESXi, o hipervisor bare metal instalado diretamente nos servidores. O vCenter Server adiciona inventário, políticas, clusters e serviços distribuídos. O VVF empacota a plataforma de workloads e HCI; o VCF amplia o conjunto para uma nuvem privada full stack com rede definida por software, automação, gestão de frota, Kubernetes e serviços avançados.
| Camada | Função principal | Tecnologias típicas |
|---|---|---|
| Consumo | Portal, catálogo, API, governança e custos | VCF Automation, APIs, IaC |
| Operações | Saúde, capacidade, logs, alertas e conformidade | VCF Operations |
| Controle | Inventário, clusters, políticas e lifecycle | vCenter, vLCM |
| Infraestrutura | Compute, storage e rede virtual | ESXi, vSAN, NSX |
| Hardware | CPU, RAM, NVMe, NIC, HBA e aceleradores | Servidores certificados na HCL |
Decisão em uma frase: escolha VVF quando o centro da necessidade é virtualização e HCI gerenciada; escolha VCF quando a meta é operar uma nuvem privada integrada, automatizada, multitenant e orientada a autosserviço.
Principais capacidades
| Capacidade | O que entrega | Valor operacional |
|---|---|---|
| vMotion | Migração de VMs ligadas entre hosts | Manutenção sem parada planejada |
| HA | Reinício automático após falha de host | Recuperação rápida |
| DRS | Balanceamento orientado a recursos | Melhor utilização e menor hotspot |
| vSAN | Storage distribuído baseado em políticas | HCI e escala horizontal |
| VKS | Kubernetes integrado ao plano de controle | VMs e containers na mesma plataforma |
| NSX / VPC | Rede e isolamento definidos por software | Agilidade e segmentação |
| VCF Operations | Observabilidade, capacidade e diagnóstico | Menor tempo de resolução |
| VCF Automation | Catálogo, workflows, políticas e APIs | IaaS de autosserviço |
Três planos operacionais
- Plano de dados: VMs, containers, redes e volumes executam nos hosts.
- Plano de controle: vCenter, managers e controladores mantêm estado, inventário e políticas.
- Plano de gestão: Operations, Automation e Fleet Management monitoram, provisionam e atualizam a plataforma.
ESXi: a camada de virtualização
O ESXi fornece isolamento de workloads e agenda vCPUs sobre CPUs físicas, gerencia memória, dispositivos, drivers, datastores e switches virtuais. Seu desenho reduz a superfície de um sistema operacional de propósito geral, mas exige disciplina de firmware, compatibilidade, hardening e lifecycle.
CPU e NUMA
- Dimensione vCPU pela demanda observada, não pelo máximo teórico. VMs superdimensionadas podem esperar mais tempo para agendamento.
- Mantenha VMs críticas dentro de um nó NUMA quando possível; VMs muito largas podem acessar memória remota com maior latência.
- Analise CPU Ready, Co-Stop, utilização, latência da aplicação e frequência efetiva em conjunto.
Memória
- Evite pressão sustentada que acione ballooning, compressão e swapping; swap do host é o último recurso e degrada latência.
- Reservations garantem capacidade, Limits impõem teto e Shares definem prioridade sob contenção.
- Considere o overhead do hipervisor, agentes, vSAN e serviços de infraestrutura no cálculo do cluster.
Rede virtual
| Elemento | Uso | Recomendação |
|---|---|---|
| vSwitch Standard | Host isolado ou ambiente simples | Bom para pequena escala; configuração por host |
| vSphere Distributed Switch | Política central e recursos avançados | Preferível em clusters empresariais |
| Port group | VLAN e política lógica | Padronize nomes e IDs |
| vmkernel | Management, vMotion, vSAN, NFS, FT | Separe tráfego e aplique redundância |
| NIC teaming | Disponibilidade e distribuição | Valide failover com os switches físicos |
Storage e ciclo de vida
O ESXi pode consumir VMFS em SAN FC/iSCSI, NFS e vSAN. A escolha deve equilibrar latência, throughput, resiliência, operação, integração de backup e custo. Uma VM usa arquivos de configuração, discos virtuais, snapshots temporários e logs — snapshots não substituem backup. Para o lifecycle, valide hardware, firmware, drivers e a matriz de compatibilidade; defina a imagem desejada no vSphere Lifecycle Manager; teste em grupo piloto; entre em manutenção evacuando workloads; e valide saúde, rede, storage, alarmes e performance após a mudança.
Métrica que importa: IOPS sem tamanho de bloco, proporção leitura/escrita, profundidade de fila e latência é um número incompleto. Registre o perfil inteiro do workload.
vCenter Server: controle central
O vCenter Server Appliance centraliza hosts, VMs, templates, tags, permissões, clusters e tarefas. Ele não fica no caminho de I/O das VMs: se o vCenter parar, os workloads continuam, mas funções de gestão e serviços dependentes ficam limitados. Sua recuperação deve ser planejada e testada.
| Objeto de inventário | Responsabilidade |
|---|---|
| Datacenter | Contêiner lógico de clusters, hosts, redes e datastores |
| Cluster | Domínio de HA, DRS, EVC e lifecycle |
| Resource pool | Reserva, limite e prioridade hierárquica |
| Folder | Organização e escopo de permissão |
| Tag / Category | Metadado para política, automação e governança |
| Content Library | Templates, OVFs, ISOs e distribuição de conteúdo |
Alta disponibilidade do vCenter
Proteja a appliance com backup nativo baseado em arquivo para destino externo, HA do cluster e cópia coerente das configurações. A estratégia deve incluir restauração da appliance, DNS, NTP, certificados, credenciais de break-glass e dependências de identidade. Evite criar dependência circular em que o único DNS, AD ou repositório necessário para recuperar o vCenter esteja indisponível dentro do próprio ambiente afetado.
Antipadrões de administração
- Executar operação diária com administrator@vsphere.local.
- Conceder função global quando o operador atua somente em um folder ou cluster.
- Usar a mesma conta técnica para backup, monitoração e automação.
- Manter certificados, DNS e NTP sem monitoramento de validade e disponibilidade.
- Confiar apenas em snapshot da appliance em vez de backup nativo restaurável.
Princípio de RBAC: atribua grupos corporativos a funções mínimas no escopo correto. Evite permissões diretas a usuários e não use Administrator para tarefas diárias.
Licenciamento: VCF versus VVF
O modelo atual é de assinatura por núcleo físico. Para cada CPU física de um host ESXi, aplica-se um mínimo de 16 núcleos licenciáveis, mesmo se o processador tiver menos. Todos os núcleos físicos que executam o software devem ser considerados. Condições comerciais, prazo, suporte e add-ons devem ser confirmados na proposta vigente.
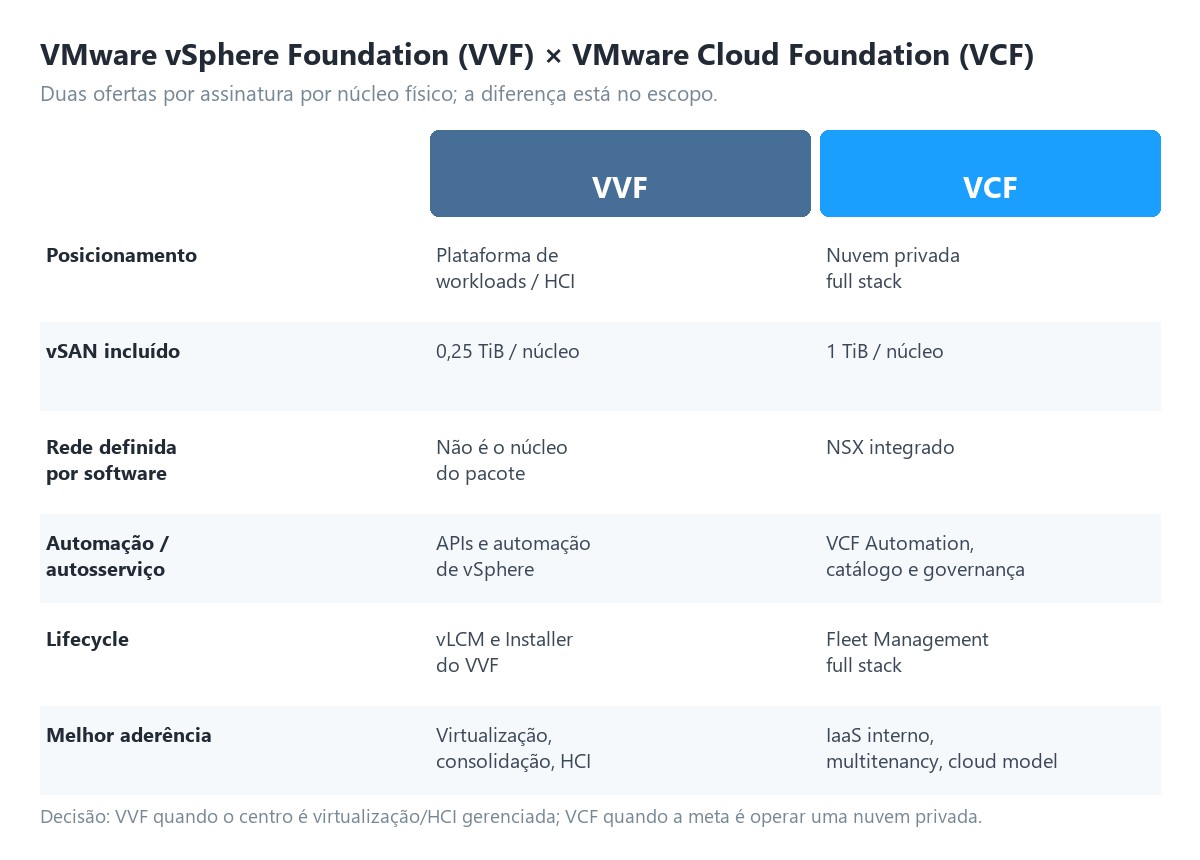
| Critério | VMware vSphere Foundation (VVF) | VMware Cloud Foundation (VCF) |
|---|---|---|
| Posicionamento | Plataforma de workloads / HCI | Plataforma completa de nuvem privada |
| Compute | vSphere Enterprise Plus + vCenter Standard | vSphere integrado ao stack VCF |
| Storage incluído | 0,25 TiB vSAN por núcleo | 1 TiB vSAN por núcleo |
| Rede definida por software | Não é o núcleo do pacote | NSX integrado |
| Operações | VCF Operations para infraestrutura | Operações unificadas full stack |
| Automação / autosserviço | APIs e automação de vSphere; escopo menor | VCF Automation, catálogo e governança |
| Lifecycle | vLCM e Installer do VVF | Fleet Management e lifecycle full stack |
| Kubernetes | VKS incluído | VKS integrado à nuvem privada |
| Melhor aderência | Virtualização, consolidação, HCI | IaaS interno, multitenancy, rede/segurança e cloud operating model |
Fórmula de núcleos
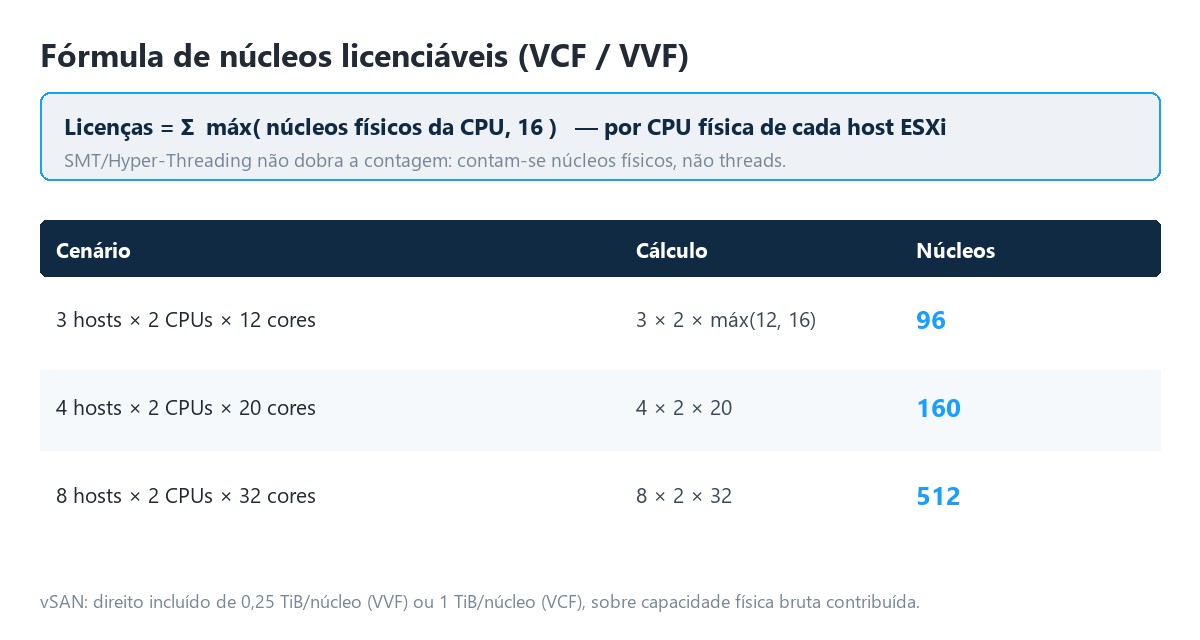
| Cenário | Cálculo | Núcleos licenciáveis |
|---|---|---|
| 3 hosts, 2 CPUs/host, 12 cores/CPU | 3 × 2 × máx(12, 16) | 96 |
| 4 hosts, 2 CPUs/host, 20 cores/CPU | 4 × 2 × 20 | 160 |
| 8 hosts, 2 CPUs/host, 32 cores/CPU | 8 × 2 × 32 | 512 |
Exemplo vSAN
Cluster com 4 hosts, 2 CPUs de 20 cores por host: 160 núcleos. O direito incluído é 40 TiB no VVF e 160 TiB no VCF. Se o cluster contribuir 120 TiB brutos ao vSAN, o VVF exigiria 80 TiB adicionais; o VCF teria cobertura incluída, sujeito aos termos vigentes. A licença considera a capacidade física bruta contribuída, não o espaço útil mostrado após políticas e overhead.
VCF 9: gestão de licença
- Arquivo único de licença e visão consolidada no VCF Operations, substituindo várias chaves por componente.
- Modo conectado ou desconectado / air-gapped.
- Envio e atualização de uso dentro de cada janela de 180 dias.
- Sem dados de uso, os workloads existentes continuam, mas a gestão pode ser desconectada e novos workloads deixam de ser criados, conforme a visão geral oficial do VCF 9.
Atenção comercial: não estime TCO apenas multiplicando um "preço por core" encontrado na internet. Inclua prazo de assinatura, suporte, add-ons, vSAN excedente, hardware certificado, serviços, impostos, câmbio, migração e operação.
Árvore de decisão
- Precisa apenas consolidar VMs, HA/DRS, vMotion, storage externo ou HCI simples? Comece avaliando VVF.
- Precisa NSX integrado, VPCs, autosserviço, catálogo, governança e lifecycle full stack? Avalie VCF.
- Precisa alta densidade de vSAN? Compare o direito de 0,25 TiB/core do VVF com 1 TiB/core do VCF e os add-ons.
- Precisa DR, segurança avançada, balanceamento ou proteção contra ransomware? Verifique os advanced services; nem tudo faz parte do core.
Painéis de gestão e observabilidade
O painel correto depende da pergunta. O vSphere Client é excelente para administração de objetos e tarefas. O VCF Operations correlaciona saúde, capacidade, custo, alertas e tendências. O VCF Automation entrega catálogo e governança de consumo. O Fleet Management organiza o lifecycle do stack.
| Painel | Usuário principal | Perguntas respondidas |
|---|---|---|
| vSphere Client | Administrador de virtualização | Qual VM, host, rede ou datastore precisa de ação? |
| VCF Operations | NOC, SRE, capacidade, FinOps | Onde há risco, desperdício, anomalia ou saturação? |
| VCF Automation | DevOps, platform team, usuários internos | Como solicitar e governar infraestrutura como serviço? |
| Fleet Management | Equipe da plataforma | Quais instâncias, versões, credenciais e updates compõem a frota? |
| Business Services Console | Gestão de assinatura | Qual alocação e consumo de licença existe? |
Dashboard operacional recomendado
| Bloco | Indicadores |
|---|---|
| Disponibilidade | Hosts desconectados, HA admission control, VMs sem redundância, falhas de hardware |
| CPU | Uso, Ready, Co-Stop, contenção, frequência e NUMA |
| Memória | Consumed, Active, balloon, compression, swap e reservas |
| Storage | Latência leitura/escrita, IOPS, throughput, congestionamento, capacidade e resync |
| Rede | Drop, erro, saturação, failover, latência e perda |
| Capacidade | Dias restantes, reclaim, crescimento, headroom N+1/N+2 |
| Experiência | Tempo de provisionamento, falhas de workflow, incidentes e SLO |
Evite ruído: um painel com 200 alertas sem dono é decoração. Consolide sintomas correlacionados, defina SLOs e gere tickets somente quando houver ação clara — com sintoma, causa provável, contexto e ação (runbook, responsável, prioridade e critério de encerramento).
Active Directory, Entra ID e Azure
"Azure AD" passou a se chamar Microsoft Entra ID. O vCenter pode federar autenticação com provedores corporativos, permitindo SSO e políticas modernas. O Active Directory tradicional continua relevante em ambientes on-premises. A arquitetura deve distinguir autenticação, autorização e sincronização de identidades.
| Modelo | Quando usar | Pontos de atenção |
|---|---|---|
| AD over LDAP | AD local e integração clássica | TLS, certificados, contas de bind e dependência de DC |
| Integrated Windows Authentication | Legados específicos | Avaliar suporte e direção de produto |
| AD FS | Federação já padronizada em AD FS | Disponibilidade do farm, claims e certificados |
| Microsoft Entra ID | Cloud identity, MFA e acesso condicional | Aplicativo corporativo, grupos, claims e contas de emergência |
| Okta / PingFederate | IdP corporativo alternativo | Mapeamento de grupos e ciclo de certificado |
Fluxo recomendado com Entra ID
- Criar e autorizar o aplicativo corporativo conforme a documentação da versão do vCenter.
- Configurar o provedor de identidade no vCenter e validar URLs, tenant, client ID e certificados/segredos quando aplicável.
- Mapear grupos do Entra ID para funções vCenter com menor privilégio.
- Aplicar MFA e Conditional Access no IdP, com exceções controladas apenas para recuperação.
- Testar login, logout, expiração, remoção de grupo, indisponibilidade do IdP e conta break-glass.
Exemplo de grupos
| Grupo corporativo | Função sugerida | Escopo |
|---|---|---|
| GG-VMW-Platform-Admins | Administrador de plataforma | vCenter/Datacenter, grupo restrito |
| GG-VMW-VM-Ops | Operador de VM customizado | Folders/Resource Pools de produção |
| GG-VMW-Auditors | Read-only + eventos | Datacenter |
| GG-VMW-Backup | Permissões mínimas do produto de backup | Objetos necessários |
| GG-VMW-Developers | Consumidor de catálogo | Projetos/organizações no Automation |
Fronteira importante: conectar o vCenter ao Entra ID não "move o VMware para o Azure" — é federação de identidade. Extensão de workloads, DR ou operação em nuvem pública são decisões arquiteturais separadas. Mantenha pelo menos duas contas locais de recuperação protegidas em cofre, que funcionem mesmo se DNS, AD, Entra ID ou conectividade externa falharem.
Orquestração, automação e APIs
Automação executa tarefas; orquestração coordena várias tarefas, dependências, aprovações, políticas, rollback e estado. Em VCF, a meta é transformar infraestrutura em um serviço consumível com guardrails, e não apenas escrever scripts de criação de VM.
| Camada | Ferramentas | Exemplo |
|---|---|---|
| API / SDK | vSphere API, REST, Unified SDK | Criar VM e consultar inventário |
| CLI | PowerCLI, govc, esxcli | Relatórios e operação em lote |
| IaC | Terraform providers | Declarar redes, VMs e políticas |
| Workflow | VCF Automation Orchestrator | Aprovação, IPAM, DNS, CMDB e rollback |
| Catálogo | VCF Automation | Blueprint/templating e autosserviço |
| Configuração guest | Ansible, scripts, cloud-init | Instalar middleware e aplicar baseline |
Boas práticas
- Idempotência: repetir não deve criar duplicatas nem corromper estado.
- Segredos: usar vault, rotação e identidades de serviço; nunca embutir senha em código.
- Tags obrigatórias: owner, application, environment, data-class, backup-policy, cost-center e expiry.
- Git: versionar templates e workflows, revisar por pull request e promover entre ambientes.
- Observabilidade: registrar requester, parâmetros, etapas, retorno e correlation ID.
- Rollback: distinguir ação reversível de ação destrutiva e pedir aprovação adequada.
Governança mínima do catálogo
| Controle | Implementação |
|---|---|
| Quota | Limite por projeto, ambiente e classe de recurso |
| Aprovação | Somente quando risco, custo ou privilégio justificar |
| Expiração | TTL padrão para laboratório e revisão antes da renovação |
| Evidência | Owner, ticket, versão do template e resultado do workflow |
| Descomissionamento | Backup final quando necessário, revogação de DNS/IP e baixa na CMDB |
Resultado esperado: uma requisição padronizada pode cair de dias para minutos, mas o KPI correto inclui taxa de sucesso, conformidade, retrabalho, custo e tempo de recuperação — não apenas velocidade.
Desempenho, sizing e benchmarks
Desempenho deve ser medido ponta a ponta. O hipervisor pode estar saudável enquanto o banco, a rede ou o storage limitam a aplicação. Use baseline, percentis e testes controlados; médias escondem picos.
| Domínio | Indicador | Sinal de investigação |
|---|---|---|
| CPU | CPU Ready | Crescimento sustentado com latência da aplicação |
| CPU | Co-Stop | VM SMP larga aguardando agendamento |
| Memória | Balloon / Swap | Pressão real ou reservas inadequadas |
| Storage | Latência guest/kernel/device | Localizar a fila e a camada limitante |
| Storage | IOPS + bloco + R/W | Caracterizar a demanda, não apenas o volume |
| Rede | Drop / error / throughput | Fila, MTU, driver, uplink ou congestionamento |
| vSAN | Congestion / resync | Impacto de rebuild, política ou dispositivo |
Exemplo 1: cluster de virtualização geral
Quatro hosts, cada um com 2 CPUs de 24 cores e 512 GB de RAM. Total bruto: 192 cores e 2.048 GB. Reservando um host para falha N+1, a capacidade operacional aproximada é 144 cores e 1.536 GB antes de overhead. Com 120 VMs de média 2 vCPU e 8 GB, há 240 vCPU e 960 GB configurados. A razão vCPU:pCore operacional é 1,67:1 e a memória configurada ocupa 62,5% da capacidade N+1.
| Item | Valor | Leitura |
|---|---|---|
| CPU bruta | 192 cores | 4 × 2 × 24 |
| CPU N+1 | 144 cores | 3 hosts disponíveis |
| vCPU configurada | 240 vCPU | 120 × 2 |
| Razão vCPU:pCore N+1 | 1,67:1 | Conservadora para workload misto |
| RAM N+1 | 1.536 GB | Antes de overhead |
| RAM de VMs | 960 GB | Headroom nominal de 576 GB |
Exemplo 2: storage transacional
Demanda de pico de 80.000 IOPS, bloco de 8 KiB, 70% leitura e 30% escrita. Throughput lógico aproximado: 80.000 × 8 KiB = 625 MiB/s. A arquitetura deve sustentar o padrão com latência compatível, falhas de dispositivo e política de proteção. Teste também rebuild/resync, snapshots e backup, pois o steady state sozinho não representa a operação real.
Exemplo 3: metas publicadas pelo fabricante
| Métrica publicada | Valor de referência | Contexto |
|---|---|---|
| Migração end-to-end | Até 65% mais rápida | Processamento paralelo de DRS vMotion |
| CPU fonte em vMotion criptografado | Até 70% menor | Offload Intel QAT em hardware compatível |
| Escala de "monster VM" | Até 960 vCPU e 16 TB RAM | Limite da geração atual do VVF |
| Ganho em sistemas 4-socket | Até 68% | Agendamento topology/NUMA-aware |
| vGPU vMotion | Até 6× mais rápido | Offload e redes de maior largura de banda |
| Troubleshooting | Até 60% menos esforço | Diagnóstico proativo full stack |
Cuidado com o "até": esses valores dependem de hardware, versão e metodologia e não devem ser somados para formar um business case. Faça PoC com o perfil real e critérios de aceite definidos — defina SLO e hipótese, capture baseline de produção, reproduza CPU/memória/I/O/rede e concorrência, teste steady state, pico, manutenção, falha e recuperação, e compare percentis, não só a média.
Rede, storage, disponibilidade e DR
Uma plataforma resiliente é desenhada a partir do impacto aceitável, não de uma lista de produtos. Traduza a criticidade em SLO, RPO e RTO, e só então escolha HA, replicação, backup e DR.
| Tráfego | Função | Prática recomendada |
|---|---|---|
| Management | Gerência de hosts e appliances | Redundância, ACL e acesso administrativo controlado |
| vMotion | Migração de memória/estado | Alta banda, baixa latência e isolamento |
| vSAN | I/O e resync do cluster | Rede dedicada/lógica, compatibilidade e headroom |
| Storage IP | NFS / iSCSI | Multipathing, filas, MTU coerente e QoS quando necessário |
| Workloads | Aplicações e tenants | Segmentação, políticas e observabilidade |
| Backup / replicação | Cópia e DR | Evitar competir com a produção em janelas críticas |
Disponibilidade
- N+1 protege contra uma falha de host; N+2 pode ser necessário durante manutenção ou em clusters críticos.
- HA reinicia VMs — não equivale a continuidade sem interrupção. Fault Tolerance atende casos específicos com exigências próprias.
- Admission Control deve reservar capacidade de failover; desativá-lo mascara o risco.
- Stretched cluster reduz o RTO para falha de site, mas exige latência, witness, rede e desenho de dependências compatíveis.
Backup e DR
| Mecanismo | Protege contra | Não substitui |
|---|---|---|
| HA | Falha de host | Backup ou DR de site |
| vMotion | Manutenção planejada | Replicação ou backup |
| Snapshot | Mudança de curto prazo | Backup independente |
| Replicação | Perda de site/array conforme o desenho | Cópia imutável contra corrupção/ransomware |
| Backup imutável | Exclusão, corrupção e ransomware | Plano de continuidade e capacidade de restore |
| SRM / orquestração de DR | Sequência e teste de failover | Infraestrutura e dados no destino |
Teste de verdade: RPO e RTO só são confiáveis após um teste que restaure aplicações, identidade, DNS, rede, segredos e integrações — não apenas ligando VMs. O teste deve cobrir falha simultânea de host e caminho de storage em pico, indisponibilidade de vCenter/DNS/NTP/IdP/KMS na recuperação, perda de site com isolamento parcial, restore isolado após ransomware e o retorno ao site primário.
Segurança, hardening e operação
Segurança em VMware abrange hardware, ESXi, vCenter, rede, identidades, VMs, automação e cadeia de suprimentos. O objetivo é reduzir superfície, limitar movimento lateral, detectar drift e recuperar rapidamente.
| Controle | Implementação |
|---|---|
| Identidade | Federação, MFA, grupos, menor privilégio e break-glass |
| Plano de gestão | Rede dedicada, jump host / PAM, ACL e logs centralizados |
| Host | Secure Boot, TPM 2.0, lockdown quando aplicável, serviços mínimos |
| Criptografia | TLS atualizado, VM/vSAN encryption e KMS com HA |
| Rede | Segmentação, firewall distribuído / add-ons conforme a licença |
| Lifecycle | Patches, HCL, imagens desejadas e janela de remediação |
| Auditoria | Eventos, mudanças, login, tarefas, configuração e retenção |
| Recuperação | Backups imutáveis, restore testado e credenciais fora do domínio de falha |
Rotina Day 2
- Diário: alarmes críticos, capacidade de failover, backups, hardware e tarefas falhas.
- Semanal: anomalias, snapshots antigos, VMs órfãs, datastore, resync e patches urgentes.
- Mensal: capacity forecast, direitos de licença, contas privilegiadas, certificados e restore amostral.
- Trimestral: teste de DR, revisão de RBAC, firmware/HCL, runbooks e riscos de dependência.
- Anual: arquitetura, contrato, TCO, ciclo de hardware, SLOs e plano de modernização.
Arquiteturas de referência e implantação
Padrão A — VVF com storage externo
| Componente | Desenho |
|---|---|
| Compute | 4 a 8 hosts ESXi, N+1, CPUs compatíveis e RAM conforme o perfil |
| Controle | vCenter + VCF Operations |
| Storage | SAN FC/iSCSI ou NFS redundante; multipathing |
| Rede | vDS, uplinks redundantes e VLANs segregadas |
| Uso | Consolidação de VMs, ERP, banco, middleware e VDI |
Padrão B — VVF HCI com vSAN
| Componente | Desenho |
|---|---|
| Cluster | Mínimo técnico conforme a arquitetura; 4+ hosts é comum para margem |
| Storage | vSAN ESA/OSA conforme hardware e compatibilidade |
| Gestão | vCenter + Operations + SPBM |
| Escala | Adicionar nós ou usar storage cluster / disaggregated conforme suporte |
| Uso | Operação simplificada de compute e storage em um cluster |
Padrão C — VCF private cloud
| Componente | Desenho |
|---|---|
| Management domain | Serviços de controle, gestão e lifecycle |
| Workload domains | Clusters separados por SLA, hardware, tenant ou finalidade |
| Rede | NSX, VPCs, overlays e gateways conforme a arquitetura |
| Consumo | Automation, catálogo, projetos, quotas e políticas |
| Operação | Operations, Fleet Management, logs e integrações |
| Uso | Nuvem privada, IaaS interno, apps modernas, Kubernetes e IA privada |
Regra de desenho: não comece pelo número de hosts. Comece pelo workload, domínio de falha, SLA, crescimento, compatibilidade, operação e licenciamento — o hardware é consequência. As fases são assessment, HLD, LLD, build, validate, migrate e operate.
Migração, custos e checklist
| Estratégia | Vantagem | Risco / limitação |
|---|---|---|
| vMotion / cross-vCenter | Baixa interrupção quando compatível | Rede, latência, versões, EVC e storage |
| HCX | Mobilidade em escala e extensão de rede | Planejamento de appliances e throughput |
| Backup / restore | Independente e verificável | Janela e tempo de cópia |
| Replicação | RPO reduzido e cutover controlado | Consistência e bandwidth |
| Rebuild | Moderniza SO e configuração | Mais esforço de aplicação e teste |
Modelo de TCO em 3 anos
| Categoria | Itens |
|---|---|
| Software | VCF/VVF, vSAN adicional, advanced services, backup, observabilidade |
| Hardware | Hosts, discos, switches, optics, SAN, suporte e peças |
| Facilities | Rack, energia, refrigeração, espaço e conectividade |
| Serviços | Assessment, implantação, migração, treinamento e suporte |
| Operação | Equipe, plantão, patches, capacidade, auditoria e incidentes |
| Risco | Downtime, lock-in, atraso, retrabalho e obsolescência |
Checklist de decisão VVF × VCF
- Inventário de hosts, sockets, cores e capacidade vSAN bruta concluído.
- Workloads classificados por criticidade, RPO, RTO, CPU, RAM, I/O, rede e crescimento.
- Necessidade de NSX, microsegmentação, VPCs e multitenancy validada.
- Necessidade de catálogo, autosserviço, quotas, chargeback e APIs validada.
- Advanced services separados do core e confirmados na proposta.
- TCO de 3 a 5 anos incluindo hardware, migração, operação, suporte, câmbio e impostos.
- PoC medindo percentis, falha, manutenção, backup e restore.
- Plano de saída/mobilidade e portabilidade de dados documentado.
Glossário essencial
| Termo | Definição curta |
|---|---|
| ESXi | Hipervisor bare metal da plataforma vSphere. |
| vCenter | Plano central de gestão, inventário e políticas. |
| VCF | VMware Cloud Foundation; plataforma full stack de nuvem privada. |
| VVF | VMware vSphere Foundation; plataforma de workloads / HCI. |
| vSAN | Storage definido por software integrado ao vSphere. |
| NSX | Rede e segurança definidas por software. |
| VKS | vSphere Kubernetes Service. |
| DRS | Distributed Resource Scheduler. |
| HA | High Availability; reinício automático após falha. |
| SPBM | Storage Policy-Based Management. |
| RPO | Perda máxima de dados aceitável. |
| RTO | Tempo máximo para restaurar o serviço. |
| HCL | Lista de compatibilidade de hardware/software. |
| EVC | Compatibilidade de CPU para mobilidade entre hosts. |
| NUMA | Arquitetura de memória não uniforme em servidores multiprocessados. |
Conclusão
ESXi e vCenter continuam sendo a base robusta para virtualização empresarial. O VVF organiza essa base como plataforma moderna de workloads e HCI. O VCF adiciona o modelo operacional de nuvem privada: rede integrada, gestão full stack, lifecycle de frota, automação, autosserviço e governança. A escolha correta não é "qual tem mais recursos", mas qual atende ao operating model, ao risco e ao TCO da organização.
Recomendação prática: para um ambiente tradicional de VMs com equipe central e storage externo, o VVF tende a ser o ponto inicial natural. Para oferecer IaaS interno, múltiplos tenants, Kubernetes, automação end-to-end e rede definida por software, o VCF tende a reduzir integrações manuais — desde que a organização adote processos de plataforma e use essas capacidades.
Fontes oficiais e leitura complementar
Este material foi preparado a partir de fontes oficiais da Broadcom/VMware, com data de corte em 2 de setembro de 2026. Consulte sempre release notes, matrizes de interoperabilidade, o VMware Compatibility Guide, o Product Guide e a proposta comercial vigentes.
- Licensing for VMware Cloud Foundation 9.0
- VMware Cloud Foundation 9.x — Data Sheet
- VMware vSphere Foundation — Data Sheet
- Feature Comparison & Upgrade Paths: VCF and VVF
- Counting Cores for VCF/VVF and TiBs for vSAN — Broadcom KB 313548
- VCF 9.0 Product Subscription and Licensing
- vCenter identity federation with Microsoft Entra ID
- Performance Best Practices for VMware vSphere 8
- Operations in VMware Cloud Foundation 9.0
- Five reasons to upgrade from VVF to VCF
Nota editorial
Nomes, marcas e produtos pertencem aos seus titulares. Os exemplos numéricos de capacidade e desempenho foram organizados para fins didáticos e não constituem cotação, benchmark de laboratório ou aconselhamento de licenciamento — o dimensionamento e a economia finais dependem do hardware real, do SLA e do contrato comercial de cada projeto.
EnQ Digital: Cloud • Data Center • Baremetal • Storage • Suporte • Segurança