
Este material fue creado para profesionales, gestores, emprendedores y equipos de tecnología que quieren comprender la inteligencia artificial de forma didáctica y, al mismo tiempo, entender los requisitos de datos, seguridad e infraestructura necesarios para usar IA en un entorno empresarial.
La historia de la inteligencia artificial: de una pregunta filosófica a una infraestructura global
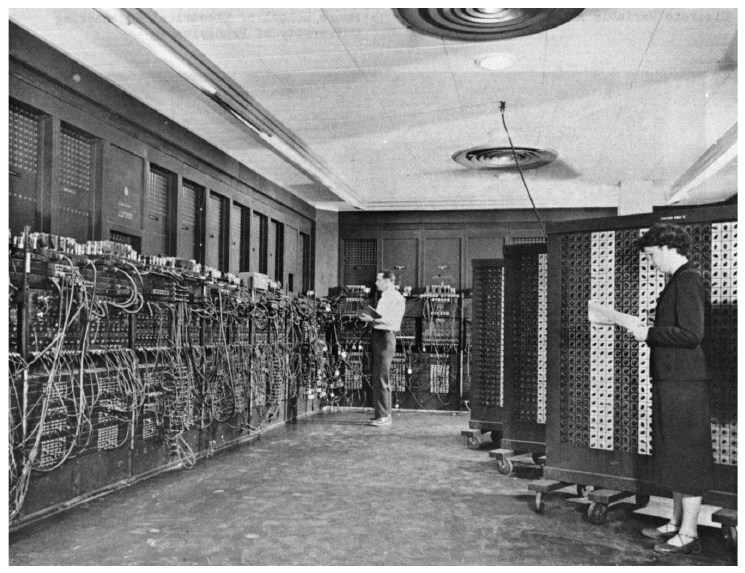
Antes de que existiera el término "inteligencia artificial", científicos ya intentaban transformar el razonamiento en procedimientos formales. La computación electrónica nació en un contexto en el que cálculos militares, lógica matemática y teoría de la información comenzaron a converger. Máquinas como el ENIAC mostraron que operaciones antes dependientes del trabajo humano podían automatizarse a una velocidad inédita, pero programar todavía era un proceso físico y laborioso.
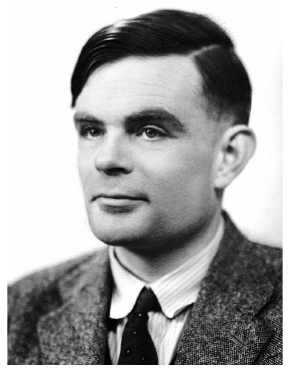
En 1950, Alan Turing publicó "Computing Machinery and Intelligence" y desplazó la discusión de "¿las máquinas realmente piensan?" a una cuestión operativa: ¿podría una máquina comportarse, en una conversación, de forma lo suficientemente convincente como para ser confundida con un ser humano? El llamado juego de la imitación se convirtió en uno de los hitos intelectuales del área.
En 1955, John McCarthy, Marvin Minsky, Nathaniel Rochester y Claude Shannon propusieron un proyecto de verano en Dartmouth. El encuentro de 1956 es ampliamente considerado como el nacimiento de la inteligencia artificial como disciplina. El punto central de la propuesta era ambicioso: aspectos del aprendizaje y de la inteligencia podrían describirse con precisión suficiente para que una máquina los simulara.
A partir de ahí, la IA pasó por ciclos de entusiasmo y frustración. En las décadas de 1960 y 1970 surgieron sistemas simbólicos y experimentos como ELIZA. Cuando las promesas superaron la capacidad de hardware, datos y algoritmos, llegaron los llamados "inviernos de la IA", períodos de reducción de inversión. En los años 1980, los sistemas expertos recuperaron interés al codificar reglas de especialistas humanos para dominios específicos.
En 1997, la supercomputadora Deep Blue, de IBM, venció a Garry Kasparov en una partida de seis juegos. El hito mostró la fuerza de la búsqueda masivamente paralela y del hardware especializado. Todavía no era la IA generativa actual, pero cambió la percepción pública sobre lo que las computadoras podían hacer.
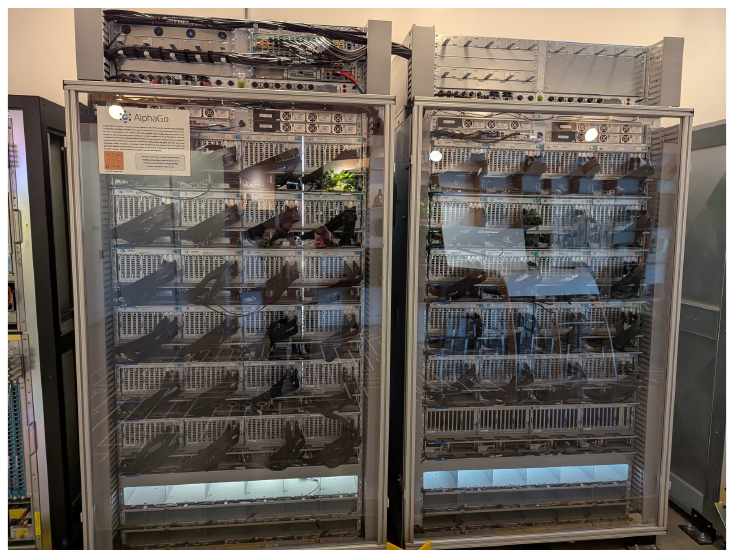
El siguiente giro llegó con datos a escala, GPUs y redes neuronales profundas. En 2012, AlexNet presentó resultados muy superiores en ImageNet y ayudó a consolidar el deep learning como enfoque dominante en visión computacional. En 2016, AlphaGo derrotó a Lee Sedol por 4 a 1 combinando redes neuronales, búsqueda y reinforcement learning, demostrando que los sistemas podían aprender estrategias altamente complejas.
En 2017, el artículo "Attention Is All You Need" presentó la arquitectura Transformer. En lugar de procesar secuencias solo paso a paso, los mecanismos de attention pasaron a relacionar diferentes partes del contexto con gran eficiencia de paralelización. Esta base arquitectónica abrió camino para los grandes modelos de lenguaje modernos.
El 30 de noviembre de 2022, se presentó ChatGPT en formato conversacional y aceleró la adopción pública de la IA generativa. Entre 2023 y 2026, la frontera avanzó hacia modelos multimodales, razonamiento, generación de video, programación y agentes capaces de usar herramientas. La discusión empresarial cambió: ya no es solo "¿qué puede responder la IA?", sino "¿qué procesos puede ejecutar, con qué datos, controles e infraestructura?"
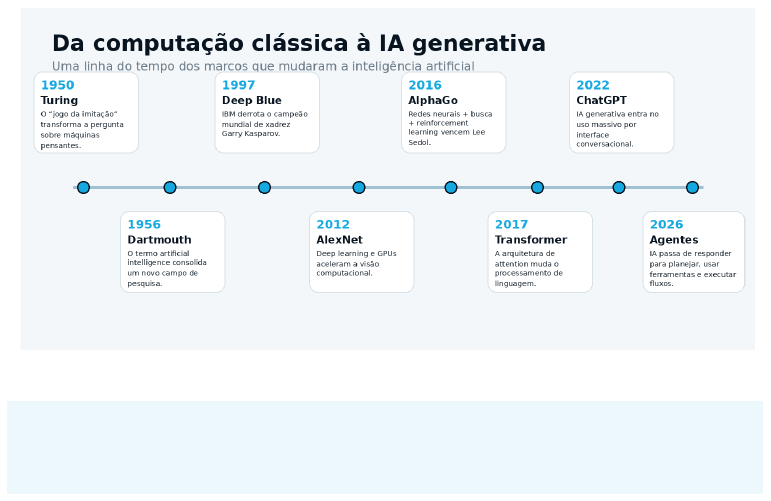
Idea clave: la historia de la IA no es una línea recta. El avance resulta de la combinación de tres factores: mejores algoritmos, más datos y más capacidad computacional. Cuando uno de ellos se queda atrás, el progreso se desacelera.
Del ENIAC a los data centers de IA
El contraste entre las primeras computadoras electrónicas y los clústeres modernos es didáctico. El ENIAC ocupaba salas enteras y se reprogramaba con cables y paneles. Hoy, una infraestructura de IA concentra miles de aceleradores, redes de altísima velocidad y almacenamiento distribuido. La escala física volvió a ser central, ahora para sostener modelos con miles de millones o billones de parámetros y cargas de inferencia continuas.
Qué es la inteligencia artificial, en lenguaje simple
La inteligencia artificial es un campo de la computación dedicado a sistemas capaces de ejecutar tareas que normalmente asociamos con percepción, aprendizaje, razonamiento, predicción, lenguaje, generación de contenido o toma de decisiones. La definición es amplia porque la IA no es un producto único: es una familia de técnicas y arquitecturas.
Un filtro de spam, un sistema de recomendación, un detector de fraude, un modelo que identifica objetos en video y un asistente que escribe un informe pueden todos considerarse aplicaciones de IA, aunque usen tecnologías diferentes.
La distinción más útil para quien está empezando es separar IA, machine learning, deep learning e IA generativa. Machine learning es un subconjunto de la IA en el que los modelos aprenden patrones a partir de datos. Deep learning es un subconjunto del machine learning basado en redes neuronales con varias capas. La IA generativa es una clase de sistemas, frecuentemente basados en deep learning, entrenados para crear contenido nuevo.
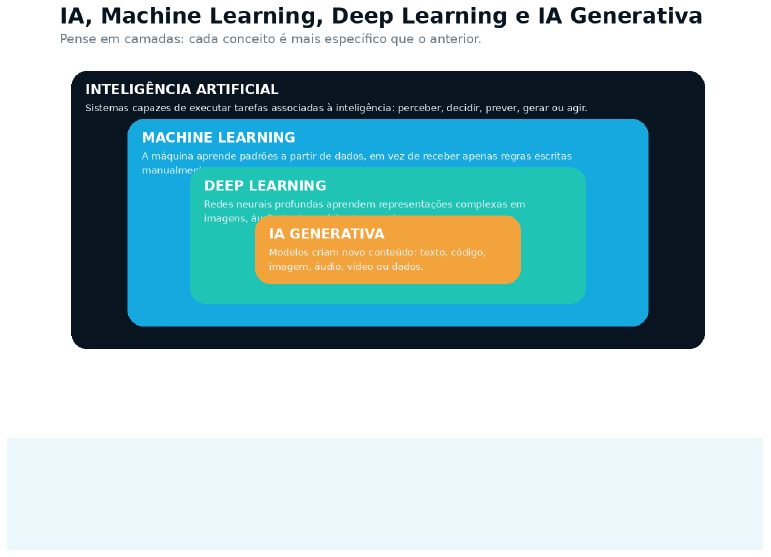
No confunda automatización con IA: una automatización puede seguir reglas fijas sin aprender nada. La IA se vuelve relevante cuando el sistema necesita reconocer patrones, manejar incertidumbre, interpretar lenguaje o generar respuestas. Muchas soluciones empresariales combinan ambas cosas.
Cómo aprenden las máquinas: datos, entrenamiento e inferencia
En la programación tradicional, el desarrollador escribe reglas explícitas y el software aplica esas reglas a los datos. En machine learning, proporcionamos ejemplos y un algoritmo ajusta parámetros para reducir errores. El resultado de ese proceso es un modelo.
El entrenamiento es la etapa en la que el modelo ajusta sus parámetros. La inferencia, en cambio, es el momento en que un modelo entrenado recibe un dato nuevo y produce una predicción, clasificación, recomendación o generación. Esa diferencia tiene impacto directo en infraestructura: el entrenamiento suele demandar grandes bloques de GPU y largos períodos de computación; la inferencia puede variar desde una CPU hasta clústeres de aceleradores, dependiendo del tamaño del modelo y de la latencia deseada.
Tres paradigmas aparecen con frecuencia. En el aprendizaje supervisado, cada ejemplo tiene una etiqueta y el modelo aprende a asociar entrada y salida. En el no supervisado, el sistema busca estructura en datos sin etiquetas explícitas. En el reinforcement learning, un agente aprende por ensayo y error a maximizar recompensas.
En la práctica empresarial, el ciclo de ML incluye recolección de datos, tratamiento, división entre entrenamiento y prueba, entrenamiento, validación, implementación y monitoreo. Los modelos se degradan cuando el comportamiento del mundo cambia, fenómeno conocido como drift. Por eso, la IA en producción es una disciplina operativa continua, no un proyecto que termina en el primer despliegue.
Ejemplo didáctico — predicción de churn: una operadora puede entrenar un modelo con historial de consumo, llamadas, pagos y cancelaciones. El objetivo no es "adivinar" aleatoriamente, sino aprender patrones asociados a clientes que cancelaron. En la inferencia, el modelo calcula la probabilidad de churn para clientes activos. El valor surge cuando esa predicción se integra a una acción: oferta, atención o intervención comercial.
Redes neuronales y deep learning: por qué dieron un salto
Las redes neuronales artificiales son modelos compuestos por unidades matemáticas organizadas en capas. Cada conexión lleva pesos que se ajustan durante el entrenamiento. Cuanto más profundas y adecuadas al problema sean las arquitecturas, mayor la capacidad de aprender representaciones complejas.
El avance del deep learning no ocurrió por una única invención. Las GPUs permitieron ejecutar muchas operaciones en paralelo; las grandes bases de datos proporcionaron ejemplos; nuevas técnicas de entrenamiento mejoraron la estabilidad y la generalización; y las bibliotecas de software democratizaron el desarrollo.
Las Convolutional Neural Networks ganaron destaque en imágenes. Las redes recurrentes y sus variantes fueron importantes para secuencias. Los Transformers se volvieron dominantes en lenguaje y se expandieron a visión, audio y multimodalidad. El principio común es aprender representaciones directamente de los datos, reduciendo la necesidad de especificar manualmente todas las características relevantes.
¿Por qué GPU? Entrenar redes neuronales exige un enorme volumen de multiplicaciones de matrices. Las GPUs fueron diseñadas para computación altamente paralela y por eso se convirtieron en la base de muchas cargas de IA. La elección entre GPU, CPU u otros aceleradores depende del modelo, presupuesto, latencia y escala.
IA generativa y LLMs: cómo funciona la nueva generación
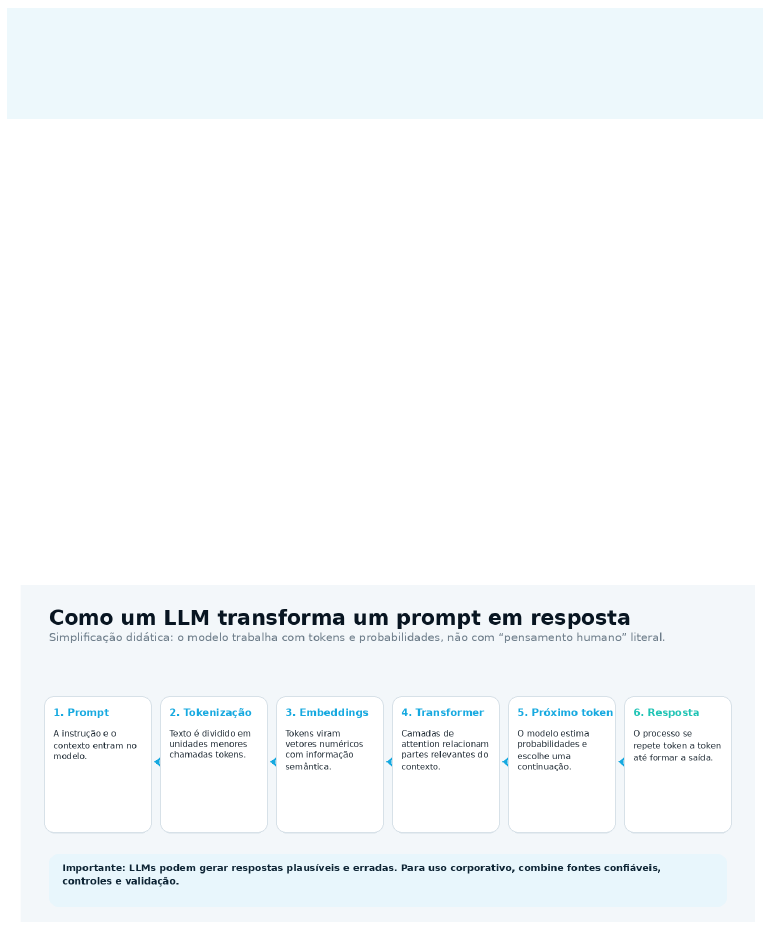
La IA generativa crea nuevos contenidos con base en patrones aprendidos. En los modelos de lenguaje, el mecanismo fundamental es predecir secuencias de tokens condicionadas al contexto anterior. Esta descripción parece simple, pero los modelos a gran escala aprenden regularidades de lenguaje, conocimiento factual, estructuras de código y relaciones semánticas capaces de soportar tareas muy diferentes.
Los tokens son unidades en que se divide el texto. Los embeddings representan tokens o fragmentos como vectores numéricos. El Transformer aplica mecanismos de attention para calcular qué partes del contexto son más relevantes en cada etapa. El modelo entonces estima la distribución de probabilidad del próximo token y repite el proceso hasta formar la respuesta.
Un LLM no es una base de datos tradicional. Comprime patrones en parámetros y puede producir información plausible que no corresponde con la realidad. Esto explica las "alucinaciones". Cuanto mayor sea la criticidad de la tarea, más importante es limitar fuentes, exigir evidencias, registrar decisiones y mantener validación humana cuando sea necesario.
El contexto es otro concepto esencial. Cada modelo posee una ventana de contexto que determina cuánto contenido puede considerar en una interacción. Contextos más grandes ayudan en documentos largos, pero no eliminan la necesidad de arquitectura. Volcar todo el acervo corporativo dentro del prompt es caro, lento e inseguro; RAG y las herramientas de búsqueda seleccionan solo lo que importa.
Un buen prompt define objetivo, contexto, restricciones, formato y criterios de calidad. En aplicaciones profesionales, el prompt es solo una capa. La calidad también depende del modelo, de los datos, de las herramientas, de la orquestación y de las pruebas.
¿Fine-tuning o RAG? RAG es apropiado cuando el problema principal es traer conocimiento actualizado y rastreable. El fine-tuning es más útil para alterar comportamiento, estilo, formato o desempeño en un dominio. Muchas arquitecturas combinan ambos.
RAG: IA conectada a los datos de la empresa
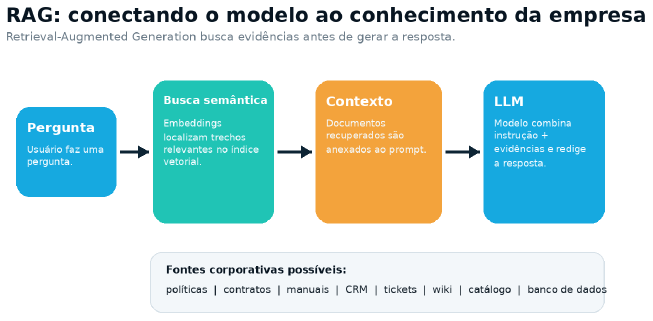
RAG, sigla de Retrieval-Augmented Generation, añade una etapa de recuperación de información antes de la generación. Cuando el usuario pregunta, la aplicación busca fragmentos relevantes en fuentes autorizadas y envía esas evidencias al modelo. La respuesta puede entonces redactarse con base en contenido corporativo actualizado.
Una implementación típica comienza por la ingestión de documentos, limpieza, división en chunks, generación de embeddings e indexación en un motor de búsqueda vectorial o híbrido. En la consulta, la pregunta también se transforma en embedding, el sistema recupera candidatos, aplica filtros y eventualmente un reranker, y solo entonces monta el contexto final para el LLM.
RAG mejora la trazabilidad y la actualización, pero no es garantía automática de verdad. El retrieval puede recuperar el documento equivocado, perder un fragmento importante o exponer contenido sin autorización. Los sistemas maduros aplican control de acceso a nivel de la fuente, metadatos, filtros, citas, evaluación y logs.
Ejemplo empresarial: un asistente interno puede responder "¿cuál es la política de backup para este tipo de ambiente?" buscando la versión vigente del documento, citando el fragmento utilizado y respetando los permisos del usuario. Eso es muy diferente de depender solo de la memoria general del modelo.
Agentes de IA: de la respuesta a la ejecución
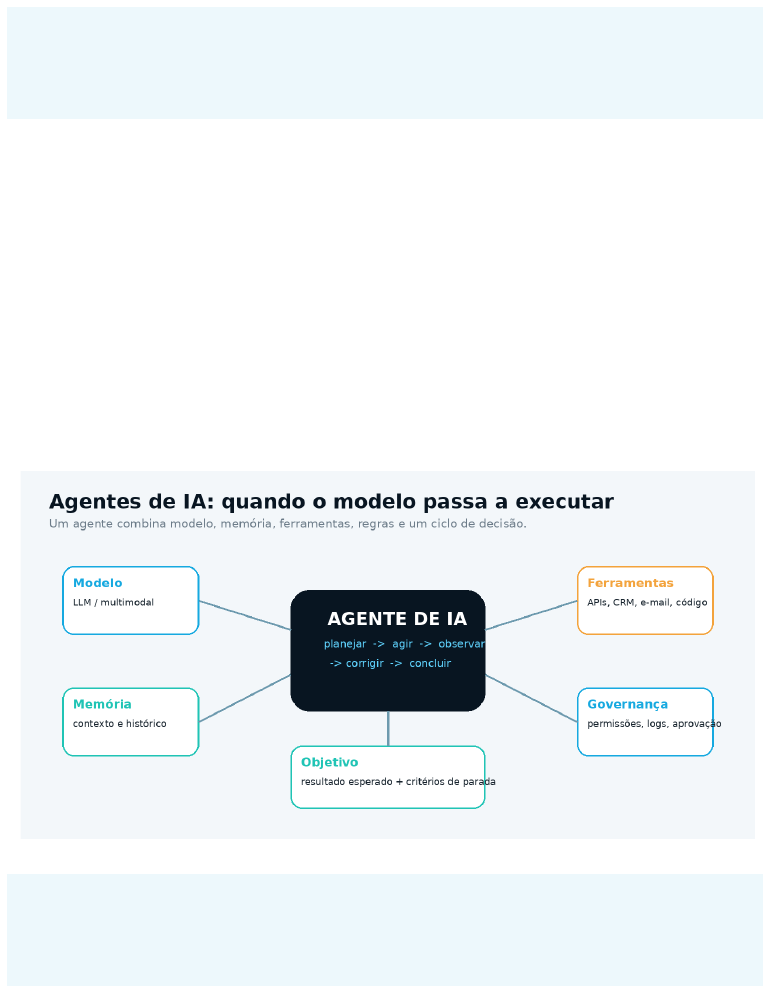
Los agentes de IA amplían el papel de un modelo. En lugar de solo producir texto, un agente recibe un objetivo, planea pasos, llama herramientas, observa resultados y decide qué hacer a continuación. Las herramientas pueden incluir APIs, bases de datos, CRM, ITSM, navegadores, repositorios de código, hojas de cálculo o sistemas internos.
Esta capacidad hace que los agentes sean atractivos para procesos con múltiples etapas: calificar leads, consolidar datos de cuentas, preparar propuestas, clasificar tickets, investigar incidentes, generar código, validar documentación o ejecutar rutinas controladas. Pero la autonomía exige una gobernanza proporcional.
Cuanto mayor el poder de acción, mayor el riesgo de error. Un agente con permiso de lectura presenta un perfil de riesgo diferente de un agente capaz de borrar datos, aprobar pagos o alterar infraestructura. El diseño correcto incluye menor privilegio, límites de acción, validación de parámetros, aprobaciones humanas, logs y mecanismos de rollback.
Regla de oro: la autonomía debe conquistarse por evidencia. Comience con "asistir", evolucione a "recomendar", luego "ejecutar con aprobación" y solo entonces evalúe la ejecución autónoma en tareas de bajo riesgo y alta observabilidad.
Dónde genera valor la IA en las empresas
El mejor proyecto de IA no comienza con la pregunta "¿qué modelo usar?", sino con "¿qué proceso queremos mejorar y cómo lo vamos a medir?". Los casos de uso de alto valor generalmente combinan volumen, repetición, datos disponibles e impacto económico.
En atención, la IA puede clasificar contactos, resumir historial, sugerir respuestas y recuperar políticas. En ventas, puede investigar cuentas, enriquecer el CRM, preparar seguimientos y priorizar oportunidades. En operaciones, puede resumir incidentes, correlacionar alarmas y acelerar el troubleshooting. En desarrollo, puede generar, revisar y probar código. En documentos, puede extraer campos, comparar cláusulas y producir síntesis.
En el entorno de data center y cloud, la IA puede apoyar la planificación de capacidad, predicción de fallas, análisis de logs, detección de anomalías, optimización energética, NOC asistido y atención técnica. La ganancia es mayor cuando la IA está conectada a datos operativos confiables y a workflows existentes.
| Área | Caso de uso | Arquitectura típica | Indicador de valor |
|---|---|---|---|
| Atención | Respuesta asistida con base en políticas | LLM + RAG + CRM | tiempo medio, resolución, calidad |
| Ventas | Investigación y preparación de oportunidades | Agente + CRM + fuentes autorizadas | tiempo por cuenta, conversión, pipeline |
| Operaciones TI | Resumen y triaje de incidentes | LLM + logs + ITSM + reglas | MTTR, backlog, precisión |
| Documentos | Extracción y comparación | Multimodal/OCR + LLM + validación | tiempo, error, productividad |
| Ingeniería | Copiloto de código y pruebas | LLM + repositorio + CI/CD controlado | lead time, bugs, cobertura |
| Data Center/NOC | Anomalías y correlación operativa | ML temporal + agente + observabilidad | incidentes, disponibilidad, energía |
Infraestructura para IA: GPU, storage, red y data center
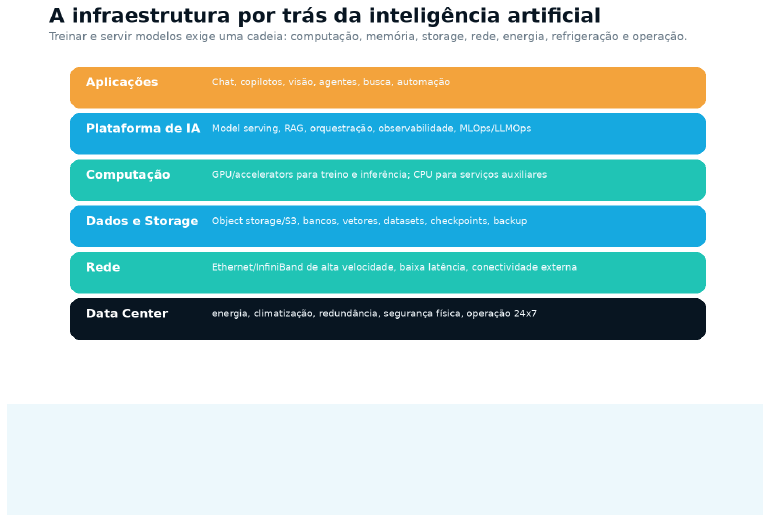
La IA es software, pero la experiencia del usuario está limitada por la infraestructura física. Los modelos grandes exigen computación acelerada, memoria de alto ancho de banda, storage capaz de alimentar datasets y checkpoints, red con baja latencia y operación eléctrica y térmica consistente.
El dimensionamiento comienza por el tipo de carga. El entrenamiento de modelos desde cero es el escenario más intensivo y raramente es necesario para una empresa común. El fine-tuning puede exigir uno o pocos nodos, dependiendo del modelo y de la técnica. La inferencia puede ejecutarse en GPU dedicada, GPU compartida, aceleradores en cloud o incluso CPU para modelos compactos.
Además del acelerador, la memoria es crítica. Si el modelo no cabe en la memoria disponible, puede ser necesario cuantizar, distribuir entre GPUs o elegir un modelo más pequeño. El storage también influye en el ciclo: datasets, embeddings, artefactos, logs y checkpoints crecen rápidamente. El object storage compatible con S3 es especialmente útil para datasets y artefactos a escala.
La red se convierte en un cuello de botella cuando varias GPUs trabajan en conjunto. Para clústeres de entrenamiento, el ancho de banda y la latencia entre aceleradores son determinantes. En inferencia empresarial, la conectividad entre aplicación, datos y modelo también afecta la experiencia final.
Por último, energía, refrigeración, seguridad física y disponibilidad son parte del proyecto. Los servidores de alta densidad pueden exigir potencias por rack muy superiores a las de ambientes tradicionales. Los data centers preparados para cargas de IA necesitan evaluar densidad, redundancia, refrigeración y expansión.
¿Cloud, on-premises o híbrido?
No existe una respuesta universal. El cloud acelera la experimentación y la elasticidad. El on-premises o bare metal puede ofrecer previsibilidad, control y economía en cargas constantes. Las arquitecturas híbridas son comunes cuando los datos sensibles permanecen privados y los picos o modelos específicos usan capacidad externa.
LLM as a Service (LLMaaS)
LLMaaS ofrece modelos por API o endpoint gestionado, evitando que cada empresa monte toda la capa de serving. Para clientes corporativos, los criterios más relevantes incluyen aislamiento, privacidad, SLA, elección de modelos, control de costos, observabilidad y residencia de los datos.
Bare metal para IA
Los servidores bare metal tienen sentido cuando la carga exige acceso directo al hardware, alta utilización, configuraciones específicas o previsibilidad de desempeño. El modelo económico debe comparar costo total, ocupación real, energía, soporte y ciclo de actualización.
Storage S3 e IA
Datasets, documentos, imágenes, audio, checkpoints y artefactos pueden almacenarse como objetos. La arquitectura debe planificar versionado, cifrado, políticas de retención, throughput y costo de movimiento de datos.
Seguridad, privacidad y gobernanza de IA
Una política de IA corporativa necesita tratar datos, modelos, usuarios, herramientas y decisiones. El riesgo no está solo en el modelo: surge de toda la cadena. Datos sensibles pueden enviarse a un endpoint inadecuado; un RAG puede ignorar permisos; un agente puede ejecutar una acción indebida; un prompt malicioso puede intentar desviar instrucciones.
La clasificación de datos es el primer control. La organización debe definir qué puede enviarse a servicios externos, qué necesita permanecer en un ambiente privado y qué información exige anonimización o enmascaramiento. Contratos, retención y finalidad de uso también deben evaluarse.
El prompt injection es una clase de ataque en la que contenido de usuario o documento intenta alterar el comportamiento del sistema. En agentes, esto puede llevar a llamadas de herramientas no deseadas. La defensa incluye separación de instrucciones, allowlists de herramientas, validación de argumentos, least privilege, confirmación de acciones críticas y sanitización de contenido.
Las alucinaciones son un riesgo de calidad y seguridad. Reducir la temperatura no resuelve todo. Las respuestas críticas deben fundamentarse en fuentes, evaluarse mediante reglas o modelos de validación y, cuando sea necesario, someterse a revisión humana.
La observabilidad es indispensable. Registre prompts y respuestas conforme a la política de privacidad, fuentes recuperadas, herramientas llamadas, latencia, costo, errores y feedback. Sin telemetría, es difícil saber si un sistema de IA mejoró el proceso o solo añadió complejidad.
LGPD e IA: en Brasil, los proyectos de IA que tratan datos personales deben diseñarse en conjunto con los principios y obligaciones aplicables de la LGPD. Esta guía es educativa y no sustituye el análisis jurídico o de privacidad específico para cada caso.
- Control de identidad y acceso para usuarios, modelos y herramientas.
- Cifrado en tránsito y en reposo; gestión segura de secretos y claves.
- Filtrado y clasificación de datos antes del envío al modelo.
- RAG con control de acceso en la fuente y segregación por tenant o perfil.
- Logs y pistas de auditoría para acciones de agentes.
- Evaluación continua de calidad, seguridad, bias y regresiones.
- Human-in-the-loop para decisiones financieras, legales, de infraestructura o de alto impacto.
- Plan de incidentes específico para aplicaciones de IA.
Cómo implementar IA en la empresa sin transformar la PoC en un proyecto infinito
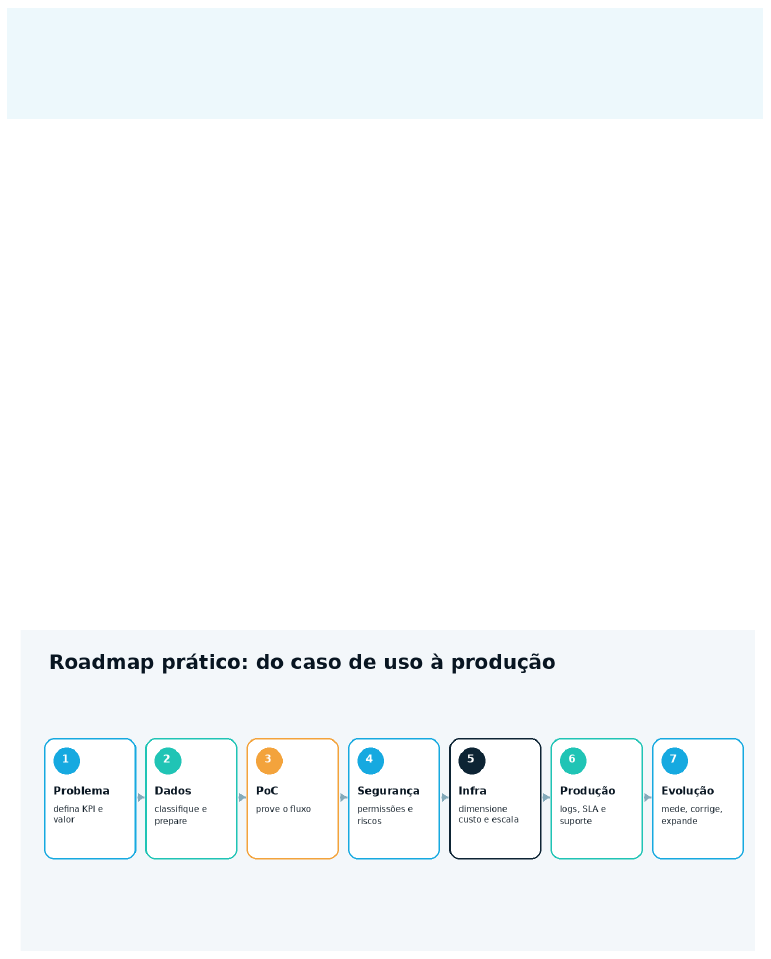
Muchas iniciativas de IA fallan no porque el modelo sea incapaz, sino porque el problema fue mal definido. Una PoC debe existir para probar hipótesis específicas: calidad mínima, integración, latencia, costo, seguridad e impacto operativo.
Comience con un proceso que tenga dueño, datos y métrica. Diseñe una línea base humana o del sistema actual. Luego, construya un conjunto de pruebas representativo antes de elegir el proveedor final. Esto evita medir la calidad solo con algunas demostraciones impresionantes.
Al pasar a producción, reevalúe infraestructura, gobernanza, soporte, observabilidad y recuperación. Un prototipo en notebook no es una arquitectura operativa. Para sistemas críticos, defina SLO/SLA, capacidad, contingencia, versionado de prompts/modelos y criterios de rollback.
Checklist antes de escalar un proyecto de IA:
- ¿El problema y el KPI están claros?
- ¿Existen datos suficientes y legalmente utilizables?
- ¿Los permisos están definidos?
- ¿Hay un conjunto de pruebas representativo?
- ¿La solución tiene observabilidad?
- ¿El costo por transacción es aceptable?
- ¿Existe un plan para fallas, indisponibilidad y rollback?
- ¿Un responsable de negocio aprueba el resultado?
El panorama de la IA en 2026: escala, agentes e infraestructura
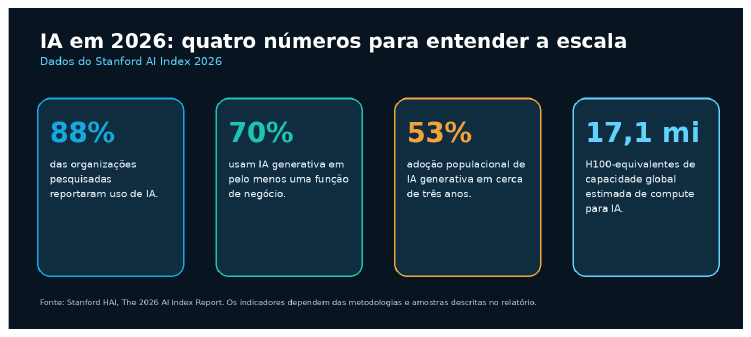
El Stanford AI Index 2026 muestra que la adopción organizacional sigue creciendo y que la IA generativa ya aparece en funciones de negocio de una gran parte de las organizaciones encuestadas. Al mismo tiempo, el informe destaca el aumento de la inversión, la expansión acelerada de la capacidad computacional y una mayor atención a la gobernanza.
Este panorama sugiere un cambio de madurez. La primera fase de la IA generativa estuvo dominada por chats generalistas. La segunda está siendo definida por la integración: modelos conectados a datos, herramientas, sistemas corporativos e infraestructura optimizada para costo y latencia.
Los agentes todavía están en fase inicial en muchas funciones de negocio, lo cual es importante: las expectativas deben calibrarse. Hay valor real, pero los sistemas autónomos necesitan probar confiabilidad. La ventaja competitiva tiende a migrar del acceso al mismo modelo hacia la calidad de los datos, la integración, los procesos, la experiencia, la seguridad y la operación.
Para empresas de infraestructura digital, esto crea una oportunidad directa. La IA aumenta la demanda de capacidad computacional, storage, conectividad, energía, resiliencia y servicios gestionados. En otras palabras: el crecimiento de la IA también es un crecimiento de la infraestructura necesaria para sostenerla.
Cómo puede EnQ Digital apoyar un recorrido de IA
Una estrategia de IA empresarial necesita conectar aplicación e infraestructura. EnQ Digital actúa en infraestructura digital con soluciones de Data Center, Cloud Virtual, Bare Metal, storage compatible con S3, conectividad y servicios asociados. Esto permite diseñar ambientes para aplicaciones tradicionales y cargas emergentes de inteligencia artificial.
Para un proyecto de IA, la discusión puede comenzar por el workload: tamaño del modelo, volumen de documentos, cantidad de usuarios, latencia, disponibilidad, privacidad y costo esperado. A partir de ahí, es posible evaluar una arquitectura en cloud, bare metal, data center o híbrida.
El punto de partida no necesita ser un clúster gigantesco. Muchas empresas generan valor con modelos existentes, RAG y agentes conectados a sus datos. La infraestructura debe crecer conforme a la demanda y la criticidad del proceso.
- Cloud Virtual para aplicaciones, APIs, bases de datos y componentes de orquestación.
- Bare Metal dedicado para workloads que requieren desempeño previsible y acceso directo al hardware.
- Storage S3 para datos, documentos, artefactos, backups y datasets.
- Data Center y colocation para ambientes de misión crítica y expansión de capacidad.
- Conectividad y seguridad para integrar usuarios, datos y servicios de IA.
Glosario esencial de IA
| Término | Definición |
|---|---|
| Agente de IA | Sistema que usa un modelo para planificar y ejecutar acciones con herramientas. |
| Algoritmo | Procedimiento o conjunto de reglas para resolver un problema. |
| API | Interfaz usada para que los sistemas intercambien comandos y datos. |
| Attention | Mecanismo que pondera relaciones entre diferentes partes de un contexto. |
| Chunk | Fragmento en que se divide un documento para indexación y recuperación. |
| Context window | Cantidad máxima de tokens que un modelo considera en una interacción. |
| Deep Learning | Machine learning basado en redes neuronales profundas. |
| Embedding | Representación vectorial que captura relaciones semánticas. |
| Fine-tuning | Ajuste adicional de un modelo para un comportamiento o dominio específico. |
| GPU | Procesador altamente paralelo usado en muchas cargas de IA. |
| Hallucination | Salida plausible, pero incorrecta o sin respaldo en una fuente confiable. |
| Inference | Uso de un modelo entrenado para producir una salida nueva. |
| LLM | Large Language Model, modelo de lenguaje de gran escala. |
| LLMOps | Prácticas de operación, evaluación, observabilidad y gobernanza de LLMs. |
| Machine Learning | Métodos en los que los modelos aprenden patrones a partir de datos. |
| Model serving | Capa que pone a disposición un modelo para recibir solicitudes. |
| Multimodal | Modelo capaz de trabajar con más de una modalidad, como texto e imagen. |
| Prompt | Instrucción y contexto enviados a un modelo generativo. |
| Prompt injection | Intento de alterar o desviar instrucciones del sistema mediante contenido malicioso. |
| Quantization | Reducción de la precisión numérica para disminuir memoria y costo computacional. |
| RAG | Arquitectura que recupera fuentes relevantes antes de generar una respuesta. |
| Reranker | Componente que reorganiza resultados recuperados para mejorar la relevancia. |
| Reinforcement Learning | Aprendizaje por ensayo y error con recompensas. |
| S3/Object Storage | Almacenamiento de objetos útil para documentos, datasets y artefactos. |
| Token | Unidad en que se representa el texto para su procesamiento por un modelo. |
| Transformer | Arquitectura basada en attention, central en muchos modelos modernos. |
| Vector database | Sistema optimizado para almacenar y buscar vectores/embeddings. |
Preguntas frecuentes
¿Qué es la inteligencia artificial?
Es el campo que desarrolla sistemas capaces de ejecutar tareas asociadas a percepción, lenguaje, aprendizaje, predicción, generación o decisión. IA es el campo amplio. Machine learning es un enfoque dentro de la IA en el que los modelos aprenden patrones a partir de datos.
¿Qué es la IA generativa?
Es la clase de sistemas que crea nuevo contenido, como texto, código, imagen, audio o video, con base en patrones aprendidos.
¿Qué es un LLM?
Es un gran modelo de lenguaje entrenado para procesar y generar secuencias de lenguaje. Muchos asistentes conversacionales actuales usan LLMs.
¿Qué es RAG en inteligencia artificial?
RAG es una arquitectura que busca información en fuentes externas y envía los fragmentos relevantes al modelo antes de la generación de la respuesta.
¿Qué son los agentes de IA?
Son sistemas que combinan modelos con herramientas, memoria y reglas para ejecutar tareas en múltiples etapas.
¿Una empresa necesita entrenar su propio modelo?
En la mayoría de los casos, no. Los modelos existentes, combinados con RAG, fine-tuning o herramientas, atienden gran parte de las necesidades empresariales.
¿La IA necesita GPU?
No siempre. Los modelos más pequeños pueden ejecutarse en CPU. Los modelos grandes, la baja latencia y el alto volumen frecuentemente se benefician de GPUs o aceleradores.
¿Cloud o bare metal es mejor para IA?
Depende del perfil de la carga. El cloud favorece la elasticidad; el bare metal puede favorecer el control y la previsibilidad; las arquitecturas híbridas combinan ambos.
¿Cómo proteger los datos al usar IA?
Clasifique los datos, defina proveedores y ambientes permitidos, aplique cifrado, control de acceso, logs, segregación de datos y validación de respuestas.
¿Cuál es el primer proyecto de IA para una empresa?
Comience por un problema repetitivo y medible, con datos disponibles y bajo riesgo operativo. Defina el KPI antes de construir la PoC.
¿Cómo medir el retorno de un proyecto de IA?
Compare la solución con la línea base usando métricas como tiempo, costo, conversión, error, satisfacción, MTTR, disponibilidad o volumen procesado.
Fuentes
- Alan M. Turing, Computing Machinery and Intelligence, Mind, 1950.
- McCarthy, Minsky, Rochester y Shannon, A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence, 1955.
- Krizhevsky, Sutskever y Hinton, ImageNet Classification with Deep Convolutional Neural Networks, NeurIPS 2012.
- Vaswani et al., Attention Is All You Need, 2017.
- Google DeepMind, AlphaGo.
- OpenAI, Introducing ChatGPT, 30 nov. 2022.
- Stanford HAI, The 2026 AI Index Report.
Nota editorial: este material es informativo. Los números de mercado y las referencias reflejan las fuentes consultadas y deben revisarse periódicamente, ya que el sector de la inteligencia artificial cambia rápidamente.