
Un NVIDIA Vera Rubin NVL72 no es solo un rack de GPUs de altísima densidad. Es el núcleo de una AI Factory: una plataforma que convierte grandes volúmenes de datos y energía eléctrica en entrenamiento de modelos, inferencia, razonamiento de IA, simulación científica y resultados de negocio a escala. Esta guía recorre la cadena completa de decisiones — desde el business case hasta el dimensionamiento térmico e hidráulico, la selección de CDU, la puesta en marcha y la operación.
El encadenamiento es siempre el mismo: la demanda define la escala; la escala define potencia y carga térmica; la carga térmica define caudal, ΔT y ΔP; y el ΔP define la bomba, la CDU y la planta hidráulica. Saltarse una etapa transfiere incertidumbre a la obra, donde la corrección cuesta más y compromete el plazo.
Sobre este material: las cifras aquí son referencias públicas de plataforma y de pre-proyecto. NVIDIA aún clasifica varias especificaciones de Rubin como preliminares. El Reference Design y la Site Planning Guide de la configuración efectivamente adquirida deben prevalecer sobre cualquier cálculo preliminar de este texto.
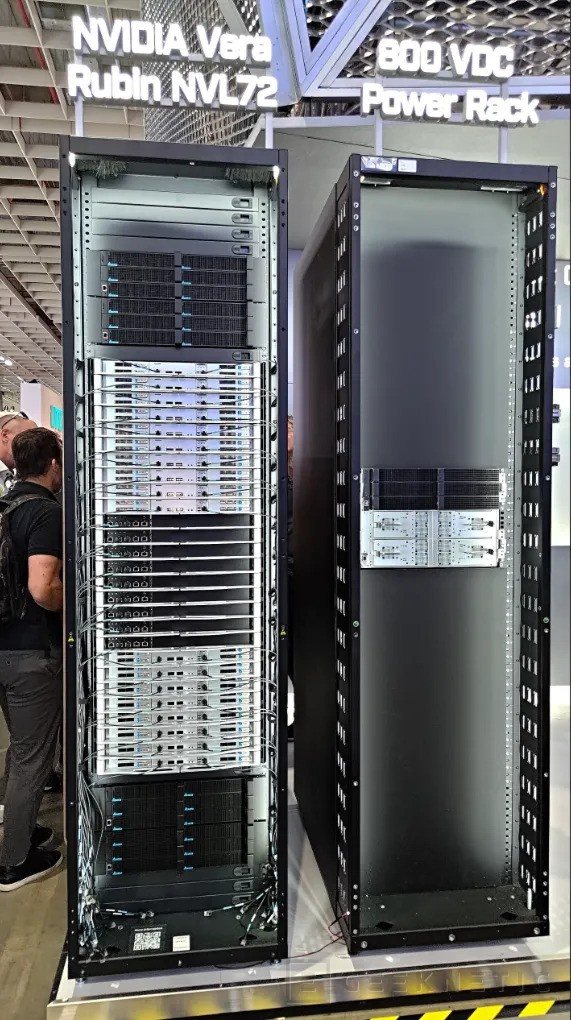
Resumen ejecutivo
Cada parte responde a una decisión específica. Los gestores empiezan por las tres primeras líneas; la ingeniería avanza por las disciplinas técnicas; la operación se concentra en la puesta en marcha, la telemetría y los indicadores; compras usa las matrices y el RFI para estructurar la cotización, la equalización técnica y la aceptación.
| Parte | Contenido | Decisión principal |
|---|---|---|
| Business case | Cuándo se justifica una AI Factory | ¿Construir, alquilar GPU en la nube o híbrido? |
| Aplicaciones | Sectores, workloads y objetivos | ¿Qué carga ocupará el clúster? |
| Casos reales | Blackwell GB200/GB300 en producción | ¿Qué modelo económico ya fue validado? |
| Arquitectura | Rubin GPU, Vera CPU, HBM4, NVLink 6 | ¿Qué entrega el rack como sistema? |
| Cooling | DLC, FWS, CDU, TCS y 45 °C | ¿Cómo sale el calor del chip hasta la atmósfera? |
| Dimensionamiento | kW, LPM, m³/h, ΔT, ΔP y Pump Head | ¿Qué caudal y qué presión exige el proyecto? |
| Selección de CDU | Criterios, marketplace DSX y fabricantes | ¿Qué CDU atiende al operating point real? |
| Eléctrica | Cabinet TDP, kVA y consumo | ¿Cuánta potencia y energía reservar? |
| Operación | BMS, puesta en marcha, riesgos y RFI | ¿Cómo demostrar y sostener el desempeño? |
Por qué construir una supercomputadora de esta clase
El objetivo central es reducir drásticamente el tiempo para entrenar, ajustar y ejecutar modelos y simulaciones que serían impracticables en infraestructura convencional — preservando baja latencia entre GPUs, gran memoria agregada y alta eficiencia por unidad de trabajo. El valor no está solo en los FLOPS.
- Time-to-solution: reducir semanas o meses de entrenamiento y simulación a días u horas.
- Modelos más grandes: entrenar, ajustar y servir LLMs, modelos multimodales y Mixture-of-Experts con cientos de miles de millones o billones de parámetros.
- Razonamiento a escala: sostener inferencia con long context, agentes y cadenas de razonamiento que consumen mucho más cómputo que un chatbot tradicional.
- Soberanía y privacidad: mantener datos, modelos y propiedad intelectual dentro de infraestructura controlada por la organización o por el país.
- Convergencia AI + HPC: usar la misma fábrica para IA, análisis masivo de datos, simulación numérica y workloads científicos.
- Economía por token: en cargas grandes y continuas, el desempeño por watt, la utilización y la velocidad de comunicación determinan el TCO.
- Monetización: proveedores de nube y data centers pueden transformar la infraestructura en GPU-as-a-Service, training-as-a-service e inference-as-a-service.
Cuándo tiene sentido — y cuándo no
Un clúster NVL72 se justifica cuando existe demanda sostenida por computación paralela, grandes datasets, fuerte comunicación GPU-GPU, necesidad de baja latencia, soberanía de datos o volumen de inferencia suficiente para amortizar la infraestructura. Para proyectos pequeños, experimentales o con utilización esporádica, la nube pública o clústeres más pequeños tienden a presentar mejor relación económica.
| Indicador | Señal de que una AI Factory puede tener sentido |
|---|---|
| Entrenamiento | Modelos propietarios grandes, entrenamiento recurrente o fine-tuning continuo. |
| Inferencia | Miles de millones de tokens/día, baja latencia y agentes ejecutando flujos complejos. |
| Datos | Petabytes o datasets estratégicos que no deben salir del dominio controlado. |
| HPC | Simulaciones altamente paralelas: CFD, FEA, clima, dinámica molecular o seismic. |
| Negocio | Capacidad usada continuamente o revendida como servicio de GPU/IA. |
| Soberanía | Requisitos de residencia de datos, seguridad, compliance o propiedad intelectual. |
Para qué áreas la plataforma es útil
La misma infraestructura atiende IA generativa y HPC. La ganancia aparece principalmente cuando el problema puede paralelizarse y exige gran ancho de banda de memoria y comunicación entre aceleradores.
| Área | Workloads típicos | Objetivo |
|---|---|---|
| AI Labs / LLM | Foundation models, MoE, multimodal, reasoning, fine-tuning y RL. | Crear modelos propietarios y reducir tiempo de entrenamiento. |
| Cloud / Data Center | GPUaaS, bare metal GPU, inference endpoints, clústeres dedicados. | Monetizar capacidad y atender clientes de IA/HPC. |
| Bancos y finanzas | Fraude, AML, riesgo, pricing, modelos tabulares, agentes y análisis documental. | Procesar grandes bases y ejecutar IA privada con baja latencia. |
| Salud y life sciences | Drug discovery, dinámica molecular, genómica, protein design e imagen médica. | Reducir ciclos de investigación y probar más hipótesis. |
| Industria e ingeniería | CFD, FEA, digital twins, generative engineering, robótica y visión industrial. | Disminuir la prototipación física y acelerar la optimización. |
| Energía, petróleo y gas | Seismic imaging, reservoir simulation, optimización de red y mantenimiento predictivo. | Aumentar resolución y reducir tiempo de decisión operativa. |
| Clima y medio ambiente | Weather forecasting, climate modeling y asimilación de datos. | Ejecutar previsiones más rápidas y de mayor resolución. |
| Telecom | Planificación de RF, optimización de red, IA para NOC y modelos de tráfico. | Automatizar la operación y predecir congestiones y fallos. |
| Gobierno / Sovereign AI | LLMs nacionales, investigación, defensa cibernética y servicios públicos. | Preservar la soberanía de datos y la capacidad estratégica de IA. |
| Cybersecurity | Detección a gran escala, análisis de malware y SOC con agentes. | Correlacionar grandes volúmenes de telemetría y acelerar la respuesta. |
| Medios y contenido | Generación de video, imagen, audio, traducción y renderizado neural. | Producir contenido multimodal a gran escala. |
| Investigación científica | Física, química, materiales, astronomía, bioinformática y métodos híbridos. | Explorar espacios de solución antes inviables por costo computacional. |
Ejemplo práctico: una institución puede usar el mismo clúster durante el día para inferencia y agentes corporativos y, en ventanas planificadas, asignar miles de GPUs para entrenamiento, simulación o procesamiento científico vía Kubernetes/Slurm. El valor proviene de la utilización compartida y de la capacidad de orquestar workloads distintos.
Casos reales con Blackwell B200 y GB200 NVL72
Los sistemas Blackwell anteriores a Rubin ya demuestran cómo se utiliza una AI Factory en producción. Estos casos ayudan a entender el tipo de workload y el modelo económico que Vera Rubin tiende a ampliar.
Nomenclatura: B200 y B300 se refieren a las generaciones de GPU Blackwell y Blackwell Ultra. GB200 y GB300 combinan Grace CPU + Blackwell GPU en el Superchip y, en el NVL72, forman el sistema rack-scale con 72 GPUs.
| Caso | Sistema | Qué demuestra |
|---|---|---|
| CoreWeave | GB200 NVL72 | En abril de 2025 NVIDIA anunció miles de GPUs Grace Blackwell activas; Cohere, IBM y Mistral AI pasaron a entrenar y servir modelos de razonamiento y agentic AI. |
| Oracle / OCI | GB200 NVL72 liquid-cooled | Primera ola de racks en operación, con miles de GPUs Blackwell para OCI y DGX Cloud, combinando Quantum InfiniBand y Spectrum-X Ethernet. |
| NeoSpace | GB200 NVL72 vía OCI | Caso latinoamericano: NeoData en entorno multi-nube para uno de los mayores bancos privados de América Latina, con más de 60 millones de clientes. |
| DeepL | GB200 | Entrenamiento de modelos Mixture-of-Experts de próxima generación, buscando eficiencia tanto en entrenamiento como en inferencia. |
| Microsoft / OpenAI | GB300 NVL72 | Clúster Azure a gran escala: throughput, latencia, memoria y red escalando como un único sistema. |
| Lambda | GB300 NVL72 | AI Factory de más de 100 MW en Kansas City, planificada con más de 10.000 GPUs — energía y data center convertidos en capacidad vendible. |
| Together AI / 5C | B200, GB200 y GB300 | AI Factory en Maryland con B200 y nueva instalación en Memphis con GB200/GB300 para aplicaciones AI-native. |
| Global AI | 128 racks GB300 NVL72 | Más de 9.000 GPUs en Nueva York: el rack deja de ser unidad aislada y se convierte en bloque repetible de una AI Factory. |
Lo que estos casos enseñan: el objetivo no es simplemente poseer GPUs. El valor aparece cuando el cómputo, NVLink, la red scale-out, el storage, el software, la energía y el cooling se tratan como una única fábrica capaz de entregar tokens, entrenamiento, simulaciones y servicios con previsibilidad operativa.
Por qué Vera Rubin es el próximo paso
En 2026, NVIDIA informó que Vera Rubin NVL72 entró en ramp de producción, con racks operando en socios como CoreWeave, Google Cloud, Microsoft Azure, Oracle Cloud Infrastructure y Nebius. Microsoft anunció Rubin para futuros sitios Fairwater, mientras que CoreWeave pasó a integrar sistemas Rubin para workloads de entrenamiento, inferencia y agentic AI.
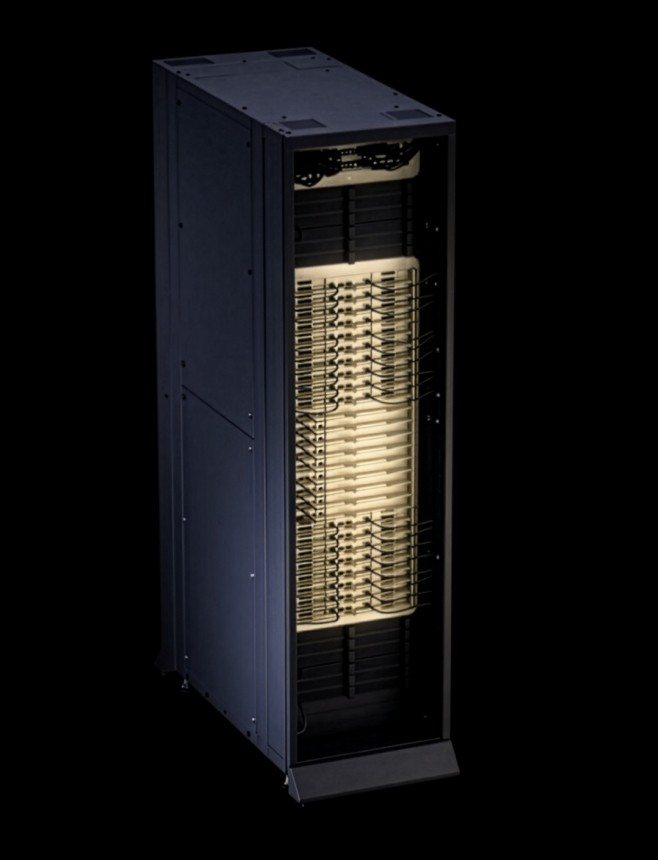
Mensaje ejecutivo: Vera Rubin debe entenderse como infraestructura estratégica para AI Factory y HPC — alto CAPEX y alta densidad, pero capaz de concentrar en pocos racks una capacidad imposible para servidores convencionales.
Arquitectura sistémica de la AI Factory
Vera Rubin es una arquitectura de infraestructura de IA a escala de rack y POD, diseñada para que la computación, la memoria, la comunicación, la red, el almacenamiento, la seguridad, la potencia y la refrigeración funcionen como un sistema coordinado. En los modelos actuales, el desempeño no depende solo de FLOPS: es necesario mover pesos, activaciones y KV cache, sincronizar aceleradores, mantener baja latencia y entregar más tokens por watt.
El cambio estratégico es claro: de servidor aislado a dominio de ejecución a escala de rack; de pico de FLOPS a tokens útiles por watt y por megavatio; de entrenamiento puro a entrenamiento, post-entrenamiento e inferencia agentiva; de interconexión periférica a memoria y comunicación como parte del acelerador.
La plataforma reúne Rubin GPU, Vera CPU, NVLink 6 Switch, ConnectX-9 SuperNIC, BlueField-4 DPU y nuevas familias de networking y racks especializados — compute, CPU, storage y Ethernet. El NVL72 es el núcleo de cómputo de este ecosistema.
La GPU Rubin en detalle
La Rubin GPU está orientada a workloads de razonamiento, generación, recuperación de datos y uso de herramientas. La combinación de HBM4, Transformer Engine y NVLink 6 busca mantener a los aceleradores ocupados incluso en cargas con comunicación intensa y múltiples etapas de inferencia.
| Ítem | Rubin GPU | Vera Rubin NVL72 |
|---|---|---|
| Transistores | 336 mil millones | — |
| SMs / Tensor Cores | 224 / 896 | 72 GPUs |
| NVFP4 inferencia | 50 PFLOPS | 3.600 PFLOPS |
| Memoria | 288 GB HBM4 | 20,7 TB HBM4 |
| Ancho de banda HBM4 | 22 TB/s | 1.580 TB/s agregado |
| Interconexión | NVLink 6: 3,6 TB/s | 260 TB/s en el rack |
Lectura correcta: los valores anteriores son especificaciones y picos divulgados para la plataforma. El desempeño de la aplicación depende del framework, kernel, precisión, modelo, batch, contexto y estrategia de paralelismo.
Memoria HBM4 y NVLink 6
En inferencia, especialmente en la fase de decode, mover pesos y estado del modelo puede ser tan determinante como ejecutar multiplicaciones. Por eso Vera Rubin combina capacidad de memoria, gran ancho de banda y una malla de comunicación de baja latencia.
- Hasta 288 GB de HBM4 por GPU Rubin y hasta 22 TB/s de ancho de banda de memoria por GPU.
- Más espacio para pesos, activaciones, KV cache y concurrencia, con menor necesidad de descargar estado hacia capas más lentas.
- Hasta 3,6 TB/s de scale-up por GPU para el dominio NVLink, con comunicación all-to-all entre las GPUs del NVL72.
- NVLink-C2C de alto ancho de banda para comunicación coherente CPU-GPU.
- Reducción del overhead de sincronización y del tiempo perdido en transferencia en workloads MoE y distribuidos.
Por qué esto importa: los modelos Mixture-of-Experts distribuyen tokens entre especialistas. Cuanto más tiempo el rack gasta transfiriendo pesos y sincronizando GPUs, menor es la fracción de energía convertida en trabajo útil. HBM4 y NVLink 6 atacan directamente ese cuello de botella.
Entrenamiento, inferencia e IA agentiva
Un agente no responde solo a una pregunta: planifica, llama herramientas, consulta fuentes, verifica resultados y puede generar varias secuencias de tokens antes de concluir una tarea. Esto aumenta el volumen de inferencia y vuelve crítica la latencia por etapa.
| Entrenamiento | Inferencia e IA agentiva |
|---|---|
| Modelos MoE y foundation models a gran escala. | Servicios interactivos con baja latencia. |
| Tensor, pipeline y expert parallelism. | Long-context y grandes KV caches. |
| Alta comunicación para sincronización y enrutamiento de tokens. | Alta concurrencia y batching continuo. |
| HBM4 para mantener parámetros y estados cerca del cómputo. | Optimización por tokens/s, tokens/W y costo por millón de tokens. |
En escenarios específicos NVIDIA posiciona Vera Rubin para entregar ganancias expresivas en tokens por megavatio y costo por millón de tokens frente a generaciones anteriores. Trate esas cifras como referencias de plataforma, condicionadas a modelo, software, precisión y configuración.
Red, almacenamiento y seguridad
La plataforma no termina en la GPU. Para mantener 72 aceleradores ocupados, el tráfico east-west, el acceso al storage y la protección del workload deben tratarse como partes de la computadora.
- Red: ConnectX-9 SuperNIC para scale-out de altísimo ancho de banda; Quantum-X800 InfiniBand y Spectrum-X Ethernet para clústeres multi-rack; RDMA y caminos de baja latencia; arquitecturas spine-leaf y ópticas de alta densidad dimensionadas junto con el cómputo.
- Almacenamiento contextual: la arquitectura BlueField-4/STX amplía el papel del storage más allá de repositorio de archivos, acercando capas de contexto y KV cache al dominio de ejecución — combinado, en proyectos reales, con NVMe, parallel file systems, object storage y políticas de tiering.
- Seguridad: BlueField-4 para procesamiento de red, offload y políticas; Confidential Computing y protección de datos en uso, en tránsito y en reposo según soporte de la plataforma; aislamiento de tenants en cloud y GPUaaS; secure boot, firmware firmado, observabilidad y RAS a escala de rack.
Vera Rubin versus Blackwell
La comparación debe hacerse a nivel de sistema. Rubin no es solo una actualización de GPU: cambia la forma en que el data center entrega computación para IA, con nuevas exigencias de memoria, red, potencia y refrigeración.
| Criterio | Blackwell / GB200 | Vera Rubin / NVL72 |
|---|---|---|
| Enfoque | Entrenamiento e inferencia a escala | IA agentiva, long-context y eficiencia |
| Memoria | HBM3e, según modelo | HBM4, hasta 288 GB/GPU |
| Interconexión | NVLink 5 | NVLink 6 |
| Rack de referencia | GB200 NVL72 | Vera Rubin NVL72 |
| Refrigeración | Direct liquid cooling | Direct liquid cooling, rack integrado |
| Economía | Alto throughput | Enfoque en tokens por watt y por MW |
Visión técnica del rack
El NVIDIA Vera Rubin NVL72 es un sistema rack-scale de la tercera generación MGX. El rack integra 72 GPUs Rubin y 36 CPUs Vera, interconectadas por NVLink 6, con networking ConnectX-9 y BlueField-4. El objetivo es hacer que el rack opere como un gran acelerador único dentro de la AI Factory.
| Parámetro | Referencia |
|---|---|
| GPUs | 72 × NVIDIA Rubin |
| CPUs | 36 × NVIDIA Vera |
| HBM4 total | 20,7 TB |
| Bandwidth HBM4 | hasta 1.580 TB/s |
| CPU memory | 54 TB LPDDR5X |
| Memoria rápida total DGX | 75 TB |
| NVLink | 6ª generación |
| NVLink switch system | 9 × L1 NVLink Switch Units |
| Scale-out | ConnectX-9 / BlueField-4 |
| Cabinet TDP de facilities | hasta 330 kW — referencia DSX |
Estructura física: 18 compute trays y 9 NVLink 6 switch trays. Cada compute tray integra 2 Vera Rubin Superchips, totalizando 4 GPUs Rubin y 2 CPUs Vera. El diseño del tray es modular, cable-free, hose-free y fanless, con manifold interno rediseñado. El rack MGX de tercera generación usa rack manifolds UQD08 y busbars refrigerados por líquido para corrientes elevadas.
Especificación de cada compute tray
El compute tray es la unidad de servicio y de cálculo repetida 18 veces en el rack. Cada tray concentra cómputo, networking, cooling, gestión y power delivery.
| Ítem | Por compute tray |
|---|---|
| Vera Rubin Superchips | 2 |
| Rubin GPUs | 4 |
| Vera CPUs | 2 |
| HBM4 total | 1.152 GB (4 × 288 GB) |
| HBM4 bandwidth | 88 TB/s agregado |
| CPU cores | 176 Olympus cores |
| CPU memory | hasta 3 TB LPDDR5X |
| NVFP4 inference | 200 PFLOPS por tray |
| NVLink 6 | 14,4 TB/s agregado |
| Networking | ConnectX-9 + BlueField-4 |
| Cooling | Direct Liquid Cooling, tray fanless |
Atención a la potencia por hoja: la documentación pública detalla capacidad y arquitectura del tray, pero el Max Power/TDP eléctrico definitivo por compute tray debe obtenerse del Site Planning/Reference Design final. No derive el circuito eléctrico solo dividiendo 330 kW por 18.
Resumen ejecutivo de facilities
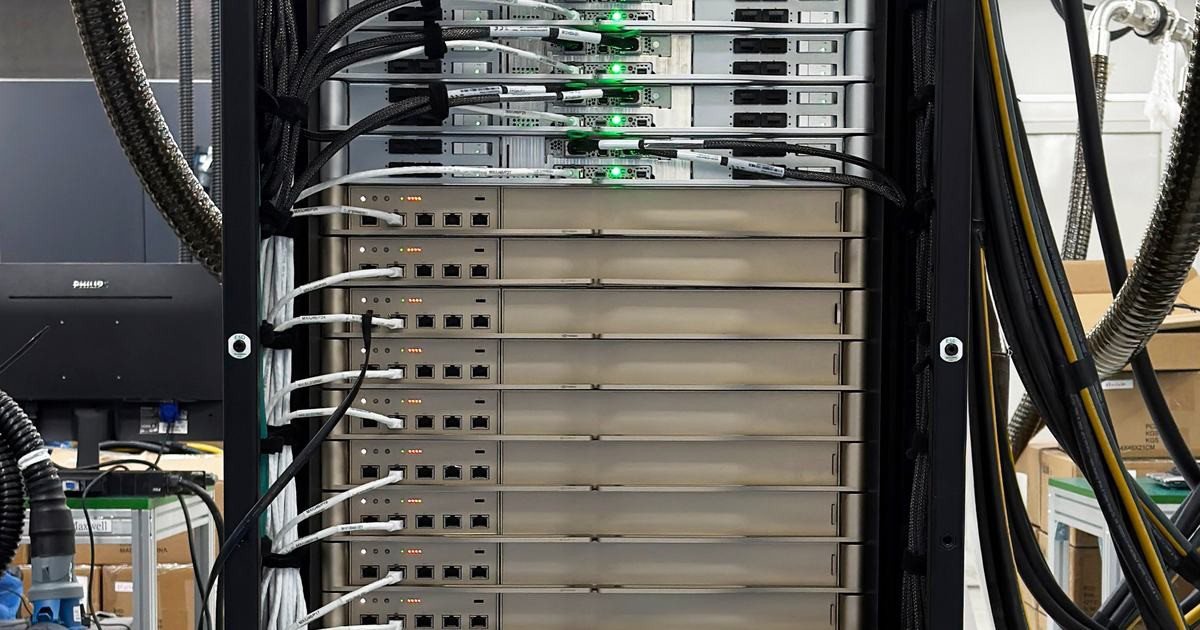
Vera Rubin NVL72 representa un cambio de escala en el diseño de infraestructura física para IA. Para facilities, la referencia NVIDIA DSX evoluciona hacia un Cabinet TDP de hasta 330 kW por rack y hacia una estrategia de refrigeración líquida de alta temperatura.
| Parámetro base para pre-proyecto | Valor de referencia |
|---|---|
| Cabinet TDP DSX | 330 kW por rack |
| TCS design flow | ≥ 1,5 LPM/kW |
| Caudal de referencia por rack | ≥ 495 LPM (29,7 m³/h) |
| Tipo de CDU | Liquid-to-liquid |
| Redundancia de CDU | N+1 |
| Cooling design point | 45 °C |
Arquitectura DLC: FWS, CDU, TCS y rack
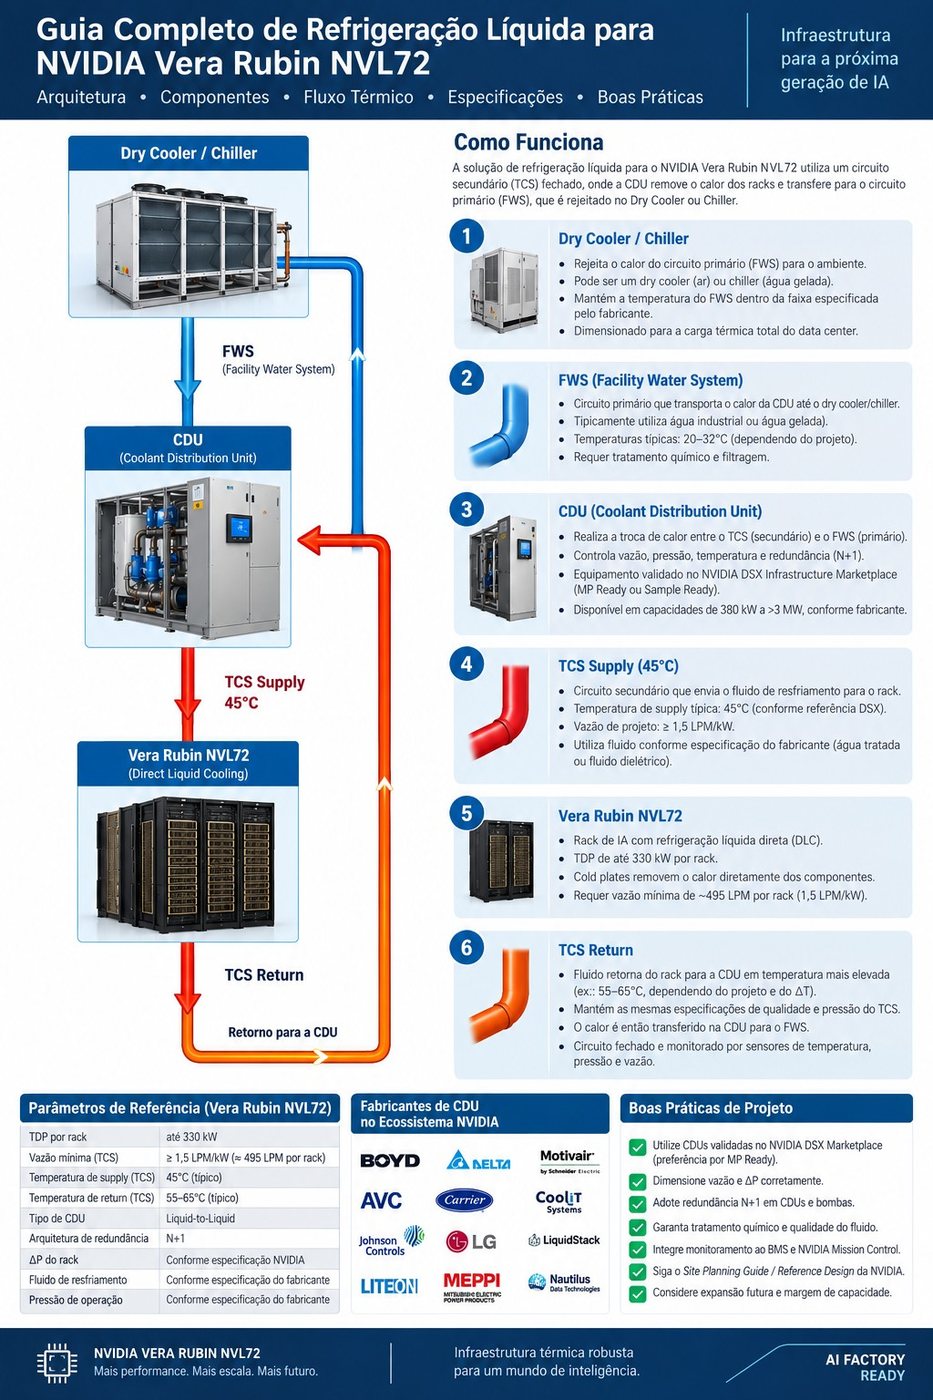
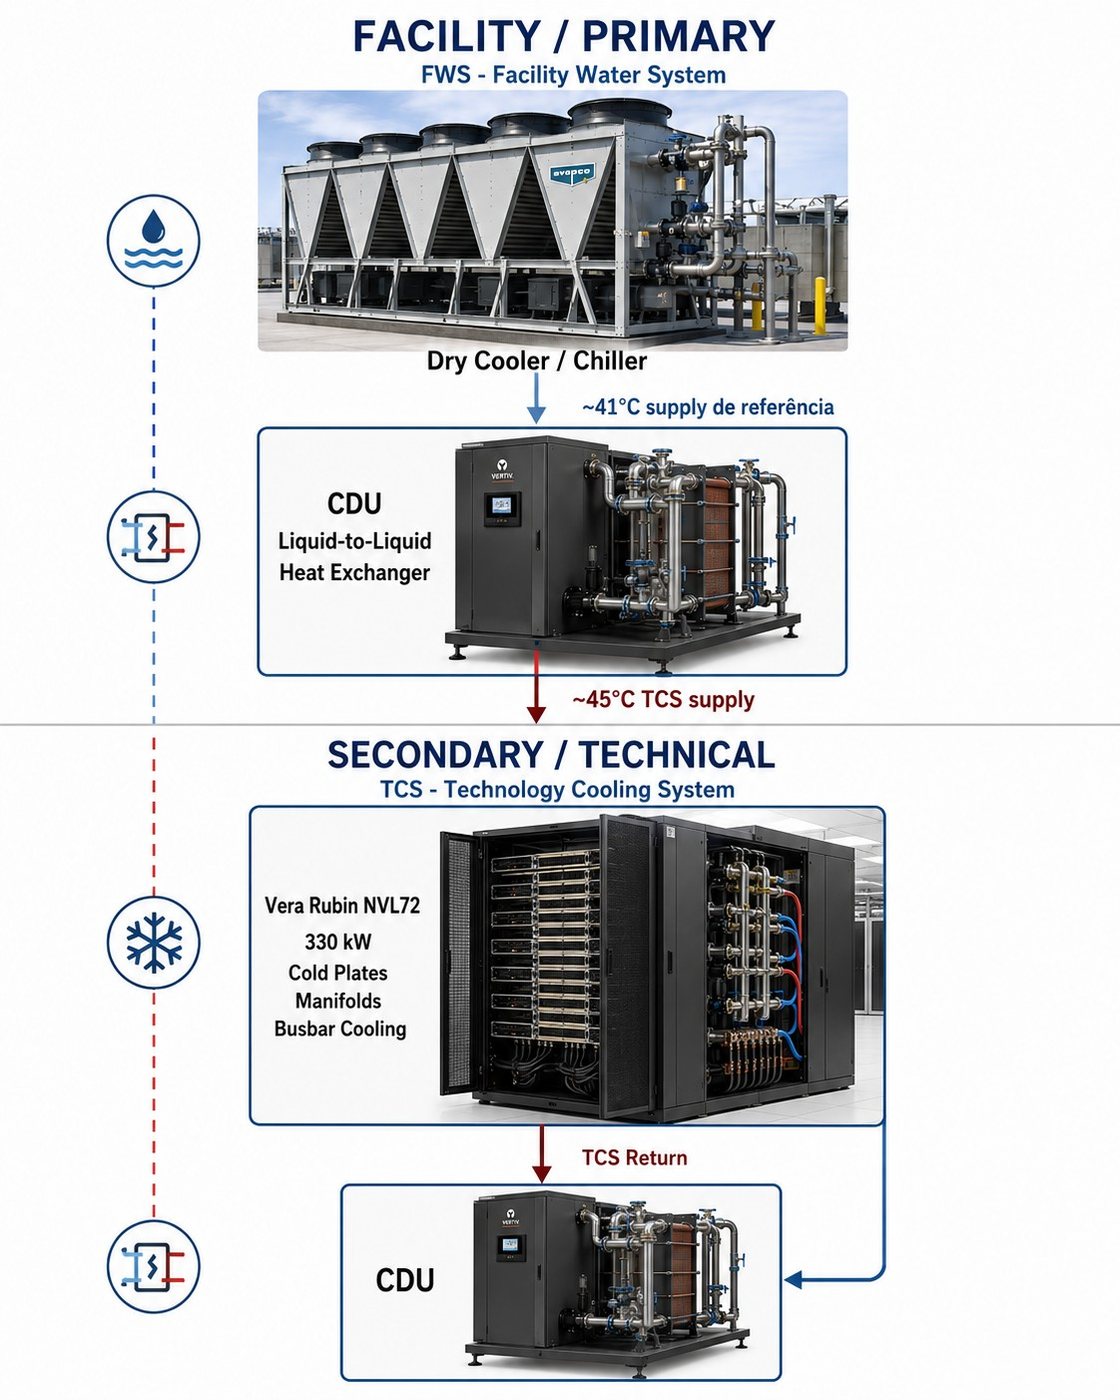
La solución usa dos circuitos hidráulicos separados por un intercambiador de calor. Entender esa separación es lo que evita los errores más costosos del proyecto.
Qué son FWS, CDU y TCS
FWS — Facility Water System. Es el circuito primario del data center. Transporta calor entre las CDUs y la planta de rechazo térmico — normalmente chillers, dry coolers, bombas e intercambiadores de la Central Utility Building. El FWS no debe confundirse con el fluido técnico que circula dentro de los racks. Utiliza típicamente agua industrial o agua helada, con temperaturas en el rango de 20–32 °C según el proyecto, y requiere tratamiento químico y filtrado.
CDU — Coolant Distribution Unit. Es la interfaz térmica e hidráulica entre el FWS y el TCS. En una CDU liquid-to-liquid, un heat exchanger mantiene los dos circuitos separados. La CDU controla temperatura, caudal, presión y differential pressure, y normalmente incluye bombas redundantes, filtrado, sensores, controles e integración al BMS. Está disponible en capacidades de 380 kW a más de 3 MW según el fabricante.
TCS — Technology Cooling System. Es el circuito secundario, de calidad técnica, que sale de la CDU y alimenta directamente los manifolds y cold plates del equipo de TI. Para el proyecto Vera Rubin, el TCS necesita dimensionarse según el operating point térmico e hidráulico del rack, y no solo por la capacidad nominal en kW de la CDU.
Regla práctica: FWS = agua de la instalación | CDU = separación y control | TCS = fluido técnico que llega al rack | DLC = eliminación de calor directamente en el chip.
45 °C de cooling: por qué esto cambia el data center
NVIDIA describe los racks MGX como diseñados para operar con warm-water inlet de 45 °C. En un escenario de referencia, agua de facility del orden de 41 °C alimenta la CDU, que suministra aproximadamente 45 °C al rack. El objetivo es ampliar la ventana de rechazo de calor sin depender continuamente de compresión mecánica.
- Mayor posibilidad de dry cooling y free cooling en varios climas.
- Menor consumo de compresores y potencial reducción de PUE.
- Más parte del presupuesto eléctrico del sitio puede dirigirse al cómputo.
- La arquitectura liquid-to-liquid permite separar la calidad del fluido de TI del agua del facility.
- 45 °C es un design point: temperaturas, approach y límites finales deben provenir del proyecto contratado.
No confundir: 45 °C de TCS supply no significa que el Facility Water obligatoriamente entra a la CDU a 45 °C. La CDU necesita una diferencia térmica (approach) y el diseño FWS/TCS debe ser verificado por el fabricante.
Dimensionamiento térmico e hidráulico
El DSX informa que el Cabinet TDP escala hasta 330 kW para el Vera Rubin NVL72. Para pre-proyecto de cooling, ese es el valor de referencia más consistente para dimensionar heat rejection, CDU y distribución, hasta que el Site Planning final indique valores específicos de MaxP/MaxQ. El DSX define además un TCS design flow de al menos 1,5 LPM/kW.
Cálculo por rack: 330 kW × 1,5 LPM/kW = 495 LPM = 29,7 m³/h por Vera Rubin NVL72.
| Racks | Carga térmica | TCS mínimo | Caudal |
|---|---|---|---|
| 1 | 330 kW | 495 LPM | 29,7 m³/h |
| 2 | 660 kW | 990 LPM | 59,4 m³/h |
| 4 | 1,32 MW | 1.980 LPM | 118,8 m³/h |
| 8 | 2,64 MW | 3.960 LPM | 237,6 m³/h |
| 16 | 5,28 MW | 7.920 LPM | 475,2 m³/h |
ΔT: transformando kW y caudal en temperaturas
El balance térmico de un circuito de agua puede aproximarse mediante Q = ṁ × Cp × ΔT. En agua, 495 LPM equivalen a aproximadamente 8,25 kg/s. Para 330 kW, el ΔT teórico es del orden de 9,6 °C.
Ejemplo didáctico: si el TCS entra a 45 °C y remueve 330 kW a alrededor de 495 LPM con propiedades cercanas a las del agua, el retorno teórico quedaría próximo a 54–55 °C. Este valor es solo indicativo; el coolant y las temperaturas finales deben seguir al OEM y a la CDU.
- Un mayor ΔT puede reducir el caudal exigido para la misma carga, pero debe respetar los límites del rack.
- Mayor concentración de glicol altera densidad, viscosidad y capacidad térmica.
- La capacidad publicada de una CDU depende del approach temperature y del operating point.
- Use las curvas del fabricante, no solo la potencia nominal de catálogo.
Cómo interpretar ΔP y el Pump Head
ΔP se lee "Delta P" y significa diferencia de presión. En un circuito hidráulico, representa la pérdida de presión entre dos puntos. Si el rack recibe 3,0 bar y retorna 2,2 bar, el ΔP del rack es 0,8 bar.
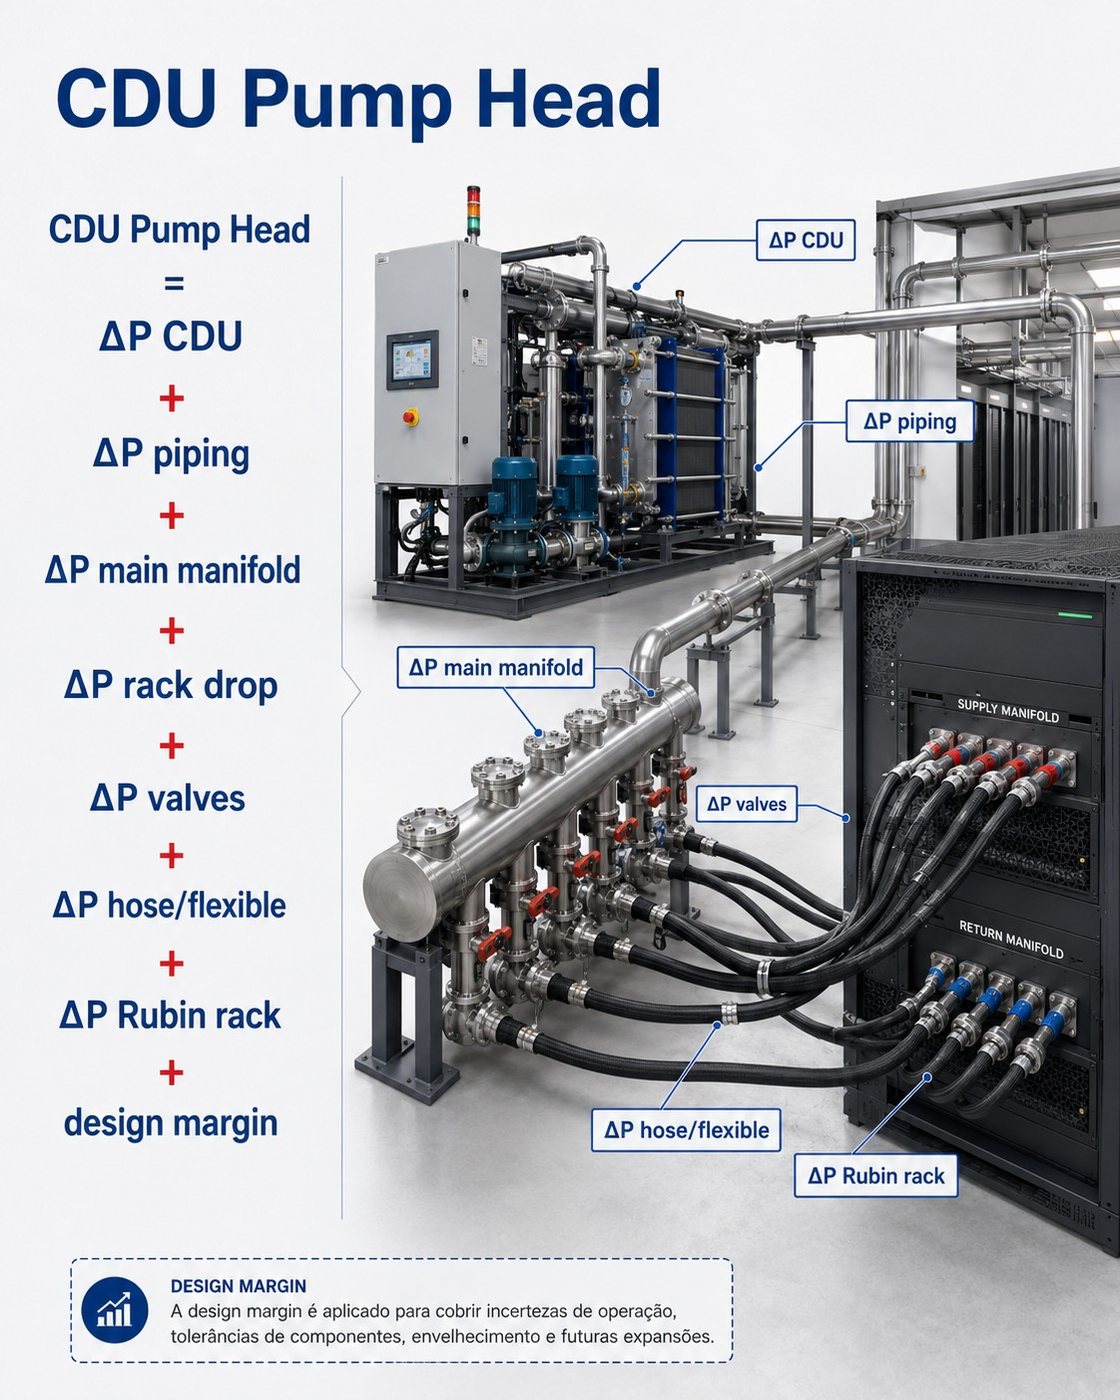
Pump Head total: ΔP CDU + ΔP piping + ΔP main manifold + ΔP rack drop + ΔP valves + ΔP hose/flexible + ΔP Rubin rack + design margin.
La bomba de la CDU debe suministrar caudal suficiente en el Pump Head requerido. Una CDU de muchos megavatios puede no atender al proyecto si su curva de bomba no entrega el caudal necesario en el ΔP real del circuito.
- Obtener del OEM el ΔP del rack en el caudal nominal y en el máximo.
- Calcular pérdidas de carga de los headers de supply y return.
- Sumar válvulas, filtros, conexiones, flexibles, manifolds y accesorios.
- Aplicar margen coherente para tolerancias, envejecimiento, fouling y expansión.
- Verificar NPSH, cavitación y operación de las bombas en paralelo cuando corresponda.
Manifolds, cold plates e interfaz del rack
En la tercera generación MGX, NVIDIA describe nuevos manifolds internos de tray, rack manifolds UQD08 y busbars refrigerados por líquido capaces de soportar corrientes muy elevadas. El compute tray fue rediseñado hacia un conjunto cable-free, hose-free y fanless.
- El supply manifold distribuye el coolant por los trays; el return manifold recolecta el fluido calentado.
- Universal Quick Disconnects (UQD08) facilitan la conexión y el mantenimiento.
- Los cold plates transfieren calor directamente de GPU, CPU y demás componentes al fluido.
- La interfaz externa del rack — diámetro, patrón de conexión, working pressure y posición — debe provenir del diseño mecánico del OEM.
Información obligatoria para el proyecto: no asuma que el conector interno UQD08 es el mismo conector externo del rack. Solicite el Rack Supply/Return Interface Drawing con cantidad de conexiones, diámetro, tipo, altura, orientación, presión y requisitos de aislamiento.
Cómo seleccionar la CDU
La selección no debe hacerse solo por "MW de la CDU". Es necesario validar simultáneamente capacidad térmica, caudal, presión disponible, approach, fluido, materiales, redundancia, alimentación y controles.
| Criterio | Qué validar |
|---|---|
| Capacidad térmica | ≥ carga de los racks en el operating point y ATD definidos |
| Caudal secundario | ≥ 1,5 LPM/kW como referencia DSX |
| Pump Head | Suficiente para el ΔP total calculado |
| Tipo | Liquid-to-liquid en la referencia DSX |
| Redundancia | N+1 en grupos de CDU |
| Bombas | Redundancia, failover y curva validada |
| Fluido y materiales | Compatibilidad química y wetted materials |
| Filtrado | Rating compatible con el OEM |
| Controles | Constant flow o constant ΔP según estrategia |
| Integración | BMS, DSX Exchange y Mission Control |
| Mantenimiento | Aislamiento, bypass y cambio sin impacto indebido |
Ejemplo: para 1 rack son 330 kW y ≥ 495 LPM. Una CDU nominal de 380 kW / 600 LPM puede parecer suficiente, pero la decisión solo es válida si entrega esos valores en el ΔP y en el approach reales del proyecto.
DSX Marketplace: MP Ready x Sample Ready
El NVIDIA DSX Infrastructure Marketplace publica CDUs sometidas a la CDU Self-Qualification Suite e indica el estado de la cadena de suministro. MP Ready no es sinónimo aislado de homologación: es un indicador de preparación para producción en masa, mientras que la columna Validation Type muestra las pruebas técnicas realizadas.
| Estado | Significado práctico |
|---|---|
| MP Ready | Mass Production Ready: producto en etapa de suministro a escala. |
| Sample Ready | Producto disponible en etapa de muestra/calificación, aún sin el mismo estado de producción en masa. |
| Validation Type | Lista los ensayos realizados: hydraulic constant flow/DP, thermal capacity, pump failover, flow accuracy, group control y otros. |
Los ensayos publicados incluyen Hydraulic Test (Constant Flow y Constant DP), Pumping Capacity, Thermal Test (Nominal Capacity y Low Load), Flow Sensor Accuracy, Cold Start Test, Pump Failover, Group Control y Wetted Materials Compatibility.
Fabricantes de CDU en el ecosistema DSX
La lista pública es dinámica. Los valores a continuación reflejan la consulta del 04/09/2026 y deben reconfirmarse antes de la compra.
| Fabricante | Modelo | Capacidad @ 4 °C ATD | Flow @ 35 psi | Estado |
|---|---|---|---|---|
| AVC | CDU1000-LTL-RW | 1,2 MW | 1.600 LPM | Sample Ready |
| Boyd | ROL2300 | 1,1 MW | 2.600 LPM | MP Ready |
| Carrier | 65LL | 1,2 MW | 2.500 LPM | Sample Ready |
| CoolIT | CHx1500 | 1,5 MW | 1.950 LPM | — |
| Delta | RDF106CDT5192 | 1,0 MW | 1.500 LPM | MP Ready |
| Delta | CDU3000 | 2,0 MW | 3.200 LPM | — |
| Johnson Controls | SACDU-1050 | 1,0 MW | — | — |
| LG Electronics | LGE | 600 kW | 850 LPM | — |
| LiquidStack | L2L CDU800 | 800 kW | 1.200 LPM | — |
| LiquidStack | D1PM20 | 2,5 MW | 3.750 LPM | — |
| LITEON | LC-LL-WCDU-6011(S) | 380 kW | 600 LPM | Sample Ready |
| MEPPI | ME-CDU 1200 | 1,25 MW | — | — |
| Motivair | MCDU50 | 1,7 MW | 1.136 LPM | MP Ready |
| Motivair | MCDU55 | 1,3 MW | 1.616 LPM | Sample Ready |
| Nautilus | EcoCore FCD | 3,6 MW | 3.300 LPM | — |
Estrategia de adquisición en Brasil
Para la implementación en Brasil, se recomienda separar tres criterios: presencia local del fabricante, disponibilidad del modelo exacto y estado de validación del modelo en el ecosistema NVIDIA. Una empresa puede tener operación brasileña sin mantener en stock local la CDU específica del proyecto Rubin.
| Fabricante / ecosistema | Evidencia pública en Brasil | Observación |
|---|---|---|
| Schneider Electric / Motivair | Portafolio brasileño de liquid cooling y CDUs | Publica CDUs Motivair y servicios locales; validar el modelo DSX específico. |
| Delta Electronics | GoCool LTL en el sitio brasileño | GoCool-1000/1200/1500/3000; validar equivalencia y estado del modelo exacto en el DSX. |
| Johnson Controls / Silent-Aire | Página brasileña de data centers y liquid cooling | Buena presencia de servicios; validar SACDU, modelo y lead time. |
| Carrier | Presencia regional/global y CDU 65LL | Confirmar disponibilidad local y estado de supply chain. |
| LG | Operación local | Confirmar modelo de CDU, soporte y BOM para Rubin. |
Recomendación de compra: emitir RFI/RFQ para al menos tres proveedores y exigir curva de bomba, thermal map por ATD, materiales mojados, calidad del coolant, redundancia, integración BMS, FAT/SAT, piezas de repuesto y compromiso de soporte en Brasil.
Potencia eléctrica, kVA y consumo
El DSX publica 330 kW como Cabinet TDP. Para aproximación de infraestructura eléctrica, kVA = kW / factor de potencia. El dimensionamiento final, sin embargo, debe usar el electrical site planning y los límites de alimentación del rack, no solo el TDP térmico.
| Factor de potencia | Cálculo | Equivalencia |
|---|---|---|
| PF 0,95 | 330 kW / 0,95 | 347,4 kVA |
| PF 0,98 | 330 kW / 0,98 | 336,7 kVA |
| PF 0,99 | 330 kW / 0,99 | 333,3 kVA |
NVIDIA no publica un consumo promedio universal del Rubin. El entrenamiento, la inferencia, la comunicación y los perfiles MaxP/MaxQ producen cargas diferentes. Use escenarios de utilización únicamente para presupuesto de energía, nunca para reducir la capacidad física instalada.
| Escenario | Potencia media | Energía en 730 h |
|---|---|---|
| 50% del envelope | 165 kW | 120,5 MWh/mes |
| 70% | 231 kW | 168,6 MWh/mes |
| 80% | 264 kW | 192,7 MWh/mes |
| 90% | 297 kW | 216,8 MWh/mes |
| 100% | 330 kW | 240,9 MWh/mes |
Requisitos integrados para el data center
| Dominio | Puntos a validar |
|---|---|
| Espacio | U ocupada, peso, acceso, ruta de movimiento, piso y área de mantenimiento. |
| Energía | kW/kVA por rack, arquitectura A/B, UPS, PDU, protección, aterramiento, armónicas y expansión. |
| Térmico | CDU, caudal, ΔP, supply/return, temperatura, calidad del fluido y detección de fugas. |
| Red | InfiniBand/Ethernet, fibra, transceptores, latencia, cableado y spine-leaf. |
| Storage | NVMe, parallel file system, object storage, throughput y metadata. |
| Operación | NOC, DCIM/BMS, telemetría, spare parts, entrenamiento, RMA y procedimientos de emergencia. |
Checklist de recepción: confirmar modelo y revisión; obtener diseño dimensional y de peso; solicitar Max-P/TDP, caudal nominal, mínimo y máximo y ΔP; validar supply/return y CDU; ejecutar FAT/SAT, prueba hidráulica, prueba de carga y validación de red.
BMS, Mission Control y observabilidad
El cooling de una AI Factory necesita ser observable en tiempo real. La documentación DSX publica un catálogo de puntos para integración entre BMS y el ecosistema NVIDIA/DSX Exchange.
| Punto | Uso operativo |
|---|---|
| CDULiquidSupplyTemperature | Temperatura de TCS supply |
| CDULiquidReturnTemperature | Temperatura de TCS return |
| CDULiquidDifferentialPressure | ΔP del circuito secundario |
| CDULiquidFlow | Caudal en LPM |
| CDULiquidSystemPressure | Presión del sistema y del return |
| Leak detection / alarms | Eventos de fuga y anormalidad |
| CDU availability/status | Disponibilidad y estado operativo |
- Alarmas por temperatura, caudal, ΔP y presión fuera de rango.
- Tendencia histórica para detectar fouling, filtro saturado y degradación de bomba.
- Interlock y lógica de aislamiento según matriz de causa y efecto.
- Integración de los eventos de facility con Mission Control/DSX para operación coordinada de power y cooling.
RFI técnico: 12 informaciones obligatorias
Antes del proyecto ejecutivo, estas doce informaciones deben provenir del fabricante o del representante — no de estimación.
| # | Información | Por qué es indispensable |
|---|---|---|
| 1 | Cantidad exacta de Vera Rubin NVL72 | Define escala total, potencia, cooling, caudal, CDU, redundancia y expansión. |
| 2 | Max-P/TDP confirmado por rack | Base para energía y carga térmica, en el perfil operativo contratado. |
| 3 | TCS design flow por rack | Caudal nominal para remover la carga y dimensionar bombas, headers y CDU. |
| 4 | TCS minimum/maximum flow | Límites operativos contra subflujo, exceso de caudal y operación fuera del envelope. |
| 5 | TCS supply/return temperatures | Determina ΔT, approach de la CDU, eficiencia térmica y capacidad de rechazo. |
| 6 | ΔP del rack en el caudal nominal y máximo | Necesario para calcular el Pump Head y seleccionar bombas y válvulas. |
| 7 | Working pressure y maximum allowable pressure | Define límites de seguridad del circuito, hoses, válvulas y conexiones. |
| 8 | Coolant / water-quality specification | Especifica fluido, química, pH, conductividad, filtrado y materiales compatibles. |
| 9 | Rack Supply/Return connection type y dimensions | Define diámetro, tipo, posición, cantidad y estándar de las interfaces hidráulicas. |
| 10 | CDU approved/validated models | Alinea la selección al DSX Marketplace y a la configuración OEM. |
| 11 | BMS/Mission Control telemetry requirements | Define sensores, protocolos, alarmas y puntos de integración IT/OT. |
| 12 | Site Planning Guide / Reference Design final | Documento de autoridad para validar el proyecto ejecutivo antes de la implementación. |
Paquete mínimo esperado en la respuesta: tabla completada con valores nominales, mínimos y máximos y respectivas unidades; curvas hidráulicas del rack y de la CDU en los operating points relevantes; diseños mecánicos de las interfaces supply/return; especificación química del coolant y materiales mojados; lista de alarmas, sensores, protocolos y puntos de integración BMS/DSX; y documentos finales de Site Planning, FAT/SAT y criterios de aceptación.
Ejemplo de pre-dimensionamiento con 8 racks
Este ejemplo sirve solo para sizing inicial. El proyecto ejecutivo debe cerrar el ΔP, las curvas de las bombas, la topología hidráulica, la diversificación, la redundancia, la expansión y el envelope eléctrico.
| Parámetro | Valor de pre-proyecto |
|---|---|
| Racks Vera Rubin | 8 |
| GPUs Rubin | 576 |
| CPUs Vera | 288 |
| Cabinet TDP agregado | 2,64 MW |
| TCS design flow mínimo | 3.960 LPM |
| Caudal equivalente | 237,6 m³/h |
| Cooling architecture | Liquid-to-liquid CDU group |
| CDU redundancy | N+1 |
| TCS supply design point | Clase 45 °C |
| BMS | Supply/return temp, flow, ΔP, pressure, alarms |
Selección de la CDU: no use solo 2,64 MW dividido por la capacidad nominal. Verifique también si el grupo de CDUs entrega ≥ 3.960 LPM en el Pump Head total y en el approach térmico del proyecto, manteniendo N+1. Para clústeres mayores, la distribución debe concebirse como planta hidráulica de alta capacidad, con headers principales, aislamiento por rack y ramal, balanceo, instrumentación y estrategia de mantenimiento concurrente.
Puesta en marcha y pruebas
Un sistema DLC de alta densidad debe ser puesto en marcha como infraestructura de misión crítica. El FAT de la CDU y el SAT del sistema deben validar no solo la potencia térmica, sino el comportamiento hidráulico y de control.
- Flushing y limpieza de las tuberías antes de la conexión al rack.
- Análisis químico del coolant y verificación de materiales compatibles.
- Prueba hidrostática según presión admisible y procedimiento del fabricante.
- Verificación de caudal por ramal y balanceo de los racks.
- Prueba de ΔP en carga nominal y máxima.
- Prueba de pump failover y pérdida de alimentación A/B.
- Prueba de válvulas de aislamiento y bypass.
- Detección de fugas y causa/efecto en el BMS.
- Validación de sensores de temperatura, presión y caudal.
- Prueba de pérdida del FWS, recuperación y secuencia de restart.
- Prueba de operación N+1 con una CDU no disponible.
- Registro de baseline para operación y mantenimiento predictivo.
Criterio de aceptación: la entrega debe incluir curvas as-built, parámetros de control, setpoints, matriz de alarmas, water-quality baseline, lista de piezas críticas y procedimiento de respuesta a fugas.
Principales riesgos de proyecto
| Riesgo | Impacto |
|---|---|
| CDU elegida solo por MW | Puede faltar caudal o Pump Head en el operating point real. |
| ΔP del rack desconocido | Imposibilita dimensionar correctamente las bombas. |
| Conector del rack asumido | Puede generar incompatibilidad mecánica y retrabajo. |
| Water quality indefinida | Riesgo de corrosión, fouling y falla de cold plates. |
| Sin N+1 real | El mantenimiento o falla de CDU puede afectar múltiples racks. |
| Sin aislamiento por rack | Aumenta el blast radius de mantenimiento y fuga. |
| Sin BMS/telemetría adecuada | Pérdida de detección temprana de degradación. |
| Usar consumo promedio para sizing | Crea riesgo de insuficiencia en MaxP. |
| Ignorar ATD/approach | La capacidad nominal de la CDU puede no existir en las temperaturas del proyecto. |
| No validar disponibilidad local | Riesgo de lead time, spare parts y soporte insuficiente en Brasil. |
Glosario rápido
| Término | Definición |
|---|---|
| DLC | Direct Liquid Cooling — refrigeración directa por líquido. |
| FWS | Facility Water System — circuito primario de la instalación. |
| TCS | Technology Cooling System — circuito secundario que atiende el equipo de TI. |
| CDU | Coolant Distribution Unit — interfaz FWS/TCS con intercambiador, bombas y controles. |
| ΔP | Delta P — diferencia o pérdida de presión entre dos puntos. |
| ΔT | Delta T — diferencia de temperatura entre supply y return. |
| Pump Head | Presión o altura manométrica que la bomba necesita suministrar para vencer las pérdidas del circuito. |
| Cold plate | Intercambiador en contacto térmico con el chip o componente. |
| Manifold | Colector y distribuidor de supply y return. |
| UQD08 | Universal Quick Disconnect usado en la arquitectura MGX de tercera generación. |
| ATD | Approach Temperature Difference del heat exchanger o de la CDU. |
| MP Ready | Mass Production Ready — estado de supply chain en el NVIDIA DSX Marketplace. |
| Sample Ready | Etapa de muestra y calificación en el Marketplace. |
| BMS | Building Management System. |
| DSX | Arquitectura y ecosistema NVIDIA para AI Factory, incluyendo facilities, hardware e IT/OT. |
Documentos que deben solicitarse
- NVIDIA Vera Rubin NVL72 Reference Design — NVOnline #1151654.
- NVIDIA DSX — Vera Rubin Facilities Infrastructure Reference Design — NVOnline #1145739.
- NVIDIA DSX Facilities Infrastructure Design Guide — NVOnline #1152370.
- Site Planning / Power & Cooling Specification final de la configuración adquirida.
- Rack Supply/Return Interface Drawing y coolant/water-quality specification.
Fecha de corte: contenido técnico y lista de proveedores verificados el 04/09/2026. El NVIDIA DSX Marketplace es dinámico; revalide estado, capacidad, flow y disponibilidad en el momento de la contratación.
Referencias técnicas
- NVIDIA Vera Rubin NVL72 — especificaciones oficiales
- NVIDIA DGX Vera Rubin NVL72
- NVIDIA DSX Facilities Infrastructure Reference Design Overview
- NVIDIA DSX Infrastructure Marketplace — CDU
- NVIDIA Technical Blog — Vera Rubin POD
- NVIDIA Technical Blog — Inside the Vera Rubin Platform
- NVIDIA Mission Controls to BMS Data Catalog
- NVIDIA — Vera Rubin worldwide deployments
- NVIDIA — CoreWeave GB200 NVL72
- NVIDIA — Oracle OCI GB200 NVL72
- NVIDIA Case Study — NeoSpace / Finanzas
- NVIDIA — GB300 deployments y AI Infrastructure in America
Conclusión
La principal innovación de Vera Rubin es sistémica. El valor no está en una GPU aislada, sino en la combinación de cómputo, HBM4, NVLink 6, red scale-out, storage, seguridad, energía y Direct Liquid Cooling operando como una única fábrica de computación.
Para empresas y data centers, la oportunidad está en transformar energía e infraestructura física en capacidad útil de IA: entrenamiento de modelos, inferencia agentiva, GPUaaS, investigación científica, simulación y servicios soberanos. El desafío también es sistémico — eléctrica, hidráulica, conectividad, software, observabilidad, operación y soporte necesitan evolucionar al mismo ritmo que el acelerador.
La pregunta correcta: en lugar de preguntar solo cuántas GPUs caben en el rack, el proyecto debe responder cuántos tokens útiles, agentes concluidos, simulaciones y workloads de negocio puede producir el data center por megavatio — con disponibilidad, seguridad y previsibilidad operativa.
- Consolidar la demanda real de entrenamiento, inferencia y HPC.
- Confirmar Max-P/TDP y el TCS design flow de la configuración contratada.
- Calcular el Pump Head total antes de elegir la CDU.
- Emitir RFI para al menos tres proveedores con el paquete mínimo de datos.
- Definir criterios de puesta en marcha antes de la contratación.
- Planificar telemetría, operación y mantenimiento desde el inicio.
EnQ Digital: infraestructura inteligente para empresas que no pueden detenerse — estrategia, ingeniería, implementación, operación y evolución orientadas a riesgo y desempeño.