
Esta guía técnica reúne, en una única visión, la plataforma VMware de la generación actual: el hipervisor ESXi, el vCenter Server como plano de control, y las dos ofertas empaquetadas — VMware vSphere Foundation (VVF) y VMware Cloud Foundation (VCF) — con licenciamiento por núcleo, gestión, identidad, automatización, seguridad, desempeño y continuidad.
La propuesta es servir a arquitectos, ingenieros, gestores de infraestructura, preventa y tomadores de decisión. Los ejemplos de capacidad son modelos de dimensionamiento, no garantías para ningún workload — deben recalcularse con las mediciones reales de CPU, memoria, latencia, IOPS, throughput, RPO y RTO.
Sobre este material: contenido consolidado a partir de fuentes oficiales de Broadcom/VMware disponibles hasta el 2 de septiembre de 2026, incluyendo VMware Cloud Foundation 9.x y VMware vSphere Foundation en la generación actual. El licenciamiento, las métricas promocionales, versiones, soporte y disponibilidad pueden cambiar — confirme la propuesta comercial, el Product Guide y los términos contractuales vigentes antes de comprar o renovar.
Visión ejecutiva y mapa de la plataforma
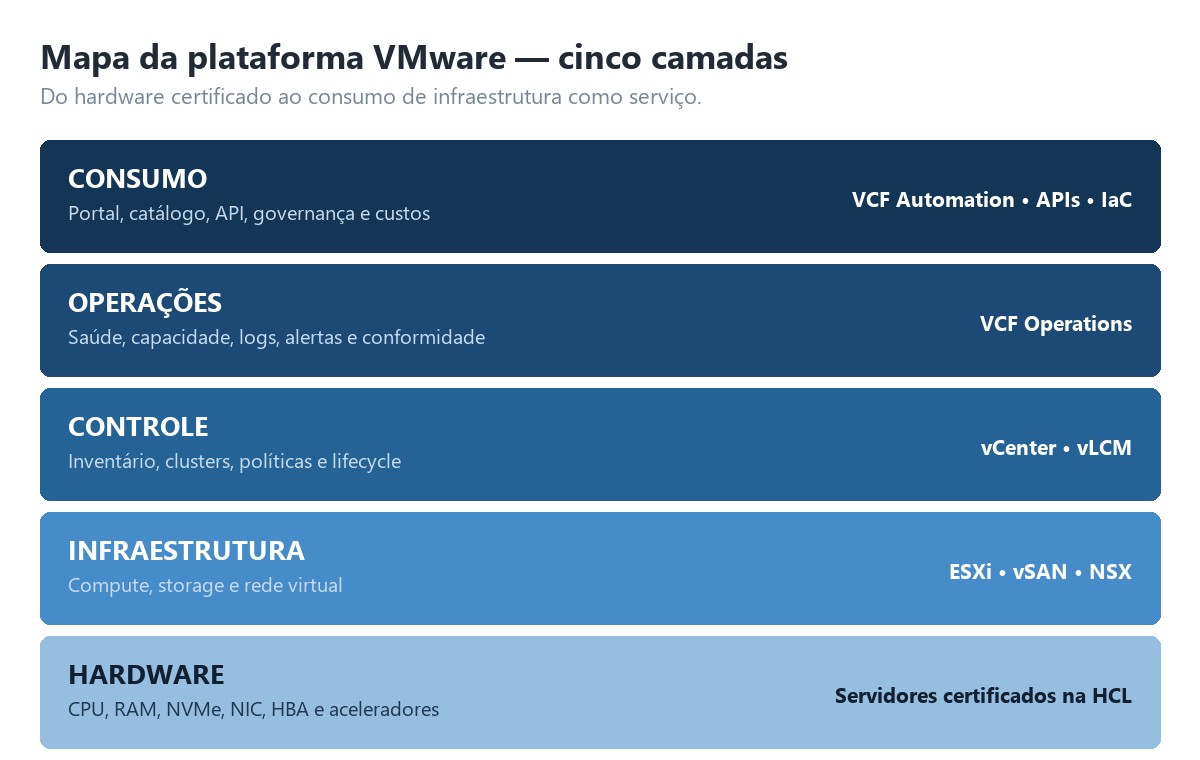
La pila VMware comienza en el ESXi, el hipervisor bare metal instalado directamente en los servidores. El vCenter Server agrega inventario, políticas, clusters y servicios distribuidos. El VVF empaqueta la plataforma de workloads y HCI; el VCF amplía el conjunto hacia una nube privada full stack con red definida por software, automatización, gestión de flota, Kubernetes y servicios avanzados.
| Capa | Función principal | Tecnologías típicas |
|---|---|---|
| Consumo | Portal, catálogo, API, gobernanza y costos | VCF Automation, APIs, IaC |
| Operaciones | Salud, capacidad, logs, alertas y cumplimiento | VCF Operations |
| Control | Inventario, clusters, políticas y lifecycle | vCenter, vLCM |
| Infraestructura | Compute, storage y red virtual | ESXi, vSAN, NSX |
| Hardware | CPU, RAM, NVMe, NIC, HBA y aceleradores | Servidores certificados en la HCL |
Decisión en una frase: elija VVF cuando el centro de la necesidad es virtualización y HCI gestionada; elija VCF cuando la meta es operar una nube privada integrada, automatizada, multitenant y orientada al autoservicio.
Principales capacidades
| Capacidad | Qué entrega | Valor operacional |
|---|---|---|
| vMotion | Migración de VMs encendidas entre hosts | Mantenimiento sin parada planificada |
| HA | Reinicio automático tras falla de host | Recuperación rápida |
| DRS | Balanceo orientado a recursos | Mejor utilización y menor hotspot |
| vSAN | Storage distribuido basado en políticas | HCI y escala horizontal |
| VKS | Kubernetes integrado al plano de control | VMs y containers en la misma plataforma |
| NSX / VPC | Red y aislamiento definidos por software | Agilidad y segmentación |
| VCF Operations | Observabilidad, capacidad y diagnóstico | Menor tiempo de resolución |
| VCF Automation | Catálogo, workflows, políticas y APIs | IaaS de autoservicio |
Tres planos operacionales
- Plano de datos: VMs, containers, redes y volúmenes se ejecutan en los hosts.
- Plano de control: vCenter, managers y controladores mantienen estado, inventario y políticas.
- Plano de gestión: Operations, Automation y Fleet Management monitorean, provisionan y actualizan la plataforma.
ESXi: la capa de virtualización
El ESXi proporciona aislamiento de workloads y agenda vCPUs sobre CPUs físicas, gestiona memoria, dispositivos, drivers, datastores y switches virtuales. Su diseño reduce la superficie de un sistema operativo de propósito general, pero exige disciplina de firmware, compatibilidad, hardening y lifecycle.
CPU y NUMA
- Dimensione vCPU según la demanda observada, no según el máximo teórico. VMs sobredimensionadas pueden esperar más tiempo para ser agendadas.
- Mantenga las VMs críticas dentro de un nodo NUMA cuando sea posible; VMs muy anchas pueden acceder a memoria remota con mayor latencia.
- Analice CPU Ready, Co-Stop, utilización, latencia de la aplicación y frecuencia efectiva en conjunto.
Memoria
- Evite la presión sostenida que active ballooning, compresión y swapping; el swap del host es el último recurso y degrada la latencia.
- Las Reservations garantizan capacidad, los Limits imponen un techo y los Shares definen prioridad bajo contención.
- Considere el overhead del hipervisor, agentes, vSAN y servicios de infraestructura al calcular el cluster.
Red virtual
| Elemento | Uso | Recomendación |
|---|---|---|
| vSwitch Standard | Host aislado o entorno simple | Bueno para pequeña escala; configuración por host |
| vSphere Distributed Switch | Política central y recursos avanzados | Preferible en clusters empresariales |
| Port group | VLAN y política lógica | Estandarice nombres e IDs |
| vmkernel | Management, vMotion, vSAN, NFS, FT | Separe el tráfico y aplique redundancia |
| NIC teaming | Disponibilidad y distribución | Valide failover con los switches físicos |
Storage y ciclo de vida
El ESXi puede consumir VMFS en SAN FC/iSCSI, NFS y vSAN. La elección debe equilibrar latencia, throughput, resiliencia, operación, integración de backup y costo. Una VM usa archivos de configuración, discos virtuales, snapshots temporales y logs — los snapshots no sustituyen al backup. Para el lifecycle, valide hardware, firmware, drivers y la matriz de compatibilidad; defina la imagen deseada en el vSphere Lifecycle Manager; pruebe en un grupo piloto; entre en mantenimiento evacuando los workloads; y valide salud, red, storage, alarmas y desempeño después del cambio.
Métrica que importa: IOPS sin tamaño de bloque, proporción lectura/escritura, profundidad de cola y latencia es un número incompleto. Registre el perfil completo del workload.
vCenter Server: control central
El vCenter Server Appliance centraliza hosts, VMs, plantillas, tags, permisos, clusters y tareas. No se encuentra en la ruta de I/O de las VMs: si el vCenter se detiene, los workloads continúan, pero las funciones de gestión y los servicios dependientes quedan limitados. Su recuperación debe planificarse y probarse.
| Objeto de inventario | Responsabilidad |
|---|---|
| Datacenter | Contenedor lógico de clusters, hosts, redes y datastores |
| Cluster | Dominio de HA, DRS, EVC y lifecycle |
| Resource pool | Reserva, límite y prioridad jerárquica |
| Folder | Organización y alcance de permiso |
| Tag / Category | Metadato para política, automatización y gobernanza |
| Content Library | Plantillas, OVFs, ISOs y distribución de contenido |
Alta disponibilidad del vCenter
Proteja la appliance con backup nativo basado en archivo hacia un destino externo, HA del cluster y copia coherente de las configuraciones. La estrategia debe incluir la restauración de la appliance, DNS, NTP, certificados, credenciales de break-glass y dependencias de identidad. Evite crear una dependencia circular en la que el único DNS, AD o repositorio necesario para recuperar el vCenter esté no disponible dentro del propio entorno afectado.
Antipatrones de administración
- Ejecutar la operación diaria con administrator@vsphere.local.
- Conceder una función global cuando el operador actúa solo en un folder o cluster.
- Usar la misma cuenta técnica para backup, monitoreo y automatización.
- Mantener certificados, DNS y NTP sin monitoreo de validez y disponibilidad.
- Confiar únicamente en snapshot de la appliance en lugar de backup nativo restaurable.
Principio de RBAC: asigne grupos corporativos a funciones mínimas en el alcance correcto. Evite permisos directos a usuarios y no use Administrator para tareas diarias.
Licenciamiento: VCF versus VVF
El modelo actual es de suscripción por núcleo físico. Para cada CPU física de un host ESXi, se aplica un mínimo de 16 núcleos licenciables, incluso si el procesador tiene menos. Todos los núcleos físicos que ejecutan el software deben ser considerados. Las condiciones comerciales, plazo, soporte y add-ons deben confirmarse en la propuesta vigente.
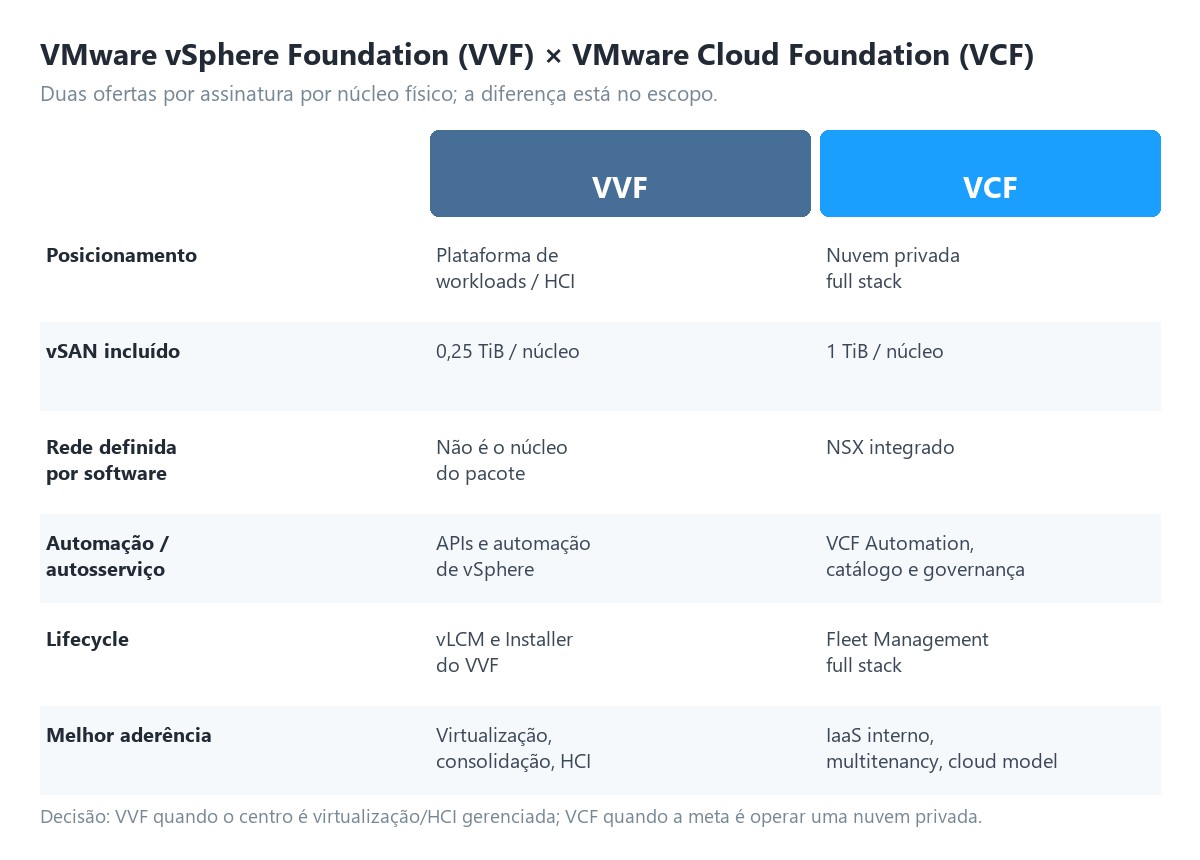
| Criterio | VMware vSphere Foundation (VVF) | VMware Cloud Foundation (VCF) |
|---|---|---|
| Posicionamiento | Plataforma de workloads / HCI | Plataforma completa de nube privada |
| Compute | vSphere Enterprise Plus + vCenter Standard | vSphere integrado al stack VCF |
| Storage incluido | 0,25 TiB vSAN por núcleo | 1 TiB vSAN por núcleo |
| Red definida por software | No es el núcleo del paquete | NSX integrado |
| Operaciones | VCF Operations para infraestructura | Operaciones unificadas full stack |
| Automatización / autoservicio | APIs y automatización de vSphere; alcance menor | VCF Automation, catálogo y gobernanza |
| Lifecycle | vLCM e Installer del VVF | Fleet Management y lifecycle full stack |
| Kubernetes | VKS incluido | VKS integrado a la nube privada |
| Mejor aderencia | Virtualización, consolidación, HCI | IaaS interno, multitenancy, red/seguridad y cloud operating model |
Fórmula de núcleos
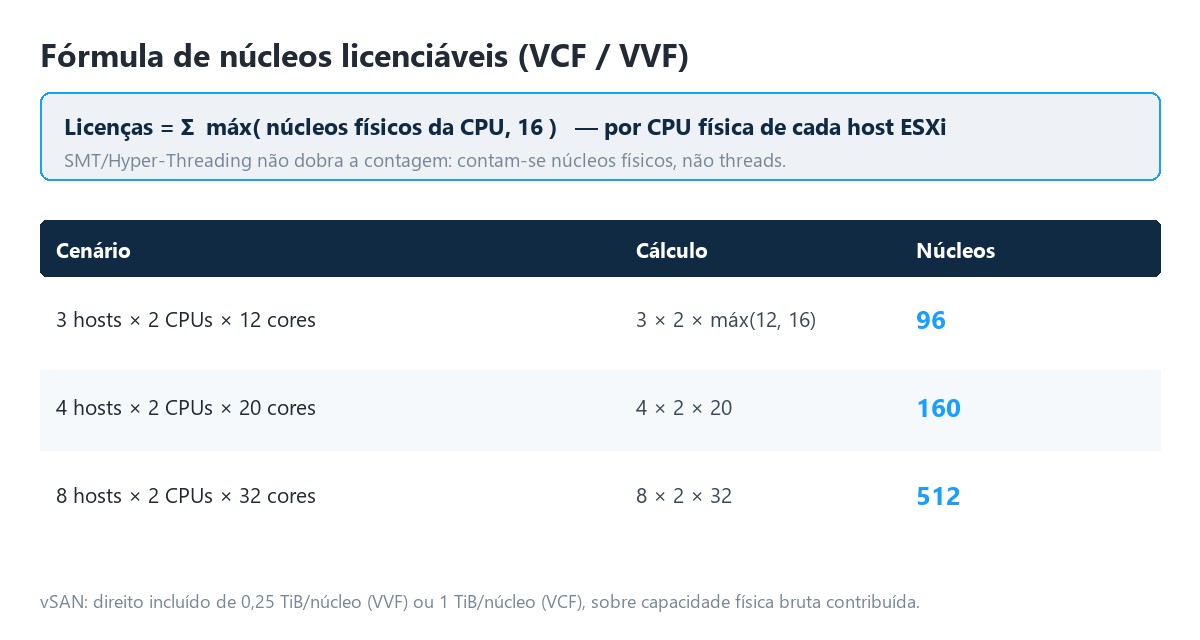
| Escenario | Cálculo | Núcleos licenciables |
|---|---|---|
| 3 hosts, 2 CPUs/host, 12 cores/CPU | 3 × 2 × máx(12, 16) | 96 |
| 4 hosts, 2 CPUs/host, 20 cores/CPU | 4 × 2 × 20 | 160 |
| 8 hosts, 2 CPUs/host, 32 cores/CPU | 8 × 2 × 32 | 512 |
Ejemplo vSAN
Cluster con 4 hosts, 2 CPUs de 20 cores por host: 160 núcleos. El derecho incluido es 40 TiB en el VVF y 160 TiB en el VCF. Si el cluster contribuye con 120 TiB brutos al vSAN, el VVF requeriría 80 TiB adicionales; el VCF tendría cobertura incluida, sujeto a los términos vigentes. La licencia considera la capacidad física bruta contribuida, no el espacio útil mostrado después de las políticas y el overhead.
VCF 9: gestión de licencia
- Archivo único de licencia y visión consolidada en el VCF Operations, sustituyendo varias claves por componente.
- Modo conectado o desconectado / air-gapped.
- Envío y actualización de uso dentro de cada ventana de 180 días.
- Sin datos de uso, los workloads existentes continúan, pero la gestión puede quedar desconectada y nuevos workloads dejan de crearse, según la visión general oficial del VCF 9.
Atención comercial: no estime el TCO solo multiplicando un "precio por core" encontrado en internet. Incluya plazo de suscripción, soporte, add-ons, vSAN excedente, hardware certificado, servicios, impuestos, cambio, migración y operación.
Árbol de decisión
- ¿Necesita solo consolidar VMs, HA/DRS, vMotion, storage externo o HCI simple? Comience evaluando VVF.
- ¿Necesita NSX integrado, VPCs, autoservicio, catálogo, gobernanza y lifecycle full stack? Evalúe VCF.
- ¿Necesita alta densidad de vSAN? Compare el derecho de 0,25 TiB/core del VVF con 1 TiB/core del VCF y los add-ons.
- ¿Necesita DR, seguridad avanzada, balanceo o protección contra ransomware? Verifique los advanced services; no todo forma parte del core.
Paneles de gestión y observabilidad
El panel correcto depende de la pregunta. El vSphere Client es excelente para la administración de objetos y tareas. El VCF Operations correlaciona salud, capacidad, costo, alertas y tendencias. El VCF Automation entrega catálogo y gobernanza de consumo. El Fleet Management organiza el lifecycle del stack.
| Panel | Usuario principal | Preguntas respondidas |
|---|---|---|
| vSphere Client | Administrador de virtualización | ¿Qué VM, host, red o datastore necesita acción? |
| VCF Operations | NOC, SRE, capacidad, FinOps | ¿Dónde hay riesgo, desperdicio, anomalía o saturación? |
| VCF Automation | DevOps, platform team, usuarios internos | ¿Cómo solicitar y gobernar infraestructura como servicio? |
| Fleet Management | Equipo de la plataforma | ¿Qué instancias, versiones, credenciales y updates componen la flota? |
| Business Services Console | Gestión de suscripción | ¿Qué asignación y consumo de licencia existe? |
Dashboard operacional recomendado
| Bloque | Indicadores |
|---|---|
| Disponibilidad | Hosts desconectados, HA admission control, VMs sin redundancia, fallas de hardware |
| CPU | Uso, Ready, Co-Stop, contención, frecuencia y NUMA |
| Memoria | Consumed, Active, balloon, compression, swap y reservas |
| Storage | Latencia lectura/escritura, IOPS, throughput, congestión, capacidad y resync |
| Red | Drop, error, saturación, failover, latencia y pérdida |
| Capacidad | Días restantes, reclaim, crecimiento, headroom N+1/N+2 |
| Experiencia | Tiempo de provisionamiento, fallas de workflow, incidentes y SLO |
Evite el ruido: un panel con 200 alertas sin dueño es decoración. Consolide síntomas correlacionados, defina SLOs y genere tickets solo cuando haya una acción clara — con síntoma, causa probable, contexto y acción (runbook, responsable, prioridad y criterio de cierre).
Active Directory, Entra ID y Azure
"Azure AD" pasó a llamarse Microsoft Entra ID. El vCenter puede federar autenticación con proveedores corporativos, permitiendo SSO y políticas modernas. El Active Directory tradicional sigue siendo relevante en entornos on-premises. La arquitectura debe distinguir autenticación, autorización y sincronización de identidades.
| Modelo | Cuándo usarlo | Puntos de atención |
|---|---|---|
| AD over LDAP | AD local e integración clásica | TLS, certificados, cuentas de bind y dependencia de DC |
| Integrated Windows Authentication | Legados específicos | Evaluar soporte y dirección de producto |
| AD FS | Federación ya estandarizada en AD FS | Disponibilidad del farm, claims y certificados |
| Microsoft Entra ID | Cloud identity, MFA y acceso condicional | Aplicación corporativa, grupos, claims y cuentas de emergencia |
| Okta / PingFederate | IdP corporativo alternativo | Mapeo de grupos y ciclo de certificado |
Flujo recomendado con Entra ID
- Crear y autorizar la aplicación corporativa según la documentación de la versión del vCenter.
- Configurar el proveedor de identidad en el vCenter y validar URLs, tenant, client ID y certificados/secretos cuando aplique.
- Mapear grupos de Entra ID a funciones del vCenter con menor privilegio.
- Aplicar MFA y Conditional Access en el IdP, con excepciones controladas solo para recuperación.
- Probar login, logout, expiración, remoción de grupo, indisponibilidad del IdP y cuenta break-glass.
Ejemplo de grupos
| Grupo corporativo | Función sugerida | Alcance |
|---|---|---|
| GG-VMW-Platform-Admins | Administrador de plataforma | vCenter/Datacenter, grupo restringido |
| GG-VMW-VM-Ops | Operador de VM personalizado | Folders/Resource Pools de producción |
| GG-VMW-Auditors | Read-only + eventos | Datacenter |
| GG-VMW-Backup | Permisos mínimos del producto de backup | Objetos necesarios |
| GG-VMW-Developers | Consumidor de catálogo | Proyectos/organizaciones en Automation |
Frontera importante: conectar el vCenter a Entra ID no "mueve el VMware a Azure" — es federación de identidad. La extensión de workloads, DR u operación en nube pública son decisiones arquitectónicas separadas. Mantenga al menos dos cuentas locales de recuperación protegidas en bóveda, que funcionen incluso si DNS, AD, Entra ID o la conectividad externa fallan.
Orquestación, automatización y APIs
La automatización ejecuta tareas; la orquestación coordina varias tareas, dependencias, aprobaciones, políticas, rollback y estado. En VCF, la meta es transformar infraestructura en un servicio consumible con guardrails, y no solo escribir scripts de creación de VM.
| Capa | Herramientas | Ejemplo |
|---|---|---|
| API / SDK | vSphere API, REST, Unified SDK | Crear VM y consultar inventario |
| CLI | PowerCLI, govc, esxcli | Informes y operación en lote |
| IaC | Terraform providers | Declarar redes, VMs y políticas |
| Workflow | VCF Automation Orchestrator | Aprobación, IPAM, DNS, CMDB y rollback |
| Catálogo | VCF Automation | Blueprint/templating y autoservicio |
| Configuración guest | Ansible, scripts, cloud-init | Instalar middleware y aplicar baseline |
Buenas prácticas
- Idempotencia: repetir no debe crear duplicados ni corromper el estado.
- Secretos: usar vault, rotación e identidades de servicio; nunca incrustar contraseñas en código.
- Tags obligatorios: owner, application, environment, data-class, backup-policy, cost-center y expiry.
- Git: versionar plantillas y workflows, revisar por pull request y promover entre entornos.
- Observabilidad: registrar requester, parámetros, etapas, retorno y correlation ID.
- Rollback: distinguir acción reversible de acción destructiva y solicitar la aprobación adecuada.
Gobernanza mínima del catálogo
| Control | Implementación |
|---|---|
| Cuota | Límite por proyecto, entorno y clase de recurso |
| Aprobación | Solo cuando el riesgo, costo o privilegio lo justifique |
| Expiración | TTL estándar para laboratorio y revisión antes de la renovación |
| Evidencia | Owner, ticket, versión de la plantilla y resultado del workflow |
| Desmantelamiento | Backup final cuando sea necesario, revocación de DNS/IP y baja en la CMDB |
Resultado esperado: una solicitud estandarizada puede pasar de días a minutos, pero el KPI correcto incluye tasa de éxito, cumplimiento, retrabajo, costo y tiempo de recuperación — no solo la velocidad.
Desempeño, sizing y benchmarks
El desempeño debe medirse de punta a punta. El hipervisor puede estar saludable mientras la base de datos, la red o el storage limitan la aplicación. Use baseline, percentiles y pruebas controladas; los promedios esconden picos.
| Dominio | Indicador | Señal de investigación |
|---|---|---|
| CPU | CPU Ready | Crecimiento sostenido con latencia de la aplicación |
| CPU | Co-Stop | VM SMP ancha esperando ser agendada |
| Memoria | Balloon / Swap | Presión real o reservas inadecuadas |
| Storage | Latencia guest/kernel/device | Localizar la cola y la capa limitante |
| Storage | IOPS + bloque + R/W | Caracterizar la demanda, no solo el volumen |
| Red | Drop / error / throughput | Cola, MTU, driver, uplink o congestión |
| vSAN | Congestion / resync | Impacto de rebuild, política o dispositivo |
Ejemplo 1: cluster de virtualización general
Cuatro hosts, cada uno con 2 CPUs de 24 cores y 512 GB de RAM. Total bruto: 192 cores y 2.048 GB. Reservando un host para falla N+1, la capacidad operacional aproximada es 144 cores y 1.536 GB antes del overhead. Con 120 VMs de promedio 2 vCPU y 8 GB, hay 240 vCPU y 960 GB configurados. La proporción vCPU:pCore operacional es 1,67:1 y la memoria configurada ocupa el 62,5% de la capacidad N+1.
| Ítem | Valor | Lectura |
|---|---|---|
| CPU bruta | 192 cores | 4 × 2 × 24 |
| CPU N+1 | 144 cores | 3 hosts disponibles |
| vCPU configurada | 240 vCPU | 120 × 2 |
| Proporción vCPU:pCore N+1 | 1,67:1 | Conservadora para workload mixto |
| RAM N+1 | 1.536 GB | Antes del overhead |
| RAM de VMs | 960 GB | Headroom nominal de 576 GB |
Ejemplo 2: storage transaccional
Demanda de pico de 80.000 IOPS, bloque de 8 KiB, 70% lectura y 30% escritura. Throughput lógico aproximado: 80.000 × 8 KiB = 625 MiB/s. La arquitectura debe sostener el patrón con latencia compatible, fallas de dispositivo y política de protección. Pruebe también rebuild/resync, snapshots y backup, ya que el steady state por sí solo no representa la operación real.
Ejemplo 3: metas publicadas por el fabricante
| Métrica publicada | Valor de referencia | Contexto |
|---|---|---|
| Migración end-to-end | Hasta 65% más rápida | Procesamiento paralelo de DRS vMotion |
| CPU fuente en vMotion cifrado | Hasta 70% menor | Offload Intel QAT en hardware compatible |
| Escala de "monster VM" | Hasta 960 vCPU y 16 TB RAM | Límite de la generación actual del VVF |
| Ganancia en sistemas 4-socket | Hasta 68% | Agendamiento topology/NUMA-aware |
| vGPU vMotion | Hasta 6× más rápido | Offload y redes de mayor ancho de banda |
| Troubleshooting | Hasta 60% menos esfuerzo | Diagnóstico proactivo full stack |
Cuidado con el "hasta": estos valores dependen del hardware, la versión y la metodología, y no deben sumarse para formar un business case. Haga una PoC con el perfil real y criterios de aceptación definidos — defina SLO e hipótesis, capture el baseline de producción, reproduzca CPU/memoria/I/O/red y concurrencia, pruebe steady state, pico, mantenimiento, falla y recuperación, y compare percentiles, no solo el promedio.
Red, storage, disponibilidad y DR
Una plataforma resiliente se diseña a partir del impacto aceptable, no de una lista de productos. Traduzca la criticidad en SLO, RPO y RTO, y solo entonces elija HA, replicación, backup y DR.
| Tráfico | Función | Práctica recomendada |
|---|---|---|
| Management | Gestión de hosts y appliances | Redundancia, ACL y acceso administrativo controlado |
| vMotion | Migración de memoria/estado | Alto ancho de banda, baja latencia y aislamiento |
| vSAN | I/O y resync del cluster | Red dedicada/lógica, compatibilidad y headroom |
| Storage IP | NFS / iSCSI | Multipathing, colas, MTU coherente y QoS cuando sea necesario |
| Workloads | Aplicaciones y tenants | Segmentación, políticas y observabilidad |
| Backup / replicación | Copia y DR | Evitar competir con la producción en ventanas críticas |
Disponibilidad
- N+1 protege contra una falla de host; N+2 puede ser necesario durante el mantenimiento o en clusters críticos.
- HA reinicia VMs — no equivale a continuidad sin interrupción. Fault Tolerance atiende casos específicos con exigencias propias.
- Admission Control debe reservar capacidad de failover; desactivarlo enmascara el riesgo.
- Stretched cluster reduce el RTO para falla de sitio, pero exige latencia, witness, red y diseño de dependencias compatibles.
Backup y DR
| Mecanismo | Protege contra | No sustituye |
|---|---|---|
| HA | Falla de host | Backup o DR de sitio |
| vMotion | Mantenimiento planificado | Replicación o backup |
| Snapshot | Cambio de corto plazo | Backup independiente |
| Replicación | Pérdida de sitio/array según el diseño | Copia inmutable contra corrupción/ransomware |
| Backup inmutable | Exclusión, corrupción y ransomware | Plan de continuidad y capacidad de restore |
| SRM / orquestación de DR | Secuencia y prueba de failover | Infraestructura y datos en el destino |
Prueba de verdad: RPO y RTO solo son confiables después de una prueba que restaure aplicaciones, identidad, DNS, red, secretos e integraciones — no solo encender VMs. La prueba debe cubrir falla simultánea de host y ruta de storage en pico, indisponibilidad de vCenter/DNS/NTP/IdP/KMS durante la recuperación, pérdida de sitio con aislamiento parcial, restore aislado tras ransomware y el retorno al sitio primario.
Seguridad, hardening y operación
La seguridad en VMware abarca hardware, ESXi, vCenter, red, identidades, VMs, automatización y cadena de suministro. El objetivo es reducir la superficie, limitar el movimiento lateral, detectar drift y recuperar rápidamente.
| Control | Implementación |
|---|---|
| Identidad | Federación, MFA, grupos, menor privilegio y break-glass |
| Plano de gestión | Red dedicada, jump host / PAM, ACL y logs centralizados |
| Host | Secure Boot, TPM 2.0, lockdown cuando aplique, servicios mínimos |
| Cifrado | TLS actualizado, VM/vSAN encryption y KMS con HA |
| Red | Segmentación, firewall distribuido / add-ons según la licencia |
| Lifecycle | Parches, HCL, imágenes deseadas y ventana de remediación |
| Auditoría | Eventos, cambios, login, tareas, configuración y retención |
| Recuperación | Backups inmutables, restore probado y credenciales fuera del dominio de falla |
Rutina Day 2
- Diario: alarmas críticas, capacidad de failover, backups, hardware y tareas fallidas.
- Semanal: anomalías, snapshots antiguos, VMs huérfanas, datastore, resync y parches urgentes.
- Mensual: capacity forecast, derechos de licencia, cuentas privilegiadas, certificados y restore muestral.
- Trimestral: prueba de DR, revisión de RBAC, firmware/HCL, runbooks y riesgos de dependencia.
- Anual: arquitectura, contrato, TCO, ciclo de hardware, SLOs y plan de modernización.
Arquitecturas de referencia e implementación
Patrón A — VVF con storage externo
| Componente | Diseño |
|---|---|
| Compute | 4 a 8 hosts ESXi, N+1, CPUs compatibles y RAM según el perfil |
| Control | vCenter + VCF Operations |
| Storage | SAN FC/iSCSI o NFS redundante; multipathing |
| Red | vDS, uplinks redundantes y VLANs segregadas |
| Uso | Consolidación de VMs, ERP, base de datos, middleware y VDI |
Patrón B — VVF HCI con vSAN
| Componente | Diseño |
|---|---|
| Cluster | Mínimo técnico según la arquitectura; 4+ hosts es común para margen |
| Storage | vSAN ESA/OSA según hardware y compatibilidad |
| Gestión | vCenter + Operations + SPBM |
| Escala | Agregar nodos o usar storage cluster / disaggregated según soporte |
| Uso | Operación simplificada de compute y storage en un cluster |
Patrón C — VCF private cloud
| Componente | Diseño |
|---|---|
| Management domain | Servicios de control, gestión y lifecycle |
| Workload domains | Clusters separados por SLA, hardware, tenant o finalidad |
| Red | NSX, VPCs, overlays y gateways según la arquitectura |
| Consumo | Automation, catálogo, proyectos, quotas y políticas |
| Operación | Operations, Fleet Management, logs e integraciones |
| Uso | Nube privada, IaaS interno, apps modernas, Kubernetes e IA privada |
Regla de diseño: no empiece por el número de hosts. Empiece por el workload, el dominio de falla, el SLA, el crecimiento, la compatibilidad, la operación y el licenciamiento — el hardware es consecuencia. Las fases son assessment, HLD, LLD, build, validate, migrate y operate.
Migración, costos y checklist
| Estrategia | Ventaja | Riesgo / limitación |
|---|---|---|
| vMotion / cross-vCenter | Baja interrupción cuando es compatible | Red, latencia, versiones, EVC y storage |
| HCX | Movilidad a escala y extensión de red | Planificación de appliances y throughput |
| Backup / restore | Independiente y verificable | Ventana y tiempo de copia |
| Replicación | RPO reducido y cutover controlado | Consistencia y bandwidth |
| Rebuild | Moderniza SO y configuración | Más esfuerzo de aplicación y prueba |
Modelo de TCO en 3 años
| Categoría | Ítems |
|---|---|
| Software | VCF/VVF, vSAN adicional, advanced services, backup, observabilidad |
| Hardware | Hosts, discos, switches, ópticas, SAN, soporte y piezas |
| Facilities | Rack, energía, refrigeración, espacio y conectividad |
| Servicios | Assessment, implementación, migración, capacitación y soporte |
| Operación | Equipo, guardia, parches, capacidad, auditoría e incidentes |
| Riesgo | Downtime, lock-in, atraso, retrabajo y obsolescencia |
Checklist de decisión VVF × VCF
- Inventario de hosts, sockets, cores y capacidad vSAN bruta concluido.
- Workloads clasificados por criticidad, RPO, RTO, CPU, RAM, I/O, red y crecimiento.
- Necesidad de NSX, microsegmentación, VPCs y multitenancy validada.
- Necesidad de catálogo, autoservicio, quotas, chargeback y APIs validada.
- Advanced services separados del core y confirmados en la propuesta.
- TCO de 3 a 5 años incluyendo hardware, migración, operación, soporte, cambio e impuestos.
- PoC midiendo percentiles, falla, mantenimiento, backup y restore.
- Plan de salida/movilidad y portabilidad de datos documentado.
Glosario esencial
| Término | Definición breve |
|---|---|
| ESXi | Hipervisor bare metal de la plataforma vSphere. |
| vCenter | Plano central de gestión, inventario y políticas. |
| VCF | VMware Cloud Foundation; plataforma full stack de nube privada. |
| VVF | VMware vSphere Foundation; plataforma de workloads / HCI. |
| vSAN | Storage definido por software integrado al vSphere. |
| NSX | Red y seguridad definidas por software. |
| VKS | vSphere Kubernetes Service. |
| DRS | Distributed Resource Scheduler. |
| HA | High Availability; reinicio automático tras falla. |
| SPBM | Storage Policy-Based Management. |
| RPO | Pérdida máxima de datos aceptable. |
| RTO | Tiempo máximo para restaurar el servicio. |
| HCL | Lista de compatibilidad de hardware/software. |
| EVC | Compatibilidad de CPU para movilidad entre hosts. |
| NUMA | Arquitectura de memoria no uniforme en servidores multiprocesador. |
Conclusión
ESXi y vCenter siguen siendo la base robusta para la virtualización empresarial. El VVF organiza esa base como plataforma moderna de workloads y HCI. El VCF añade el modelo operacional de nube privada: red integrada, gestión full stack, lifecycle de flota, automatización, autoservicio y gobernanza. La elección correcta no es "cuál tiene más recursos", sino cuál atiende al operating model, al riesgo y al TCO de la organización.
Recomendación práctica: para un entorno tradicional de VMs con equipo central y storage externo, el VVF tiende a ser el punto de partida natural. Para ofrecer IaaS interno, múltiples tenants, Kubernetes, automatización end-to-end y red definida por software, el VCF tiende a reducir las integraciones manuales — siempre que la organización adopte procesos de plataforma y utilice esas capacidades.
Fuentes oficiales y lectura complementaria
Este material fue preparado a partir de fuentes oficiales de Broadcom/VMware, con fecha de corte el 2 de septiembre de 2026. Consulte siempre las release notes, matrices de interoperabilidad, el VMware Compatibility Guide, el Product Guide y la propuesta comercial vigentes.
- Licensing for VMware Cloud Foundation 9.0
- VMware Cloud Foundation 9.x — Data Sheet
- VMware vSphere Foundation — Data Sheet
- Feature Comparison & Upgrade Paths: VCF and VVF
- Counting Cores for VCF/VVF and TiBs for vSAN — Broadcom KB 313548
- VCF 9.0 Product Subscription and Licensing
- vCenter identity federation with Microsoft Entra ID
- Performance Best Practices for VMware vSphere 8
- Operations in VMware Cloud Foundation 9.0
- Five reasons to upgrade from VVF to VCF
Nota editorial
Nombres, marcas y productos pertenecen a sus titulares. Los ejemplos numéricos de capacidad y desempeño se organizaron con fines didácticos y no constituyen cotización, benchmark de laboratorio ni asesoría de licenciamiento — el dimensionamiento y la economía finales dependen del hardware real, del SLA y del contrato comercial de cada proyecto.
EnQ Digital: Cloud • Data Center • Baremetal • Storage • Soporte • Seguridad