
La inteligencia artificial evolucionó de experimentos académicos y sistemas de reglas hacia modelos generativos capaces de conversar, crear imágenes, generar video, programar y operar procesos. A partir de este giro, la discusión sobre IA dejó de limitarse solo al software: la capacidad de GPU, la energía disponible, la refrigeración y la conectividad pasaron a determinar cuánto, dónde y con qué costo la IA puede escalar.
La ecuación de la IA moderna: modelos + datos + computación + energía + refrigeración + conectividad + capital. Si uno de estos componentes se convierte en un cuello de botella, la escala de la IA también se convierte en un cuello de botella.
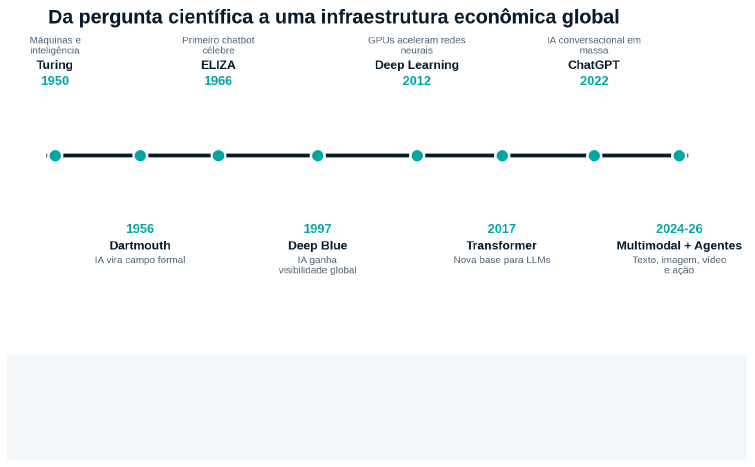
Historia y evolución: de las ideas de Turing al deep learning
En 1950, Alan Turing ayudó a transformar la pregunta "¿pueden las máquinas pensar?" en un problema científico. En 1956, el encuentro de Dartmouth consolidó el término Artificial Intelligence y organizó un campo de investigación dedicado al lenguaje, el razonamiento, la abstracción y el aprendizaje por máquinas.
¿Por qué hubo períodos de frustración? Muchas ideas eran buenas, pero el hardware, los datos y el costo computacional todavía eran insuficientes. Los llamados "AI winters" recuerdan que la innovación de algoritmos sin infraestructura puede no alcanzar la escala.
Reglas y sistemas expertos
La primera gran escuela de IA intentó representar el conocimiento en reglas explícitas: si ocurre una condición, entonces debe ejecutarse una acción. Funcionaba bien en dominios controlados, pero el mundo real tiene demasiadas excepciones, ambigüedades y combinaciones.
Machine Learning
Con más datos y capacidad de procesamiento, los sistemas empezaron a aprender patrones a partir de ejemplos. En lugar de programar todas las reglas, el desarrollador define datos, objetivo, método de entrenamiento y métricas.
Deep Learning + GPU
Las redes neuronales profundas amplificaron la capacidad de reconocimiento de imágenes, voz y lenguaje. Las GPUs, inicialmente populares en computación gráfica, se volvieron esenciales porque ejecutan un gran volumen de operaciones matemáticas en paralelo.
Chatbots, LLMs y agentes: de ELIZA a sistemas que usan herramientas
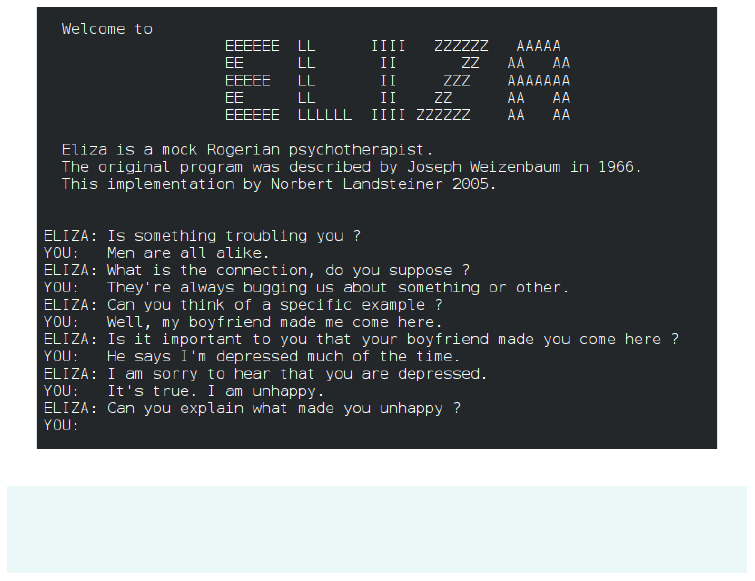
ELIZA, desarrollado por Joseph Weizenbaum en el MIT en la década de 1960, es un hito en la historia de los chatbots. Su script DOCTOR respondía mediante patrones y transformaciones de texto. El sistema no "entendía" como un modelo moderno, pero demostró cuánto puede una conversación textual inducir la percepción de inteligencia.
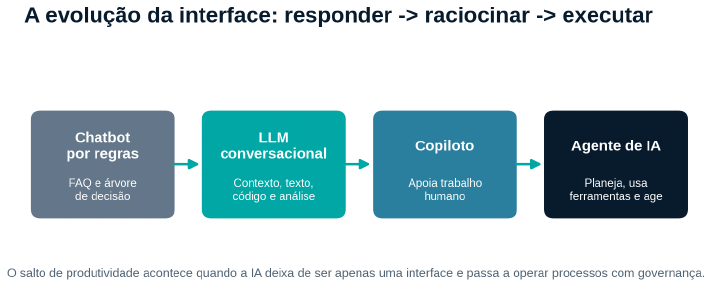
¿Qué cambió? Los bots antiguos seguían flujos. Los LLMs calculan continuaciones probables con base en representaciones aprendidas a gran escala y pueden combinar contexto, instrucciones y herramientas externas.
¿Qué caracteriza a un agente de IA?
- Recibe un objetivo y descompone la tarea en etapas.
- Consulta sistemas, APIs, bases de datos o bases RAG autorizadas.
- Usa herramientas, ejecuta acciones y registra resultados.
- Puede trabajar con otros agentes especializados.
- Exige identidad, permisos, auditoría, límites y aprobación humana cuando el riesgo aumenta.
Punto de gobernanza: cuanto mayor sea la autonomía, mayor debe ser el control de acceso, la trazabilidad, la evaluación de riesgo y la separación entre recomendación y ejecución.
Imagen, video y multimodalidad
En la visión computacional tradicional, la pregunta era: "¿qué existe en esta imagen?". Con los modelos generativos, la pregunta se convirtió en: "¿qué imagen o escena debe crearse a partir de esta descripción?". Los modelos de difusión y las arquitecturas multimodales redujeron la distancia entre el lenguaje natural y la producción visual.
| Modalidad | Antes | Ahora |
|---|---|---|
| Texto | Clasificación y búsqueda | Redacción, síntesis, código, análisis y diálogo |
| Imagen | Reconocimiento de objetos | Generación, edición, variaciones y composición |
| Audio | Transcripción y comandos | Voz sintética, clonación autorizada, traducción y diálogo |
| Video | Análisis de frames | Generación de escenas, edición y previsualización |
| Multimodal | Pipelines separados | Texto, imagen, audio y video en el mismo contexto |
Impacto creativo: marketing, diseño, juegos, audiovisual, educación y e-commerce empezaron a usar el lenguaje natural como interfaz de creación. La diferenciación competitiva pasa de "acceder a la herramienta" a construir procesos, datos, identidad y curaduría mejores.
¿Por qué el video cuesta más computación? El video añade una dimensión temporal. El modelo necesita mantener coherencia entre frames, movimiento, cámara, iluminación e identidad visual. Esto eleva la memoria, el throughput y el tiempo de inferencia, y presiona aún más la infraestructura de GPU.
Empresas y economía: productividad, automatización y nuevos modelos de negocio
La ganancia real aparece cuando el modelo, los datos y la operación se integran con gobernanza.
| Área | Aplicaciones de IA | Valor esperado |
|---|---|---|
| Comercial | Calificación, propuestas, investigación, seguimiento | Más velocidad y cobertura |
| Marketing | Contenido, segmentación, imagen, video, análisis | Más experimentación y personalización |
| Atención | Asistente, búsqueda en conocimiento, resumen | Menor tiempo de respuesta |
| Tecnología | Código, pruebas, documentación, troubleshooting | Mayor productividad técnica |
| Operaciones | Previsión, mantenimiento, visión computacional | Menos fallas y mejor utilización |
| Financiero | Conciliación, documentos, anomalías, forecast | Más control y previsibilidad |
| Gestión | BI conversacional, escenarios, copilotos ejecutivos | Decisiones más informadas |
La regla práctica: comience por el proceso, no por el modelo. Defina KPI, datos, riesgo, integración y responsable. Después elija la tecnología.
La IA corporativa tiende a migrar de herramientas individuales hacia una capa operacional: copilotos en sistemas existentes, agentes conectados a CRM/ERP/ITSM, automatización de documentos, análisis predictivo e interfaces conversacionales sobre datos propietarios.
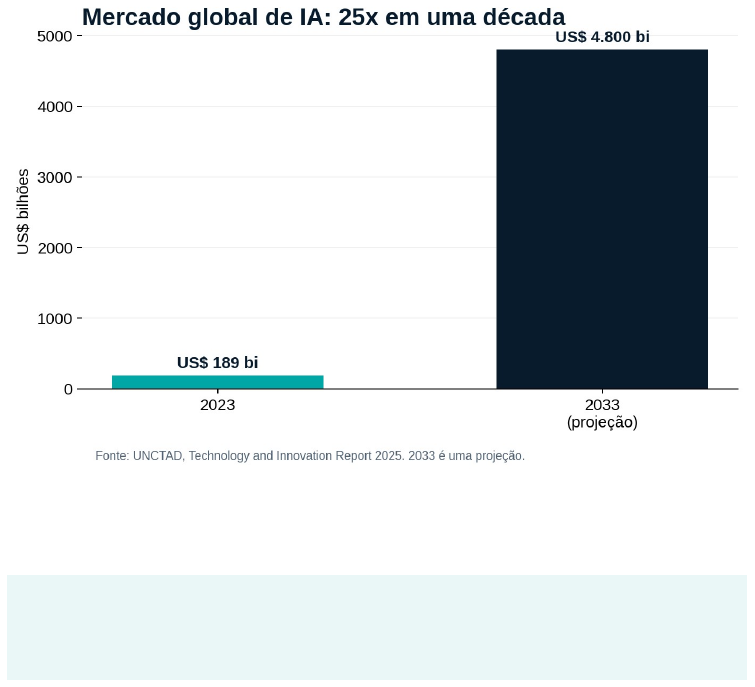
La UNCTAD proyecta que el mercado global de IA avance de US$ 189 mil millones en 2023 a US$ 4,8 billones en 2033. Se trata de una proyección, no de una garantía, pero el orden de magnitud muestra por qué chips, data centers, energía y fibra empezaron a recibir inversiones extraordinarias.
La cadena de la nueva economía: semiconductores → GPU y HBM → servidores → networking → storage → data center → energía → modelos → aplicaciones. El valor económico se distribuye entre varias capas, y el cuello de botella puede migrar de una a otra.
Infraestructura de IA: GPU, memoria, red, storage y AI Factories
Cuando un usuario genera una respuesta, una imagen o un video, la solicitud recorre redes, entra en un data center, consume memoria y compute acelerado y regresa a través de la infraestructura de conectividad. A escala de millones de usuarios, pequeñas ineficiencias se convierten en grandes costos.
Pensamiento de ingeniería: el servidor es solo un componente. Para IA a escala, todo el data center participa del desempeño: potencia por rack, cooling, topología de red, storage, fibra, automatización y operación 24x7.
| Característica | CPU | GPU / acelerador |
|---|---|---|
| Objetivo | Versatilidad y baja latencia por tarea | Paralelismo masivo |
| Núcleos | Pocos núcleos complejos | Muchos núcleos/unidades paralelas |
| Fuerza | Lógica general, sistemas, bases de datos | Matrices, tensores, entrenamiento e inferencia |
| Memoria | RAM convencional | HBM y alto ancho de banda |
| Escala IA | Coordina y prepara workloads | Ejecuta gran parte del compute neuronal |
El entrenamiento ajusta los parámetros de un modelo usando enormes volúmenes de datos y puede ocupar miles de aceleradores durante largos períodos. La inferencia es el uso del modelo ya entrenado. En servicios populares, la inferencia puede convertirse en el mayor consumo agregado porque ocurre continuamente.
El cuello de botella invisible: una GPU rápida puede quedar inactiva esperando datos, otra GPU o storage. Por eso las redes de baja latencia y el storage paralelo son parte del desempeño de la IA.
| Capa | Requisito | Por qué importa |
|---|---|---|
| Compute | GPU, CPU y aceleradores | Ejecutar entrenamiento e inferencia |
| Memoria | HBM + RAM de alta capacidad | Alimentar los aceleradores sin espera |
| Fabric | InfiniBand o Ethernet HPC/RDMA | Comunicar miles de aceleradores |
| Storage | NVMe, paralelo, alto throughput | Datasets, checkpoints y modelos |
| Energía | Subestación, UPS y distribución densa | Soportar racks de alta potencia |
| Cooling | DLC/CDU/chillers/dry coolers | Remover calor con eficiencia |
| DCI | Fibra, DWDM, rutas redundantes | Conectar regiones y clústeres |
| Software | Scheduler, drivers, observabilidad | Usar el hardware de forma eficiente |
AI Factory: el término describe una infraestructura diseñada para transformar energía y datos en capacidad de entrenamiento e inferencia a escala. La densidad por rack puede ser varias veces mayor que en entornos corporativos tradicionales.
Liquid cooling: por qué los racks de alta densidad cambian la ingeniería térmica
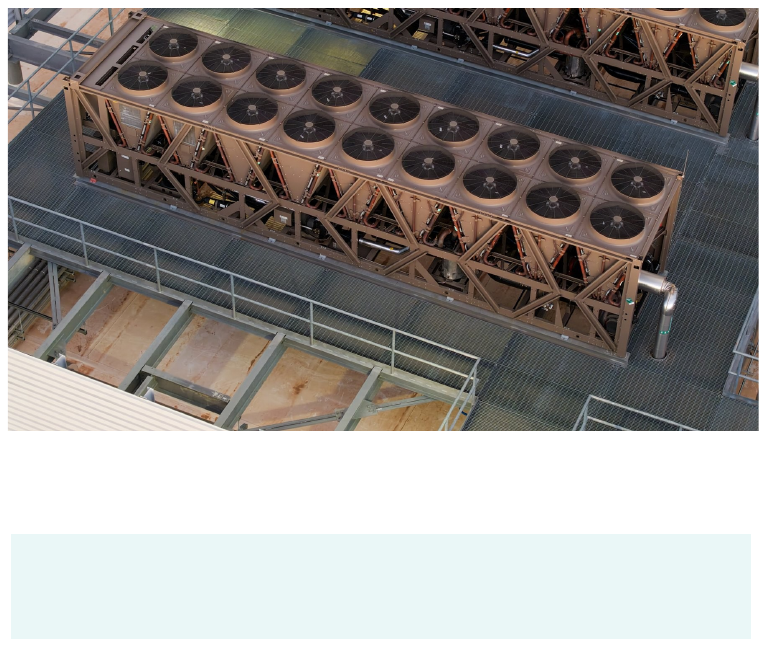
Casi toda la energía eléctrica consumida por el equipo de TI termina como calor. En racks de alta densidad, mover ese calor solo con aire exige grandes volúmenes de flujo y ventilación. La refrigeración líquida aproxima un medio térmico mucho más eficiente a la fuente de calor.
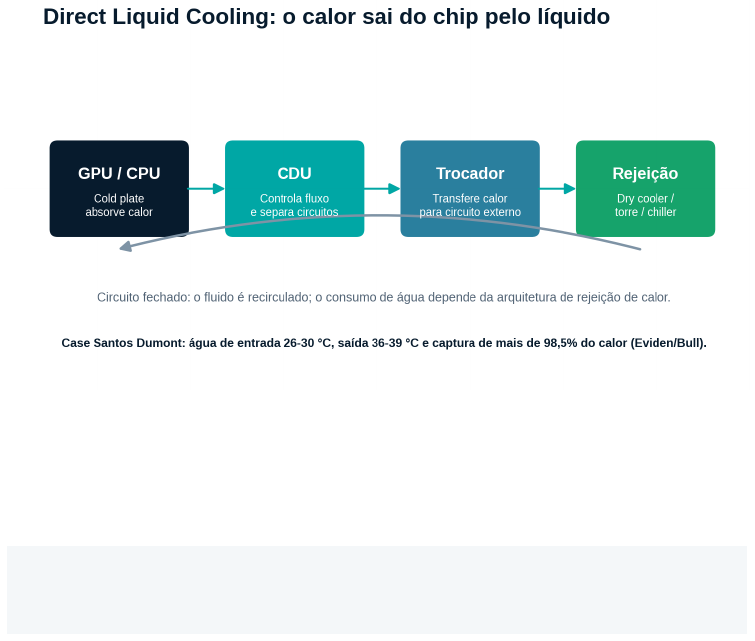
No lo confunda: liquid cooling no significa necesariamente consumo continuo de grandes volúmenes de agua. El circuito interno puede ser cerrado. El consumo hídrico depende de cómo se rechaza el calor externamente, por ejemplo, dry cooler, chiller o torre evaporativa.
¿Por qué el líquido es eficiente?
Los líquidos transportan mucho más calor por unidad de volumen que el aire. Esto permite reducir la dependencia de ventiladores, aumentar la densidad y recuperar calor a temperaturas más útiles. La ingeniería, sin embargo, se vuelve más sofisticada: calidad del fluido, presión, caudal, redundancia, detección de fugas, CDU y mantenimiento deben entrar en el proyecto.
Métrica más importante: no evalúe el cooling solo por el PUE. Para IA, observe también la densidad por rack, la temperatura del agua, la capacidad de rechazo, la redundancia, el WUE cuando corresponda y la eficiencia de la cadena eléctrica.
Case Santos Dumont: H100, GH200, MI300A, InfiniBand y DLC en Brasil
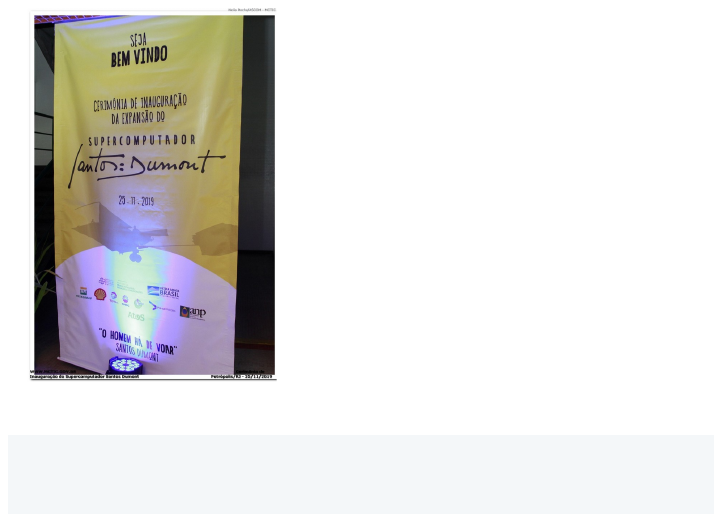
Ubicado en el LNCC, en Petrópolis-RJ, el sistema actúa como Tier-0 del SINAPAD y posee capacidad instalada del orden de 20 PFLOP/s. La configuración actual combina las plataformas BullSequana X1000 y XH3000, con diferentes generaciones de CPU y aceleradores.
El proyecto es relevante porque muestra cómo la IA y la supercomputación exigen una arquitectura integrada: aceleradores, fabric InfiniBand, storage paralelo y cooling de alta eficiencia.
| Componente | Configuración publicada |
|---|---|
| BullSequana XH3420 | 60 nodos CPU, 2x AMD Genoa-X 9684X y 1,5 TB RAM por nodo |
| BullSequana XH3145-H | 62 nodos; 4x NVIDIA H100 SXM 80 GB por nodo |
| BullSequana XH3515-H | 36 nodos; 4x NVIDIA GH200 Grace Hopper por nodo |
| BullSequana G383-R80 | 18 nodos; 2x AMD Instinct MI300A por nodo |
| Interconexión | InfiniBand de alto rendimiento y baja latencia |
| Storage | Lustre + DDN Exascaler; del orden de 4 PB agregados |
DLC en el case: Eviden/Bull informa que la expansión XH3000 usa Direct Liquid Cooling con agua de entrada entre 26°C y 30°C y retorno entre 36°C y 39°C, capturando más del 98,5% del calor de fuentes, procesadores, aceleradores, red, discos y memoria.
Densidad: según Eviden/Bull, el sistema DLC permite una densidad de hasta 5 veces la de los sistemas tradicionales refrigerados por aire. El case materializa la tendencia central de los data centers de IA: más compute por metro cuadrado exige una nueva ingeniería térmica.
Energía para IA: red, PPAs, solar, eólica, hidráulica, BESS y resiliencia
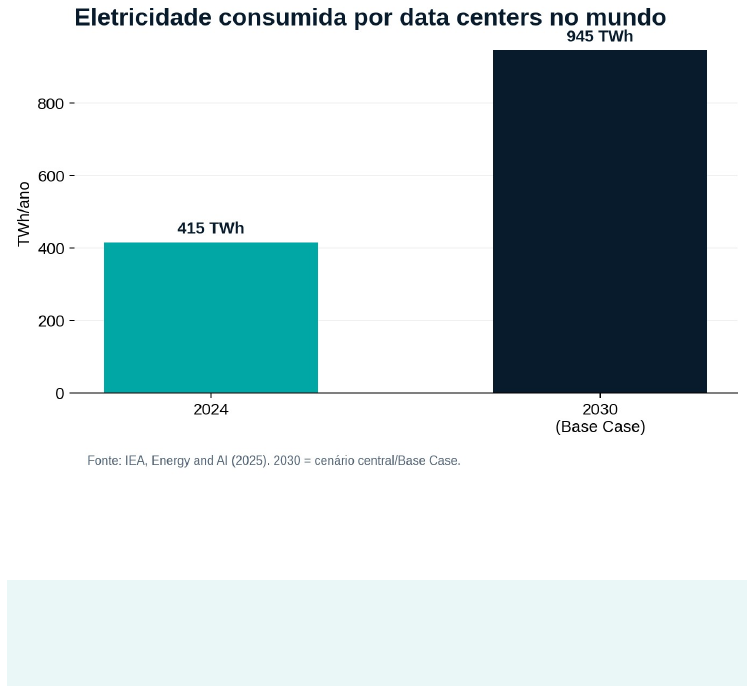
La IEA estima unos 415 TWh de electricidad consumidos por data centers en 2024, aproximadamente el 1,5% del consumo eléctrico mundial. En el escenario central, la demanda sube a unos 945 TWh en 2030. La IA es señalada como el principal vector incremental.
El cuello de botella puede estar fuera del data center: las GPUs pueden entregarse en meses; las líneas de transmisión, subestaciones y conexiones de gran porte pueden tardar años. Por eso, la disponibilidad de potencia y el plazo de energización entran temprano en el estudio de viabilidad.
Un data center normalmente recibe electricidad de una red que combina varias fuentes. La empresa puede contratar PPAs, certificados o contratos de largo plazo, pero el electrón físico que llega al sitio sigue el mix del sistema eléctrico local. Por eso, "origen contractual" y "mix físico" son conceptos diferentes.
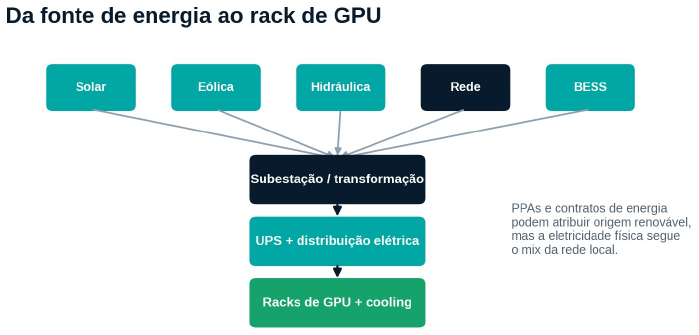
Fuentes y mecanismos que aparecen en los nuevos proyectos
- Solar y eólica: construcción relativamente rápida y costos competitivos en muchas regiones.
- Hidráulica: fuente firme o flexible según el sistema y la hidrología.
- BESS: las baterías ayudan en flexibilidad, picos e integración de renovables; no sustituyen por sí solas la generación de larga duración.
- Gas, nuclear y geotermia: fuentes despachables o firmes relevantes en determinados mercados.
- Red + PPAs: el modelo más común combina una conexión robusta a la red con contratos de energía y redundancia local.
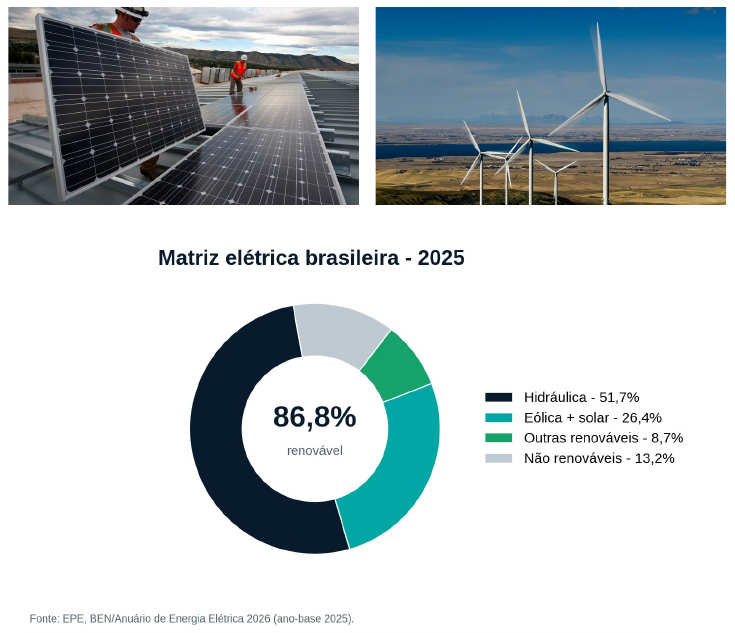
Según la EPE, las fuentes renovables respondieron por el 86,8% de la oferta interna de energía eléctrica en 2025. La hidráulica respondió por el 51,7%; la eólica y la solar, juntas, por el 26,4%. Esta característica puede contribuir a la atractividad de Brasil en infraestructura digital intensiva en energía.
Estado global de los data centers: hyperscale, colocation, enterprise
Según Synergy Research Group, el número de grandes data centers operados por empresas hyperscale llegó a 1.360 a finales de 2025. Representaban el 48% de la capacidad mundial. La proyección de la empresa es que la participación llegue al 67% en 2031, mientras la capacidad total del mercado sigue creciendo.
| Modelo | Rol típico | Tendencia con IA |
|---|---|---|
| Enterprise on-premise | Sistemas internos y legado | Puede recibir GPU local, pero pierde participación agregada |
| Colocation | Infraestructura compartida profesional | Crece en MW y alberga entornos privados/híbridos |
| Hyperscale | Cloud y plataformas globales | Principal vector de expansión de capacidad |
| Neocloud / GPU cloud | Compute acelerado a demanda | Crece con workloads de entrenamiento e inferencia |
| AI Factory dedicada | Clústeres masivos y alta densidad | Proyecto orientado a energía, fabric y liquid cooling |
Conectividad global: DCI, DWDM, fibra y cables submarinos
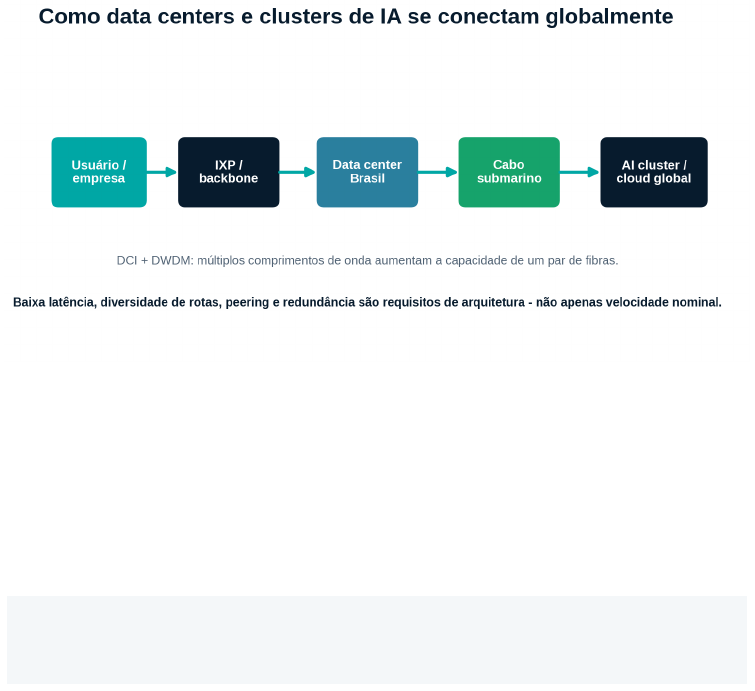
Los entrenamientos distribuidos intercambian grandes volúmenes de datos entre aceleradores. Los sistemas de storage también necesitan alimentar las GPUs continuamente. Fuera del clúster, el DCI conecta data centers metropolitanos y regionales, mientras que las redes de larga distancia y los cables submarinos conectan continentes.
La capacidad no es la única métrica: para IA distribuida, observe latencia, jitter, pérdida, oversubscription, ruta física, redundancia, MTU, RDMA, telemetría y comportamiento durante fallas.
DCI — Data Center Interconnect
El DCI conecta instalaciones diferentes con enlaces ópticos dedicados o servicios de alta capacidad. En arquitecturas distribuidas, dos unidades pueden operar como partes de un mismo entorno lógico, respetando límites de distancia y latencia.
DWDM — varias "bandas" en la misma fibra
Dense Wavelength Division Multiplexing transporta varias longitudes de onda en un par de fibras. Cada lambda puede transportar cientos de gigabits por segundo, permitiendo escalar la capacidad sin instalar un nuevo cable para cada crecimiento.
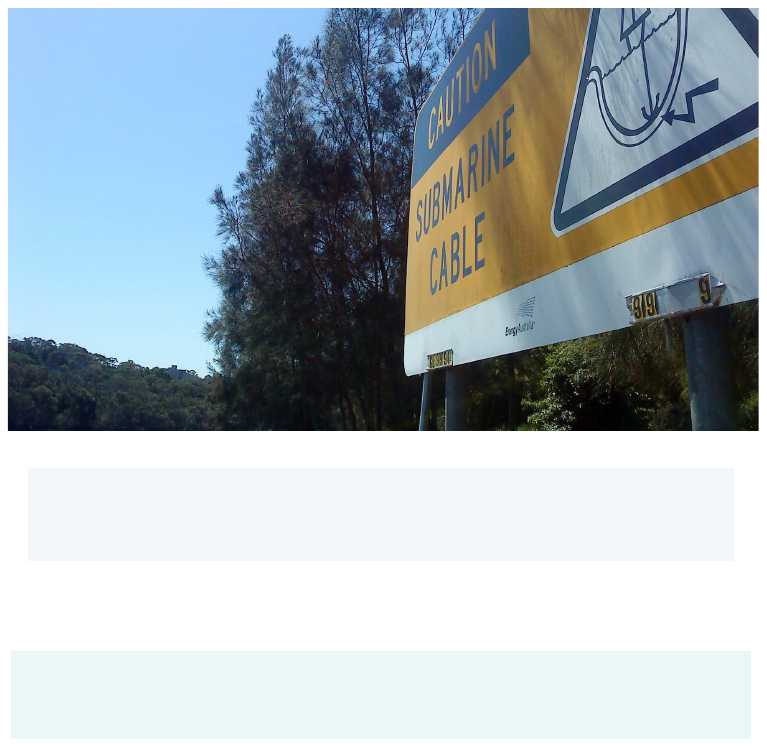
La ITU describe los cables submarinos como la columna vertebral oculta de la conectividad global. Transportan cloud, transacciones financieras, contenido y tráfico entre regiones. La resiliencia depende de la diversidad de rutas, las landing stations, la capacidad de reparación y la planificación frente a fallas físicas.
La IA aumenta la importancia de la red: modelos, datasets y usuarios están distribuidos. La capacidad computacional puede estar en otro país; sin conectividad internacional robusta, la experiencia y la resiliencia se degradan.
Brasil en la nueva geografía digital
Brasil combina un mercado consumidor relevante, una amplia infraestructura de telecomunicaciones y una matriz eléctrica con fuerte componente renovable. São Paulo concentra gran parte de la demanda y de la interconexión corporativa; Fortaleza ocupa una posición estratégica en rutas submarinas del Atlántico. La oportunidad, sin embargo, exige proyectos con capacidad eléctrica real, conectividad redundante y licenciamiento previsible.
La ventaja competitiva solo existe cuando es entregable: tener recurso renovable en el país no significa que un terreno específico disponga de potencia. El estudio debe llegar al nivel de subestación, cola de conexión, ruta de fibra y capacidad de expansión.
La capacidad de compute se convierte en un activo económico y estratégico. Puertos, energía, telecomunicaciones y logística siempre fueron infraestructuras decisivas para la competitividad. La IA añade una nueva capa: capacidad computacional acelerada. El país o la empresa que controla el acceso a chips, energía, datos, modelos y conectividad posee mayor libertad para innovar y operar sistemas críticos.
Cinco vectores de la nueva carrera
- Semiconductores: acceso a GPUs, HBM, packaging avanzado y capacidad fabril.
- Energía: disponibilidad de megavatios, precio y plazo de conexión.
- Data centers: densidad, liquid cooling, seguridad y operación.
- Modelos y datos: propiedad intelectual, soberanía y gobernanza.
- Redes: fibra, DCI, landing stations, IXPs y rutas internacionales diversas.
Soberanía digital en la práctica: no significa necesariamente hacer todo en casa. Significa evitar dependencias no gestionadas, tener alternativas arquitectónicas y saber dónde están los datos, el compute, las claves, los modelos y las rutas.
Lo que viene después: AI Factories, soberanía computacional y agentes autónomos
La hoja de ruta une negocio, datos, seguridad e infraestructura.
| Etapa | Pregunta clave | Entregable |
|---|---|---|
| 1. Caso de uso | ¿Qué problema y qué KPI? | Business case y criterio de éxito |
| 2. Datos | ¿Dónde están, quién puede acceder? | Mapa de datos y política de uso |
| 3. Modelo | ¿Cloud, API, open model o privado? | Arquitectura de IA |
| 4. Integración | ¿Qué sistemas y herramientas? | APIs, RAG, agentes y workflow |
| 5. Riesgo | ¿Qué puede automatizarse? | Guardrails, aprobación y auditoría |
| 6. Infra | ¿GPU, storage, red, energía y cooling? | Sizing y diseño técnico |
| 7. Operación | ¿Cómo observar costo, calidad y fallas? | SLOs, FinOps y AIOps |
Decisión buy vs. build: la mayoría de las empresas combina modelos vía API/cloud con datos y controles propios. Workloads sensibles, previsibles o intensivos pueden justificar infraestructura privada, colocation o GPU cloud dedicada. La respuesta depende del costo total, la latencia, la soberanía y la utilización.
En 1956, la inteligencia artificial era una ambición científica. Hoy, conversa, crea, analiza y ejecuta. El próximo salto no depende solo de mejores modelos: depende de capacidad computacional suficiente para atender a usuarios y empresas con costo, confiabilidad y sostenibilidad.
Por eso, comprender la IA exige mirar más allá del algoritmo. Las GPUs necesitan memoria. Las GPUs a escala necesitan fabrics de baja latencia. Los fabrics necesitan storage. Todo necesita energía. La energía se convierte en calor. El calor debe ser removido. Y el resultado debe atravesar redes nacionales y globales.
La tesis central de esta guía: la inteligencia artificial se está convirtiendo en infraestructura económica global. Quien planifique compute, energía, cooling y conectividad como un sistema integrado estará mejor preparado para la próxima década.
Fuentes
- Dartmouth AI, Artificial Intelligence — Our Story.
- Weizenbaum, J., ELIZA — A Computer Program for the Study of Natural Language Communication, Communications of the ACM, 1966.
- Vaswani et al., Attention Is All You Need, NeurIPS, 2017.
- UNCTAD, Technology and Innovation Report 2025: Inclusive AI for Development.
- IEA, Energy and AI (2025).
- EPE, Balanço Energético Nacional 2026 — año base 2025.
- LNCC, Configuração do Supercomputador Santos Dumont.
- Eviden/Bull, Santos Dumont, LNCC supercomputer, receives fourfold upgrade.
- Synergy Research Group, Hyperscale Operators to Account for 67% of all Data Center Capacity by 2031.
- ITU, Global Connectivity Report 2025 y Submarine Cable Resilience.
Nota sobre proyecciones: los números futuros de mercado, consumo de energía y participación de capacidad son escenarios o proyecciones de las fuentes indicadas. Pueden cambiar con la eficiencia, la demanda, la regulación, la cadena de suministro y la disponibilidad de energía.