
Un servidor Bare Metal es un servidor físico dedicado íntegramente a un único cliente o entorno, sin compartición obligatoria de hardware con otros tenants. CPU, memoria, controladoras, discos e interfaces de red quedan bajo dominio exclusivo del contratante — el sistema operativo o hipervisor se instala directamente en el equipo, preservando previsibilidad, aislamiento y libertad de configuración.
Sobre este material: contenido consolidado a partir de referencias técnicas y de la experiencia de proyecto de EnQ Digital, con fecha de corte en 2026. Precios, especificaciones y disponibilidad de hardware deben confirmarse antes de la contratación.
Qué es Bare Metal
Bare Metal no significa "sin virtualización". Es la base física dedicada sobre la cual pueden ejecutarse VMs, contenedores, bases de datos o aplicaciones nativas. Sus características centrales incluyen recursos físicos dedicados y rendimiento consistente, acceso administrativo pleno al sistema operativo o al hipervisor, topología de red, seguridad y almacenamiento definidas según el workload, y ciclo de vida, parches, backup y monitoreo gobernados por responsabilidades claras.
Cuándo tiene sentido
La decisión debe considerar el perfil de carga, la soberanía operativa, el licenciamiento, la latencia y la previsibilidad financiera. Los casos de uso prioritarios incluyen bases de datos transaccionales y analíticas con I/O intenso, ERP, CRM, billing y plataformas críticas 24x7, clústeres de virtualización privada y Kubernetes, IA, GPU, renderizado, HPC y procesamiento científico, VDI, juegos, streaming y aplicaciones sensibles al jitter, y entornos regulados o con requisitos fuertes de aislamiento.
Uso sostenido de CPU/RAM, necesidad de hardware específico, costo elevado de licencias por core, tráfico voluminoso, dependencia de baja latencia o necesidad de control profundo son señales favorables al Bare Metal. Por otro lado, cargas impredecibles y muy elásticas, prototipos cortos o servicios totalmente gestionados suelen aprovechar mejor la nube pública o PaaS.
Arquitectura física
El resultado depende del conjunto: servidor, rack, energía, refrigeración, red, seguridad y operación.
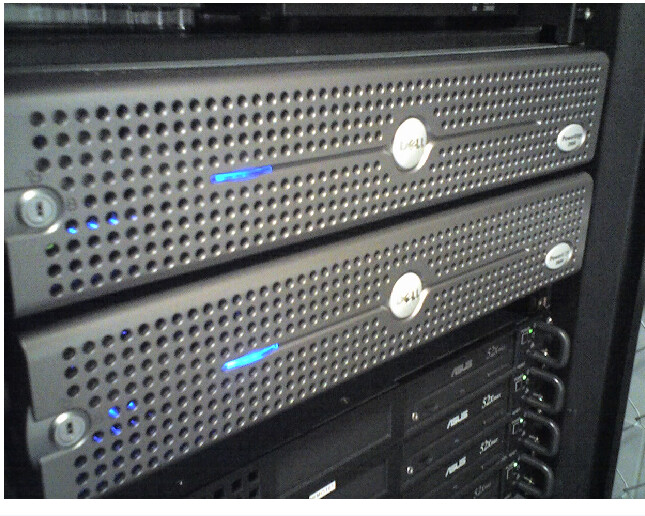
Una solución típica se organiza en capas: compute (servidores 1U/2U, CPU, RAM, GPU) para ejecutar workloads; storage (NVMe/SAS/SATA, SAN/NAS/objeto) para persistencia y rendimiento; red (switches ToR, routers, enlaces) para conectividad redundante; seguridad (firewalls en HA, WAF, IDS/IPS) para segmentación y protección; y facility (rack, energía A/B, climatización) para disponibilidad física.
Los principios de diseño incluyen eliminar puntos únicos de falla cuando el RTO lo exija, separar redes de gestión, producción, storage, backup y clúster, documentar puertos, VLANs, IPs, dependencias y matriz de flujo, y reservar capacidad eléctrica, térmica y física para el crecimiento.
Hardware del servidor en profundidad
El servidor corporativo es un sistema integrado: chasis, placa principal, procesadores, memoria, buses, controladoras, discos, red, fuentes, ventilación y gestión fuera de banda.
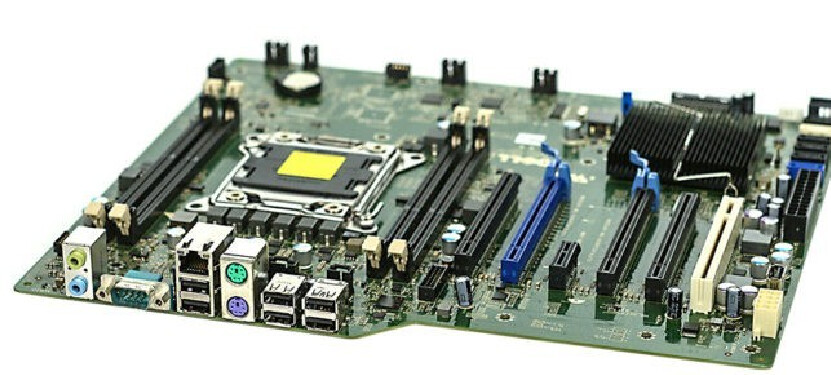
Entre los componentes y criterios a evaluar están el chasis 1U/2U/4U (bahías, airflow, GPU y expansión — impacta densidad y refrigeración), la CPU (sockets, cores, clock, caché, TDP, PCIe — impacta rendimiento y licencia), la RAM ECC (capacidad, canales, DIMMs, frecuencia — impacta confiabilidad y NUMA), el PCIe (generación, lanes y ranuras físicas — impacta NIC, HBA, NVMe y GPU), el BMC (acceso remoto, consola, medios virtuales — operación fuera de banda) y las fuentes/ventiladores (redundancia, potencia y hot-swap — continuidad y mantenimiento).
Los servidores 1U maximizan densidad, pero tienen menos espacio para discos, placas y flujo de aire. Los modelos 2U ofrecen mejor expansión y pueden acomodar más GPUs o unidades NVMe — la elección debe respetar peso, profundidad del rack, potencia por toma y disipación térmica. La generación del procesador determina la memoria soportada, canales, capacidad, PCIe y recursos de seguridad: es necesario verificar la distribución de lanes entre sockets, la bifurcación PCIe, el ancho eléctrico de las ranuras y la contención entre NICs, HBAs, NVMe y aceleradores.
Procesamiento, memoria y NUMA
La elección de CPU y RAM debe seguir el comportamiento real de la aplicación, no solo el conteo nominal. Los núcleos favorecen el paralelismo; la frecuencia y el IPC favorecen los hilos sensibles a la latencia. NUMA, caché, instrucciones vectoriales y aceleración criptográfica pueden alterar significativamente el resultado. Para la memoria, es necesario dimensionar capacidad, canales ocupados, frecuencia, ECC y margen de crecimiento — bancos in-memory y virtualización requieren atención especial a NUMA y reserva para el host.
En las decisiones de plataforma: un único socket puede reducir costos de licencia, mientras que dos amplían cores, RAM y PCIe; los DIMMs deben distribuirse simétricamente entre canales y sockets; vCPU, memoria y dispositivo deben permanecer próximos en el NUMA cuando sea posible; el TDP debe validarse contra refrigeración, potencia y frecuencia sostenida; y BIOS, BMC, NIC, HBA y controladora deben homologarse como un conjunto único de firmware.
Como buenas prácticas: prefiera benchmarks representativos del workload, controle el overcommit y la afinidad cuando la previsibilidad sea crítica, monitoree CPU ready, steal, page faults, swapping y ancho de banda de memoria, y valide la compatibilidad de BIOS, firmware y sistema operativo.
Subsistemas, expansión y aceleradores
El rendimiento final está limitado por el eslabón más restrictivo entre CPU, RAM, PCIe, storage y red. Nunca dimensione un servidor solo por la CPU: confirme el camino completo de los datos, desde el disco o la red hasta la memoria y el procesador/acelerador.
En el storage interno, considere la controladora RAID (hardware o software según el sistema), el backplane SAS/SATA/NVMe compatible con la cantidad y velocidad de las unidades, la caché protegida con política de write-back coherente con el riesgo, y recursos de hot-swap, indicadores, repuestos y telemetría para un mantenimiento seguro.
En red e I/O, evalúe NICs de 10/25/40/100/200 GbE según tráfico y protocolo, offloads, RSS, RDMA/RoCE y SR-IOV cuando el workload lo exija, HBAs Fibre Channel o SAS con drivers y firmware homologados, y transceptores, DAC/AOC, fibra y switches compatibles de punta a punta. Para GPU y aceleradores — IA, renderizado y HPC — es necesario evaluar cantidad y tipo de GPU, memoria HBM/VRAM, interconexión entre aceleradores, lanes PCIe, potencia, refrigeración por aire o líquida y compatibilidad del stack de software.
Ciclo de vida del hardware
La confiabilidad depende de la estandarización, la compatibilidad, las piezas y la disciplina de firmware. La gobernanza incluye definir una línea base homologada de BIOS, BMC, NIC, HBA, RAID y drives, actualizar por oleadas con prueba, ventana, backup y rollback, monitorear alertas predictivas, desgaste de SSD, ECC, temperatura y fuentes, mantener piezas críticas y soporte del fabricante con procedimientos de reemplazo definidos, y registrar número de serie, garantía, configuración e historial en la CMDB.
En la seguridad de la plataforma, habilite Secure Boot, TPM, contraseñas fuertes en el BMC, red de gestión aislada, certificados, logs y actualización de firmware — desactive protocolos legados y puertos no utilizados. Para el fin de vida, planifique la renovación antes del fin del soporte: migración, saneamiento criptográfico o físico de los medios, descarte certificado y actualización del inventario deben formar parte del proyecto.
Automatización con Ansible
Ansible estandariza la configuración, reduce tareas manuales y crea una trazabilidad repetible para el ciclo operativo del Bare Metal. Se aplica al provisionamiento posinstalación, hardening, usuarios, paquetes, agentes, servicios, configuración de red, backup, observabilidad, patching, compliance y recolección de evidencias — las colecciones de fabricantes también pueden automatizar BMC, BIOS, RAID y firmware, según el soporte disponible.
La estructura recomendada incluye inventario dinámico por entorno, función, ubicación y criticidad; roles reutilizables con variables protegidas por vault/secrets manager; playbooks idempotentes, que pueden ejecutarse nuevamente sin producir cambios indebidos; check mode, lint, pruebas y aprobación antes de producción; serialización y límites de fallo para preservar quórum y disponibilidad; y logs de ejecución integrados al pipeline y a la gestión de cambios.
Un flujo típico pasa por descubrimiento (validar BMC, interfaces, discos y versión), bootstrap (crear acceso seguro y repositorios), baseline (hardening, NTP, DNS, certificados y syslog), agentes (monitoreo, backup, EDR e inventario), patch (canario → lote → validación → siguiente lote) y evidencia (informe de cambio y conformidad). Para clústeres, use ejecución en lotes y health checks: retirar un nodo, actualizar, validar, reintegrar y solo entonces avanzar.
Terraform y OpenTofu
Terraform y OpenTofu describen infraestructura como código; Ansible complementa configurando el sistema y las aplicaciones. Cuando el proveedor, el fabricante o la plataforma expone API/provider, la IaC puede solicitar servidores, VLANs, direcciones, reglas, DNS, IPAM, volúmenes, credenciales e integraciones. En entornos sin provider, los módulos pueden orquestar APIs, pipelines o plataformas de provisionamiento.
Terraform es un producto de HashiCorp en lenguaje HCL; OpenTofu es un proyecto open source bajo la Linux Foundation, compatible con HCL/ecosistema — la elección entre uno y otro pasa por política, soporte y providers de un lado, y gobernanza abierta y compatibilidad del otro.
Como buenas prácticas: mantenga el state remoto con cifrado, lock, versionado y acceso mínimo; separe estados por entorno y dominio de falla; fije versiones de providers y revise el archivo de lock; exija plan en pull request, con apply bajo aprobación e identidad de servicio; nunca coloque secretos en código, variables abiertas u outputs; y mantenga detección de drift, importación controlada y política como código. El pipeline integrado típico sigue: commit → validación/lint → terraform/tofu plan → aprobación → apply → inventario dinámico → Ansible → pruebas → CMDB/monitoreo. El state representa recursos; no sustituye la documentación, el backup ni el inventario corporativo.
Almacenamiento e I/O
La capacidad en TB es solo una parte de la ecuación: IOPS, latencia, throughput, durabilidad y recuperación definen la experiencia real. Entre los perfiles de storage están el NVMe local (punto fuerte en latencia e IOPS, usado en bases de datos, caché y analytics), SAS/SATA local (costo/capacidad, usado en archivos y backup local), SAN/iSCSI/FC (compartición y HA, usado en clústeres y virtualización), NFS (simplicidad y compartición, usado en contenido y repositorios) y S3/objeto (escala y API, usado en backup, data lake y medios).
El RAID reduce el impacto de la falla de disco, pero no sustituye el backup — es necesario considerar la controladora, la caché protegida, el hot spare, el rebuild y el riesgo de falla correlacionada. La regla práctica es 3-2-1: al menos 3 copias de los datos, en 2 medios o dominios distintos, con 1 copia fuera del entorno primario. Para protección contra ransomware, agregue inmutabilidad y pruebas reales de restauración.
Red y conectividad
La red debe entregar ancho de banda, latencia, redundancia y seguridad compatibles con la aplicación.
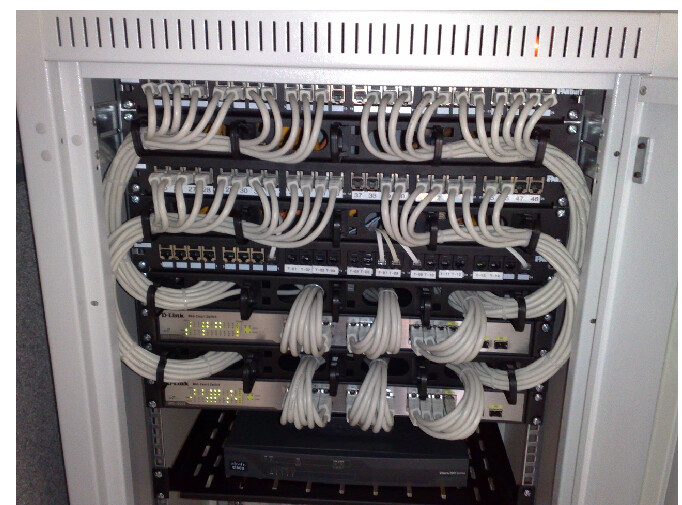
El diseño recomendado incluye dos interfaces por plano crítico, distribuidas entre switches distintos; bonding/LACP cuando sea compatible, con rutas y gateways redundantes; VLANs/VRFs para separar gestión, producción, storage, backup y replicación; conectividad dedicada, Internet, IP transit, peering o cross-connect según el caso; y QoS y MTU consistentes de punta a punta, sobre todo para storage.
La capacidad debe dimensionarse por la demanda pico, la replicación, el backup y el crecimiento, midiendo throughput útil, paquetes por segundo, latencia, jitter, pérdida y ocupación de los uplinks. La protección contra DDoS debe combinar capacidad upstream, detección, mitigación y runbook de activación — el firewall local por sí solo no absorbe ataques volumétricos.
Topología de red en 3 capas
El modelo clásico separa las funciones de Core, Distribución y Acceso, facilitando el crecimiento, las políticas y el aislamiento de fallas.
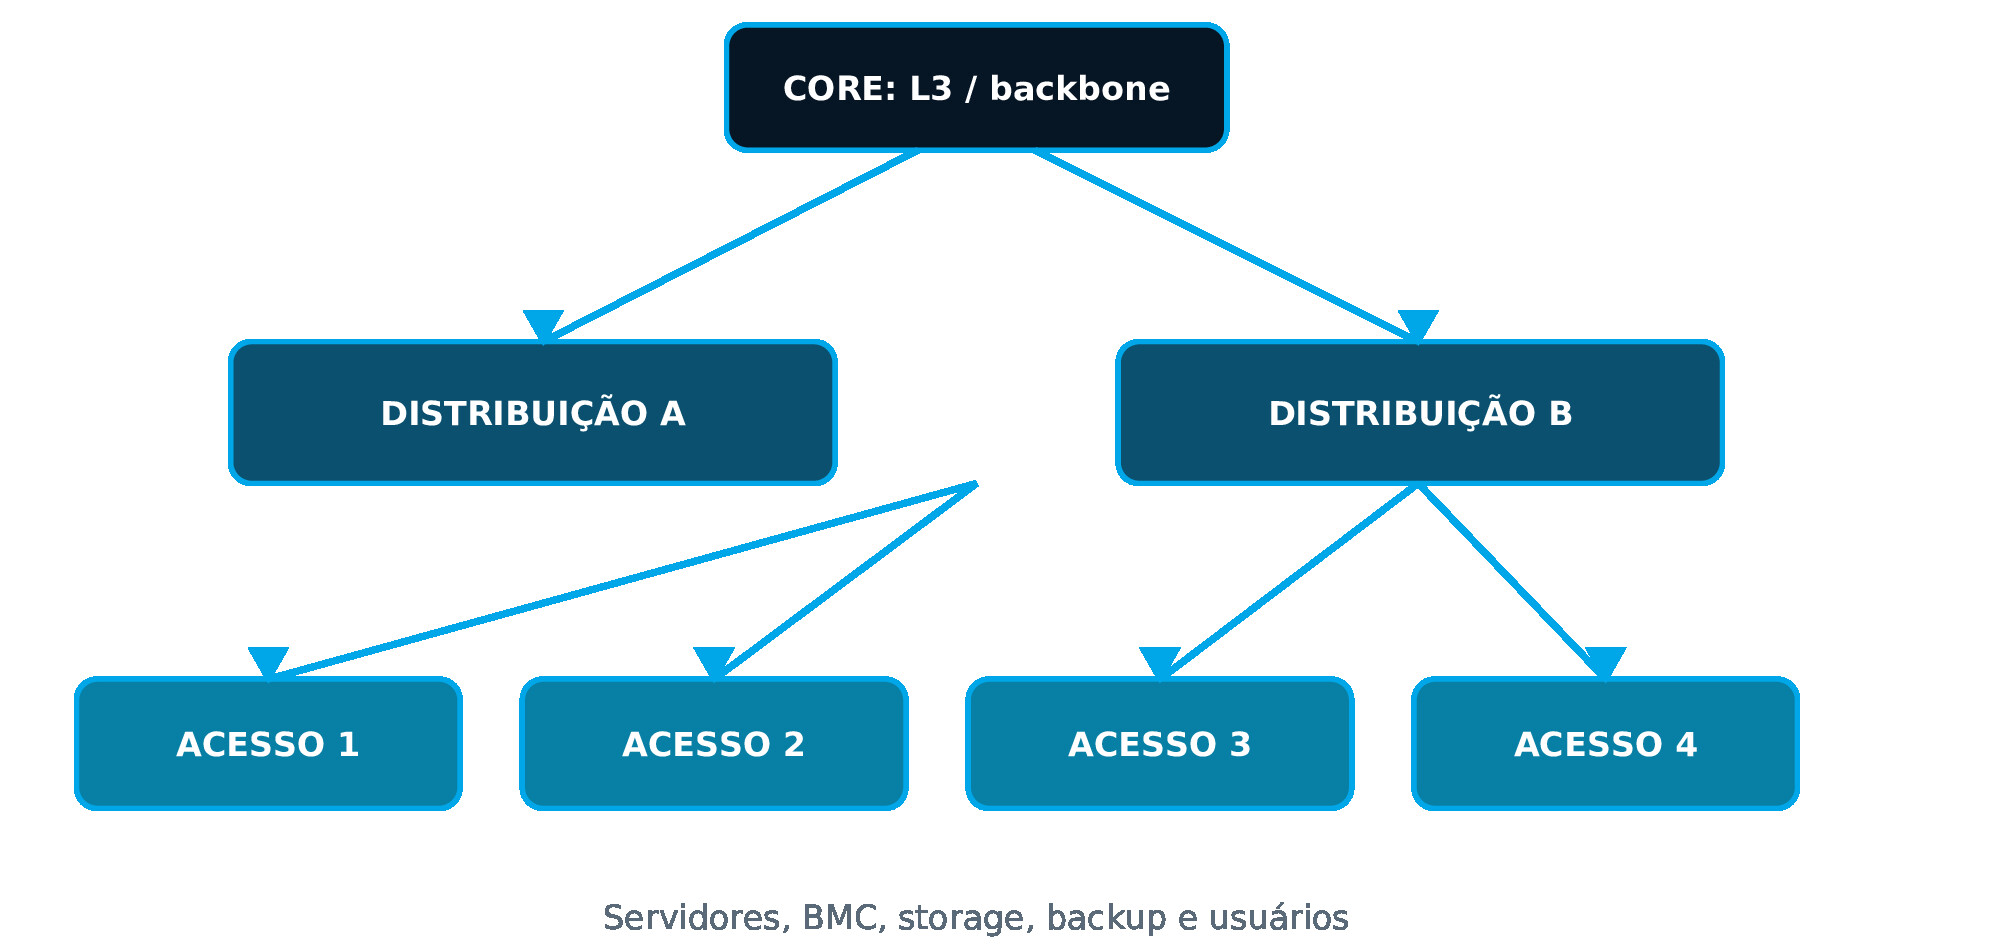
Cada capa tiene una responsabilidad clara: el Core es el backbone de alta velocidad y baja latencia (enrutamiento L3, ECMP, unión entre bloques); la Distribución se encarga de la política, agregación y frontera de falla (VRF, ACL, gateways, sumarización); y el Acceso realiza la conexión directa de los equipos (hosts, BMC, storage, backup).
Un diseño básico redundante prevé un par de equipos en el Core y en la Distribución cuando el SLA lo exija, acceso dual-homed para servidores críticos con NICs y caminos distintos, VLANs o VRFs separadas para producción, gestión, storage, backup y clúster, LACP/MLAG o enrutamiento L3 según soporte, escala y operación, y Spanning Tree solo con raíz y dominios controlados, evitando grandes dominios L2. En data centers de mayor escala, la topología leaf-spine reemplaza frecuentemente al modelo jerárquico clásico; para entornos pequeños y medianos, Core y Distribución pueden colapsarse en un par de switches, manteniendo la separación lógica.
Aplicación en 3 capas
La arquitectura Web–Aplicación–Datos separa exposición, lógica de negocio y persistencia, permitiendo controles y escalabilidad específicos para cada capa.
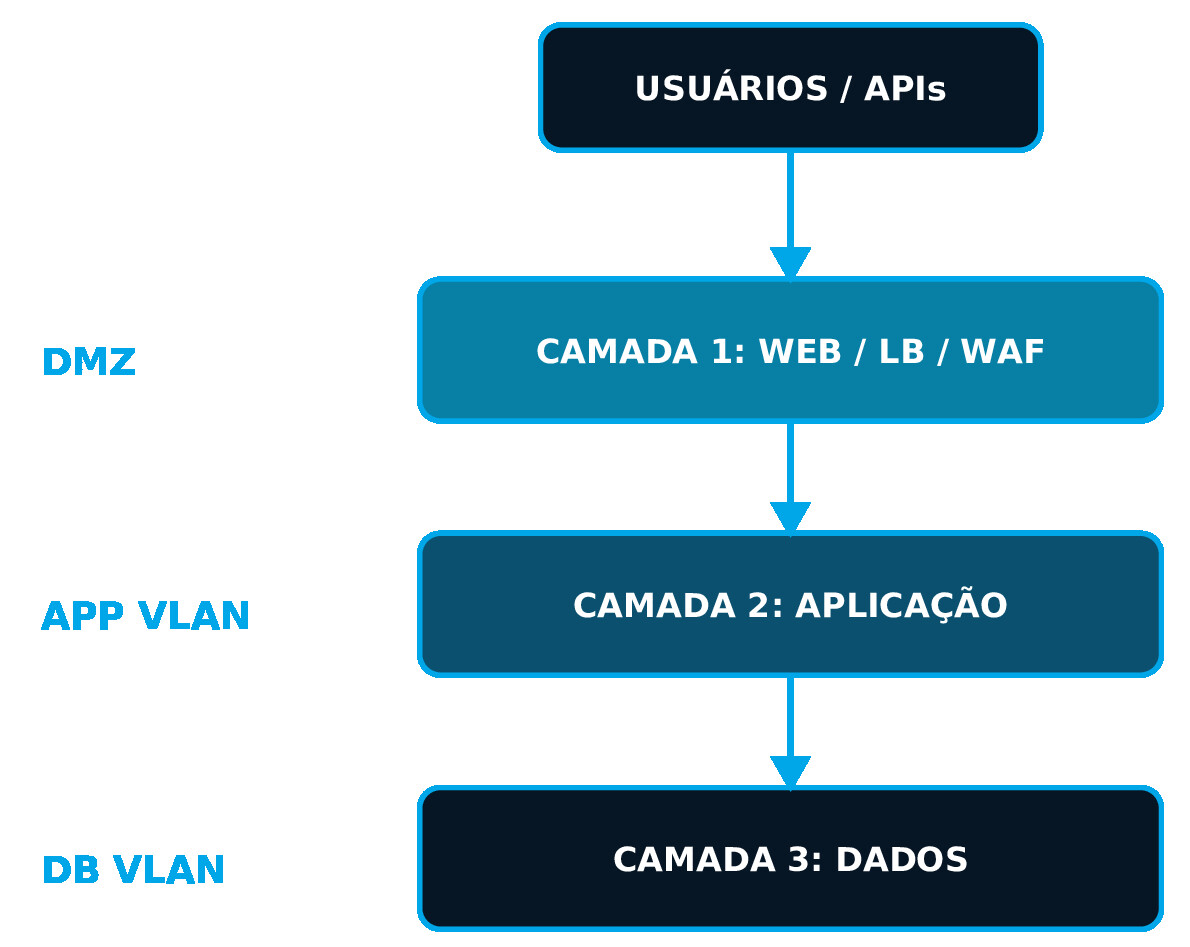
La capa 1 (Web) reúne WAF, balanceador de carga, proxy y front-end, y recibe el tráfico externo sin acceso directo a la base de datos. La capa 2 (Aplicación) reúne APIs, servicios, colas y workers, ejecutando la lógica de negocio y accediendo solo a puertos específicos de datos. La capa 3 (Datos) reúne base de datos, caché, storage y backup, con red restringida y administración segregada.
Un ejemplo de referencia Bare Metal EnQ combina dos firewalls en clúster en el borde, dos balanceadores o un servicio virtual redundante en la capa Web, dos o más servidores de aplicación (permitiendo mantenimiento por nodo), un clúster de base de datos o réplica con storage y backup protegidos, y una red de gestión fuera de banda con observabilidad transversal. El principio de seguridad central: Internet nunca accede directamente a la aplicación o a la base de datos — cada capa permite solo los flujos explícitamente necesarios.
Seguridad y firewall en clúster
La defensa en profundidad combina controles físicos, de red, de identidad, de host, de aplicación y de datos. Un par de firewalls activo-pasivo o activo-activo reduce la indisponibilidad por falla y mantenimiento — el diseño debe contemplar sincronismo de sesión/estado, heartbeat dedicado, enlaces WAN/LAN redundantes y pruebas controladas de failover.
Los controles esenciales incluyen privilegio mínimo, MFA y cuentas administrativas segregadas; bastion host o VPN para la gestión, sin exponer nunca las interfaces administrativas directamente; microsegmentación, deny-by-default y revisión periódica de las reglas; EDR, hardening, gestión de vulnerabilidades y parches; cifrado en tránsito y, según el riesgo, también en reposo; y logs centralizados en SIEM, con retención y trazabilidad de auditoría. La alta disponibilidad sin prueba es solo una hipótesis — es necesario ejercitar el failover, la restauración y la respuesta a incidentes en un calendario definido.
Alta disponibilidad y continuidad
La disponibilidad nace del diseño y de la operación, no de un único equipo robusto. Cinco conceptos organizan la conversación: SLA (¿qué disponibilidad asume el servicio?), RTO (¿cuánto tiempo puede estar indisponible?), RPO (¿cuánto dato puede perderse?), HA (¿cómo mantener el servicio ante fallas locales?) y DR (¿cómo recuperar en otro dominio/ubicación?).
Los dominios de falla a considerar incluyen fuentes y PDUs A/B, switches y firewalls redundantes, clúster de hosts cuando la aplicación no es nativamente distribuida, replicación y backup en dominio separado, y un sitio secundario cuando el impacto justifica la inversión.
Atención: HA no sustituye a DR; la replicación no sustituye al backup; y el SLA de infraestructura no equivale automáticamente al SLA de la aplicación.
Operación y observabilidad
El servidor dedicado necesita una rutina industrial: inventario, monitoreo, cambio, incidente, capacidad y seguridad.
La telemetría mínima cubre la salud del hardware vía BMC/IPMI/iLO/iDRAC; CPU, RAM, sistema de archivos, discos, RAID y temperatura; interfaces, errores, drops, latencia y utilización de red; servicios, transacciones, colas, base de datos y experiencia del usuario; y eventos de seguridad, autenticación y cambios administrativos. En la gestión, es necesario definir responsables de hardware, sistema operativo, middleware, aplicación, backup, firewall y conectividad, manteniendo CMDB, runbooks, ventanas de cambio y escalamiento. Monitorear el recurso no basta: es necesario correlacionar la infraestructura con indicadores del servicio y del negocio.
Virtualización, contenedores y Kubernetes
Bare Metal es una plataforma flexible para consolidación o ejecución directa. En el modelo de ejecución directa en el sistema operativo, la ganancia es menor overhead y más control, con la contrapartida de menor flexibilidad de consolidación. Con hipervisor, se gana aislamiento, HA y snapshots, pero es necesario considerar la licencia y la operación del clúster. Los contenedores traen portabilidad y densidad, exigiendo atención a la persistencia y la seguridad. Kubernetes trae orquestación y escala, al costo de mayor complejidad operativa.
Hipervisores como VMware, Hyper-V, Proxmox VE, KVM y otros pueden instalarse según la compatibilidad, el licenciamiento y el modelo de soporte. Ejecutar Kubernetes sobre Bare Metal evita una capa adicional de virtualización, pero exige un diseño propio de load balancer, CNI, CSI, ingress, observabilidad, actualizaciones y recuperación del control plane.
Rendimiento y dimensionamiento
El dimensionamiento confiable parte de métricas reales e incluye margen, picos, fallas y crecimiento. El proceso recomendado es recolectar percentiles de CPU, RAM, IOPS, latencia, throughput y red; clasificar picos, estacionalidad y ventana de backup; modelar el crecimiento de 12 a 36 meses; aplicar margen operativo y escenario N+1; y ejecutar una prueba de concepto con dataset y concurrencia representativos.
Un ejemplo ilustrativo: una demanda medida de 24 cores al 70% en el pico sugiere un proyecto inicial de 32 a 48 cores físicos; 220 GB de RAM en el pico sugieren 384 GB ECC; 8 TB útiles con 120 mil IOPS sugieren NVMe con protección y margen; y 3,5 Gb/s de pico sugieren 2×10/25 GbE. Los valores son didácticos — compresión, RAID, hyperthreading, NUMA, replicación y protocolo influyen en el rendimiento final.
Bare Metal vs. nube vs. colocation
No existe un ganador universal; existe una mejor adherencia al workload y al modelo operativo. En hardware, el Bare Metal gestionado es dedicado, la nube pública es compartida/dedicada y la colocation usa hardware del propio cliente. En elasticidad, la nube pública lidera (alta), seguida del Bare Metal (media) y de la colocation (baja/media). En control, la colocation ofrece el máximo, el Bare Metal es alto y la nube es variable. En inversión inicial, Bare Metal y nube tienden a ser bajo/medio y bajo respectivamente, mientras que la colocation exige una inversión alta. La operación física queda a cargo del proveedor en el Bare Metal y en la nube, y del cliente (vía contrato) en la colocation. En previsibilidad, Bare Metal y colocation tienden a ser altos, mientras que la nube es variable.
Una estrategia híbrida común mantiene datos y cargas estables en Bare Metal, usando la nube para servicios gestionados, burst, distribución global o disaster recovery.
Costos y TCO
La comparación de costo total debe usar un horizonte común, con premisas transparentes. Los componentes del TCO incluyen mensualidad o amortización de servidor, rack y facility; licencias por core, socket, host, VM o capacidad; enlaces, IPs, cross-connects y transferencia de datos; backup, seguridad, monitoreo y soporte; equipo, guardia, cambio, migración y desactivación; y el costo de indisponibilidad y riesgo.
Un modelo simple: TCO = infraestructura + software + conectividad + operación + migración + riesgo residual. Compare los horizontes de 24, 36 y 60 meses, y haga un análisis de sensibilidad para crecimiento y cambio de divisa. Un precio unitario menor puede resultar en un TCO mayor si el diseño eleva licencias, indisponibilidad o esfuerzo operativo.
Migración e implementación
Una transición segura reduce el riesgo con descubrimiento, piloto, oleadas y rollback. Las etapas típicas son: inventario de aplicaciones, dependencias, datos, licencias y requisitos; diseño HLD/LLD, direccionamiento, reglas y responsabilidades; provisionamiento, hardening, monitoreo y backup; prueba funcional, de carga, failover, restauración y seguridad; migración piloto y por oleadas de criticidad; cutover con criterios de go/no-go y plan de retorno; e hypercare, aceptación, documentación y optimización.
Entre los métodos posibles están rehost, rebuild, replicación continua, backup/restore y migración de VM — la elección depende del downtime tolerable, de la compatibilidad y del volumen de datos. Antes del corte, valide sincronismo, capacidad, DNS, certificados, firewall, backup, observabilidad, comunicación y autoridad para rollback.
Bare Metal EnQ Digital
EnQ Digital estructura entornos Bare Metal a medida, combinando servidores dedicados, conectividad, seguridad, almacenamiento y servicios de implementación y operación — el alcance final se define según criticidad, ubicación, capacidad y responsabilidad deseada.
Las posibilidades de solución incluyen servidores dedicados para aplicaciones, bases de datos, virtualización, contenedores e IA; redes segmentadas, conectividad dedicada e Internet; firewalls en clúster y políticas de acceso según el proyecto; storage local o compartido, backup y replicación; automatización con Ansible e infraestructura como código con Terraform/OpenTofu, según el alcance y las APIs disponibles; monitoreo, soporte y gestión según el SLA contratado; y arquitecturas single-site, N+1, clúster o recuperación en sitio alternativo. El diferencial consultivo: el proyecto nace del workload — capacidad, RTO/RPO, seguridad, licenciamiento y crecimiento se traducen en una arquitectura técnica y comercial coherente.
Arquitecturas de referencia
Tres patrones conceptuales deben ajustarse al riesgo y a la aplicación real. El patrón "dedicado esencial" combina 1 servidor, backup externo y firewall — indicado para workload no crítico o con HA ya resuelta en la propia aplicación. El patrón "clúster local" combina 2 a 3 hosts, storage/replicación y firewall en HA — indicado para virtualización y servicios críticos. El patrón "dos sitios" combina clústeres, replicación y backup inmutable — indicado cuando el RTO/RPO son exigentes y la continuidad es prioridad.
El flujo lógico típico sigue: usuarios/Internet → protección DDoS → routers redundantes → firewalls en clúster → switches redundantes → servidores/clúster → storage y backup, con la gestión utilizando un plano segregado y acceso seguro. La arquitectura debe nacer del impacto de la falla — duplicar todo sin mapear dependencias puede mantener puntos únicos invisibles y elevar costos sin entregar el SLA esperado.
Checklist de contratación
Use estas preguntas para comparar propuestas con el mismo nivel de exigencia. En el campo técnico: ¿qué CPU, RAM, discos, RAID, NICs y posibilidad de expansión? ¿Hay fuentes, PDUs, switches, enlaces y firewalls redundantes? ¿Qué ancho de banda, franquicia, protección DDoS, IPs y latencia esperada? ¿Cómo se realizan el backup, la retención, la inmutabilidad y la restauración? ¿Qué versiones de firmware, SO e hipervisor son soportadas?
En el campo operativo y comercial: ¿qué SLA, cobertura 24x7, tiempos de respuesta y escalamiento? ¿Qué es responsabilidad del cliente y del proveedor? ¿Hay inventario, monitoreo, informes y gestión de cambios? ¿Cuáles son los costos de instalación, licencia, tráfico, expansión y salida? ¿Cómo ocurre la devolución o destrucción segura de los datos? Adjunte al contrato la arquitectura, la matriz de responsabilidades, los SLAs y los criterios de aceptación.
Conclusión
Bare Metal entrega aislamiento, control y rendimiento previsible. El valor aparece cuando hardware, red, seguridad, datos, continuidad y operación se tratan como un único sistema — no como componentes aislados elegidos y operados por separado.
El próximo paso natural es mapear el workload, la criticidad, el crecimiento y la responsabilidad operativa para diseñar el entorno Bare Metal adecuado a cada operación.
Créditos de las fotografías: servidores rack — Dsv, dominio público; placa principal de servidor — Marcin Wieclaw, CC BY-SA 4.0; switches y patch panels en rack de 19 pulgadas — Dsimic, CC BY-SA 4.0; técnico en rack en el NERSC — Derrick Coetzee, CC0 1.0. Fuentes: Wikimedia Commons. Imágenes recortadas/redimensionadas solo para diagramación.