
Proxmox Virtual Environment (PVE) es una plataforma de virtualización y contenedores basada en Debian GNU/Linux, publicada como software libre bajo licencia GNU AGPLv3. Esta guía técnica reúne, en un único material, la arquitectura de clúster, storage, red, backup, identidad, seguridad, automatización y licenciamiento del ecosistema Proxmox en su edición de septiembre de 2026 — base Proxmox VE 9.2, Proxmox Backup Server 4.2 y Proxmox Datacenter Manager 1.1.
Sobre este material: los ejemplos de desempeño citados son resultados de laboratorio publicados por la propia Proxmox, no promesas de SLA — CPU, NUMA, controladora, SSD/NVMe, firmware, red, MTU, colas, workload y política de réplica alteran radicalmente los resultados. Como los repositorios, kernels, QEMU, LXC y Ceph evolucionan continuamente, valide siempre las release notes antes de una implementación o actualización.
Proxmox en 2026: plataforma y ecosistema
Proxmox VE combina KVM para máquinas virtuales y LXC para contenedores Linux en una única interfaz, integrando clúster, alta disponibilidad, storage definido por software, red y disaster recovery.
| Componente | Versión base | Rol |
|---|---|---|
| Proxmox VE | 9.2 | Hipervisor, contenedores, clúster, HA, SDN y storage |
| Proxmox Backup Server | 4.2 | Backup incremental, deduplicación, verify, sync y restore |
| Proxmox Datacenter Manager | 1.1 | Gestión centralizada de múltiples clústeres/sites |
| Ceph | Tentacle 20.2 en PVE 9.2 | Storage distribuido integrado |
| Base de PVE 9.2 | Debian 13.5 + kernel 7.0 | Sistema operativo del host |
| QEMU / LXC / ZFS | QEMU 11 / LXC 7 / ZFS 2.4 | Virtualización, contenedores y storage local |
En agosto de 2026, Proxmox lanzó una edición Arm64 del PVE 9.2, con paridad funcional declarada en KVM, LXC, ZFS y Ceph para plataformas oficialmente soportadas como NVIDIA Grace y Vera. Los clústeres mixtos x86-64/Arm64 no deben asumirse como soportados para producción sin una validación específica.
Proxmox se posiciona en cinco frentes: virtualización enterprise (VMs Windows/Linux con KVM/QEMU, VirtIO, UEFI, vTPM y PCIe passthrough), contenedores de sistema (LXC compartiendo el kernel del host, con overhead generalmente bajo), infraestructura hiperconvergente (compute y Ceph en el mismo conjunto de nodes), infraestructura tradicional (SAN Fibre Channel, iSCSI, NFS y storage de terceros) y gestión multi-site (el Datacenter Manager como capa por encima de clústeres independientes, sin sustituir el plano de control local de cada uno).
Fundamentos: KVM, LXC y arquitectura del host
En el camino de VM, KVM ofrece virtualización asistida por hardware en el kernel Linux y QEMU implementa el modelo de máquina y los dispositivos virtuales. Los dispositivos VirtIO reducen el overhead de emulación para workloads modernos. La elección del CPU model influye en el desempeño y la migración: usar "host" maximiza la exposición de recursos de la CPU, mientras que modelos compatibles entre nodes amplían la portabilidad.
Los contenedores LXC no emulan un kernel completo: los procesos comparten el kernel del host, aislados por namespaces, cgroups, AppArmor/seccomp y límites de recursos. Esto reduce el costo de runtime, pero restringe el guest a Linux y aumenta la importancia del hardening del host.
Entre los servicios esenciales del PVE están el pveproxy (HTTPS/API en el puerto 8006 y front-end de la GUI), pvedaemon (ejecución privilegiada de operaciones), pvestatd (recolección periódica de estado), pve-cluster/pmxcfs (configuración distribuida montada en /etc/pve), corosync (membership, mensajería y quórum), pve-ha-crm/pve-ha-lrm (coordinación y ejecución de recursos HA), además de las herramientas de gestión de VMs (qemu-server/qm) y contenedores (pve-container/pct).
El principio de ingeniería central: no depender del node físico como unidad de aplicación. El node debe tratarse como parte reemplazable del clúster — la identidad y el estado persistente deben estar en storage, red, backup y configuración distribuida.
Panel de gestión: GUI y Datacenter Manager
La interfaz web está integrada al propio PVE: no es necesario un appliance de gestión separado para operar un clúster. El modelo es multi-master — cualquier node en quórum puede ofrecer la vista completa del clúster, lo que elimina el "manager node" dedicado como punto único de administración.
El Proxmox Datacenter Manager (PDM) fue creado para entornos distribuidos y grandes flotas. Conecta "remotes" — clústeres PVE, nodes standalone e instancias PBS — y consolida inventario, métricas, estado, tareas, actualizaciones y operaciones de ciclo de vida. La arquitectura es desacoplada: la indisponibilidad del PDM no interrumpe las VMs de los clústeres gestionados. Sus capacidades incluyen dashboard global, guest management entre remotes, snapshots centralizados, monitoreo de Ceph, registro central de suscripciones, instalación automatizada vía answer files, migración cross-cluster y visibilidad/ejecución central de actualizaciones.
El PDM no sustituye al PVE: las configuraciones avanzadas todavía pueden requerir la GUI nativa del remote. Trátelo como plano de gestión global, no como requisito para el funcionamiento de las VMs.
Clúster, pmxcfs, Corosync y quórum
Clúster no significa HA automáticamente. Para el reinicio automático de guests tras una falla, es necesario combinar quórum saludable, storage accesible y recursos registrados en el HA.
El Proxmox Cluster File System (pmxcfs) es un filesystem en userspace montado en /etc/pve. Replica configuraciones en tiempo real entre nodes vía Corosync, realiza verificaciones de consistencia y se vuelve de solo lectura cuando el node pierde quórum. Toda la configuración de VMs, storages, usuarios, firewall, HA y SDN vive en ese plano de control.
| Topología | Votos útiles | Falla tolerable antes de perder mayoría | Comentario |
|---|---|---|---|
| 2 nodes | 2 | 0 sin qdevice | Use qdevice para un tercer voto en producción |
| 3 nodes | 3 | 1 | Estándar mínimo clásico para HA |
| 5 nodes | 5 | 2 | Mayor margen de falla |
| 7 nodes | 7 | 3 | Común en clústeres mayores; aún exige diseño de red |
El quórum protege contra el split-brain: si una partición de red deja subconjuntos del clúster sin mayoría, esos lados no deben continuar tomando decisiones conflictivas sobre los mismos recursos. Para Corosync, use una red estable y de baja latencia (el jitter y la pérdida importan tanto como el ancho de banda), separe el tráfico de storage y de VM del tráfico de clúster siempre que sea posible, implemente redundancia de enlaces Corosync/Knet y evite extender un único clúster por WAN de alta latencia sin un análisis específico de failure domains.
Alta disponibilidad y Dynamic Load Balancer
Cuando un node falla, el HA intenta recuperar los servicios configurados iniciándolos en nodes elegibles — esto no es "zero downtime": existe un intervalo para detección, fencing/lock y boot del guest. El zero downtime a nivel de aplicación exige mecanismos dentro del propio software, como base de datos replicada, clúster de aplicación o balanceador con múltiples instancias.
Los componentes internos del HA incluyen el CRM (Cluster Resource Manager, que decide el estado deseado y coordina recursos en el clúster), el LRM (Local Resource Manager, que ejecuta start/stop/migrate localmente), watchdog/fencing (evita que dos nodes ejecuten el mismo recurso en escenarios de falla), HA rules/groups (restringen posicionamiento y afinidades) y el maintenance workflow (prepara un node para mantenimiento sin perder estado operativo).
El PVE 9.2 añade un Dynamic Load Balancer vinculado al Cluster Resource Scheduler (CRS), que mejora el posicionamiento de workloads y rebalancea guests según utilización y reglas — balanceo de infraestructura, no autoscaling de aplicación.
Capacidad N-1: si el clúster funciona normalmente al 85–90% de RAM o CPU, el HA puede existir "en el papel" y fallar en la práctica por falta de capacidad de destino. El sizing de producción debe reservar capacidad para la mayor falla planificada.
Red: bridges, VLAN, SDN, EVPN/BGP y WireGuard
La Linux Bridge es el camino más directo: NIC física → bridge vmbrX → interfaces VirtIO de las VMs. Con VLAN-aware, un bridge trunk puede transportar varias VLANs y cada guest recibe una tag — simple, eficiente y adecuado para muchos entornos enterprise.
En bonding, active-backup ofrece redundancia simple sin depender de LACP, mientras que 802.3ad/LACP agrega enlaces y distribuye flujos (siempre que el switch esté correctamente configurado). Un único flujo TCP normalmente no usa la suma de todos los enlaces, ya que el hashing suele mantener el flujo en un miembro del bond.
El SDN del PVE permite crear zonas y VNets de forma centralizada. La stack evolucionó hacia VXLAN/EVPN, BGP y, en el 9.2, fabrics WireGuard y políticas de enrutamiento más granulares — uso creciente en multi-tenant, edge y entornos donde la red virtual necesita acompañar el lifecycle de los workloads.
| Tecnología | Use cuando | Punto de atención |
|---|---|---|
| VLAN | Segmentación L2 tradicional | Escala limitada por el dominio L2 y los IDs de VLAN |
| VXLAN | Overlays y multi-tenant | Exige underlay IP consistente y MTU coherente |
| EVPN/BGP | Control distribuido de reachability | Requiere un dominio de enrutamiento bien operado |
| WireGuard Fabric | Conectividad segura entre endpoints/sites | Planificar MTU, claves y rutas |
| Firewall distribuido | Política cercana al guest | Las reglas y objetos necesitan gobernanza |
Storage: ZFS, NFS, SAN/iSCSI/FC y plugins
Local-LVM, LVM-thin y ZFS entregan baja latencia y simplicidad por host. La contrapartida es la movilidad: la live migration de una VM con disco local necesita copiar el storage, y el HA depende de la replicación u otro mecanismo para que el destino tenga los datos.
En ZFS, los mirrors tienden a entregar un perfil de IOPS superior a RAID-Z para VMs con I/O aleatorio de la misma cantidad de discos. Planifique RAM para el ARC y evite el RAID por hardware por debajo del ZFS cuando el objetivo es que el propio ZFS controle los discos. La replicación ZFS del PVE es útil para DR/HA con RPO periódico, pero no sustituye el storage síncrono compartido.
| Backend | Modelo | Puntos fuertes | Riesgos / límites |
|---|---|---|---|
| NFS | File | Simple, amplio soporte, snapshots según el NAS | El servidor/array necesita ser HA y estar bien dimensionado |
| iSCSI + LVM | Block | SAN tradicional, multipath, desempeño previsible | Operación de LUN/paths y dependencia del array |
| Fibre Channel | Block | Baja latencia, zoning y SAN madura | Costo/complejidad de fabric y multipath |
| Ceph RBD | Distribuido | Sin array central, self-healing, scale-out | La red y la operación son críticas |
| ZFS local | Local | Latencia, snapshots, independencia de SAN | La migración de disco y el HA exigen estrategia adicional |
Cuando todos los nodes acceden al mismo volumen compartido, la migración normal no necesita transferir el disco de la VM — principalmente se migran memoria y estado de CPU/dispositivos, reduciendo drásticamente el volumen de datos en el camino de migración.
Ceph hiperconvergente en profundidad
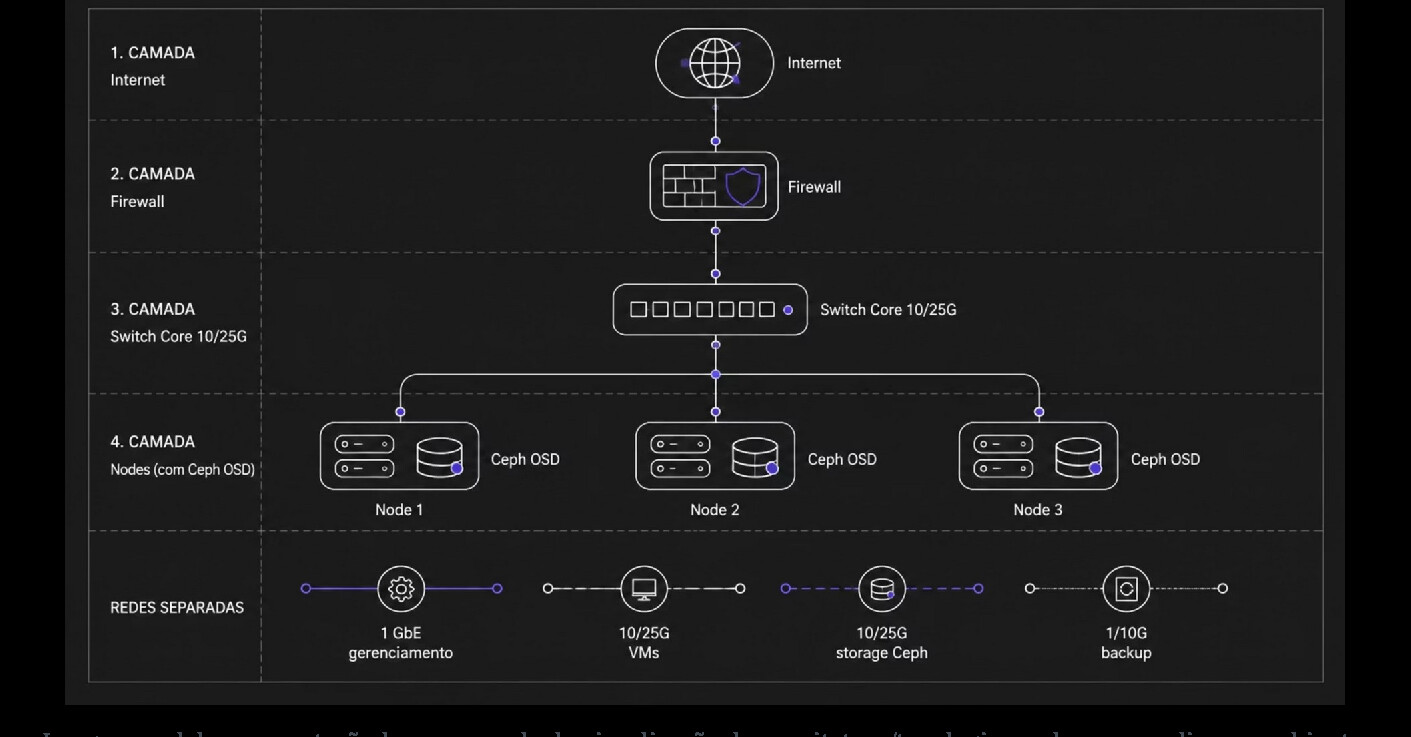
Ceph elimina el array central, pero cambia simplicidad por distribución, consenso y tráfico de réplica. Sus componentes principales son el MON (mantiene mapas y quórum del clúster Ceph), el MGR (métricas y módulos de gestión), los OSDs (almacenan objetos y participan en réplica/recovery), el CRUSH (algoritmo que determina el placement según reglas y failure domains), el RBD (dispositivo de bloque para discos de VMs) y el CephFS (filesystem POSIX distribuido).
En un pool replicado con size=3, un dato lógico se almacena en tres OSDs/failure domains distintos, por lo que una aproximación inicial de capacidad lógica es raw/3, antes de reservas, metadata y headroom operativo:
| Ejemplo | Cálculo | Resultado |
|---|---|---|
| 3 nodes × 4 NVMe × 3,84 TB | 3 × 4 × 3,84 | 46,08 TB raw |
| Pool size=3 | 46,08 / 3 | 15,36 TB lógicos nominales |
| Meta operativa 75% | 15,36 × 0,75 | 11,52 TB de ocupación objetivo |
El benchmark oficial de Proxmox de 2023/12 mostró que 10 Gb/s puede saturarse con un solo SSD muy rápido; 25 Gb/s también puede convertirse en un cuello de botella; 100 Gb/s desplazó el cuello de botella en parte hacia el cliente Ceph en el entorno probado. En 2026, esto refuerza 25/100 GbE como diseño natural para HCI NVMe, dependiendo del número de OSDs y del workload.
La falla de un OSD o node no solo reduce la redundancia: dispara tráfico de recuperación. El clúster necesita tener ancho de banda e IOPS libres para servir aplicaciones y recuperar réplicas al mismo tiempo — por eso, el desempeño en estado degradado debe formar parte del test de aceptación.
Ceph no es backup: la replicación protege contra fallas físicas, pero la eliminación accidental, el ransomware o la corrupción lógica también se replican. Use Proxmox Backup Server y copias fuera del clúster.
Migración de VMs y compatibilidad de CPU
En la migración offline, el guest se apaga y se mueve. En la live migration, el guest continúa ejecutándose mientras las páginas de memoria se copian y reenvían conforme quedan "sucias" — el switchover final es corto cuando la tasa de dirty pages converge por debajo de la capacidad de transferencia.
Sobre el CPU model: "host" maximiza la exposición de features y el potencial de desempeño, pero reduce la portabilidad entre generaciones diferentes; un modelo común/custom define un baseline para nodes heterogéneos y facilita la live migration. Antes de expandir el clúster, valide flags de CPU, microcode y firmware — no solo fabricante y número de cores.
Como ejercicio de capacidad: una VM con 64 GiB migrando por una red 25 GbE con throughput efectivo de 2,7 GB/s tendría un primer pase de aproximadamente 24 segundos. Transferir 1 TiB de disco por 25 GbE a 2,5 GB/s efectivos tiene un piso teórico de alrededor de 7 minutos — con storage compartido, ese volumen de disco normalmente deja de formar parte de la migración.
Backup, restore y Proxmox Backup Server
La alta disponibilidad reduce la indisponibilidad; el backup reduce la pérdida de datos y amplía las opciones de recuperación. El PBS recibe backups de VMs, contenedores y hosts, envía datos de forma incremental y deduplica chunks en el datastore — cada snapshot continúa representando un backup completo desde el punto de vista de la restauración, con checksums SHA-256 para verificación de integridad y soporte para cifrado client-side.
- Incremental + deduplicación: reduce la red y la capacidad consumida entre puntos de backup
- Verify jobs: detectan corrupción con checksums y lectura periódica
- Prune + GC: aplican retención y eliminan chunks no referenciados
- Sync jobs: replican datastores/namespace a otro PBS
- Client-side encryption: el servidor remoto puede almacenar datos sin conocer el contenido
- Tape: capa offline/air-gap física para retención prolongada
- S3-backed storage (novedad de la versión 4.2): amplía las opciones de backend para backup
La regla 3-2-1-1-0 aplicada: 3 copias de los datos (contando producción), 2 tipos/ubicaciones de medios o failure domains, 1 copia off-site, 1 copia offline/inmutable y 0 errores no detectados — lo que exige jobs de verify y pruebas de restore reales.
Para un sizing rápido, la documentación del PBS recomienda, para producción, CPU moderna con al menos 4 cores, mínimo de 4 GiB para sistema/cache/daemons y aproximadamente 1 GiB adicional de RAM por TiB de storage — un punto de partida, ya que la dedup, el verify, el filesystem, el paralelismo y la ventana de backup pueden exigir más memoria e IOPS.
RPO y RTO son decisiones de negocio: los backups cada 24 horas no entregan un RPO de 15 minutos, y tener backup no garantiza un RTO bajo si el restore de cientos de TB nunca fue ensayado.
Identidad: AD, LDAP y Microsoft Entra ID
La autenticación centralizada reduce las cuentas locales, pero el RBAC continúa siendo la capa de autorización de Proxmox. Los realms soportados incluyen pam (break-glass/administración Linux), pve (usuarios internos), LDAP (directorios genéricos), Active Directory (integración nativa del directorio Microsoft) y OpenID Connect (SSO moderno vía Entra ID, Keycloak o Google).
Para Microsoft Entra ID, el diseño moderno es OpenID Connect: el PVE usa discovery a partir del issuer URL, que en un tenant Microsoft normalmente sigue el patrón https://login.microsoftonline.com/<tenant-id>/v2.0. Es necesario registrar el PVE como aplicación Web/confidential client, configurar Client ID y Client Secret y registrar exactamente los redirect URIs usados por los administradores.
Autocreate no otorga privilegios: crear automáticamente el usuario tras el primer login no significa convertirlo en administrador. Defina grupos, roles y ACLs de menor privilegio, mantenga un usuario local de emergencia y pruebe el login OIDC antes de convertirlo en predeterminado.
Las buenas prácticas para Entra ID incluyen usar una app registration dedicada al entorno Proxmox (sin reutilizar el secreto de otra aplicación), DNS y certificado TLS válidos para la URL de administración, MFA/Conditional Access para administradores, rotación de client secret con monitoreo de expiración, grupo de seguridad dedicado con mapeo documentado y prueba de falla del proveedor de identidad — el operador debe seguir siendo capaz de usar una cuenta break-glass local.
Seguridad: RBAC, MFA, firewall, API tokens y hardening
El hipervisor es una capa privilegiada: reducir superficie y privilegios es obligatorio. En Proxmox, los permisos combinan sujeto (user/group/token), role (conjunto de privilegios) y path (objeto) — los Resource Pools ayudan a delegar conjuntos de VMs y storages sin otorgar acceso a todo el clúster.
TOTP y WebAuthn son mecanismos comunes de MFA para cuentas locales; para OIDC, el MFA normalmente se realiza en el Identity Provider. Use tokens de API para automatización en lugar de contraseñas humanas — los tokens pueden tener privilegios separados del usuario y deben recibir solo los permisos necesarios, con secretos guardados en vault, nunca en scripts o repositorios Git.
El firewall distribuido del PVE aplica reglas en los nodes y puede operar en los niveles Datacenter, Node y VM/CT, con Security Groups, IP Sets, aliases y macros reduciendo la duplicación. En multi-tenant, combine firewall, VLAN/VXLAN y RBAC — ninguno de ellos por separado representa una segmentación completa.
El checklist de hardening incluye: red de gestión fuera de internet pública con acceso vía VPN/bastion; TLS con certificado confiable y DNS consistente; SSH con claves y logging central; enterprise repository en producción con ventana de patching definida; MFA para administradores y revisión periódica de ACLs/API tokens; NTP confiable (el horario afecta al clúster, logs, certificados y autenticación); firmware/BMC aislados en red de gestión con credenciales propias; y backup de la configuración con pruebas de recuperación del clúster.
Orquestación e Infrastructure as Code
Proxmox ofrece primitives; la automatización transforma esos primitives en servicio repetible. La API REST expone prácticamente las mismas operaciones que la GUI, usando JSON y schema formal — la propia GUI es, en gran parte, un cliente de esa API.
En la línea de comandos, las principales herramientas son qm (lifecycle de VMs), pct (lifecycle de contenedores LXC), pvesh (llamada local del árbol de API), pvesm (storage manager), pvecm (clúster y Corosync), pveum (usuarios, grupos, realms, ACLs y tokens) y ha-manager (recursos y reglas HA).
La propia Proxmox posiciona a Ansible y Terraform/OpenTofu como caminos de automatización. En proyectos reales, trate providers/collections como componentes de software con versión fija, pruebas y pipeline — no mezcle cambios manuales e IaC sin una política clara de ownership, porque el drift es inevitable.
Es importante destacar que el PVE no es Kubernetes: Proxmox orquesta infraestructura virtual, mientras que Kubernetes orquesta aplicaciones containerizadas. Ambos pueden coexistir — VMs en el PVE hospedan control planes/workers Kubernetes, mientras el PVE se encarga del lifecycle, HA, red y storage de la infraestructura.
Observabilidad, logs, métricas y operación
Un clúster saludable necesita ser observable antes de la primera falla. Los dominios a monitorear incluyen node (CPU, load, RAM, swap, temperatura, filesystem), clúster (quórum, enlaces Corosync, HA state), VM/CT (CPU, RAM, ballooning, disk throughput/latency), Ceph (HEALTH, OSD up/in, PG states, recovery/backfill), network (drops/errors, LACP, MTU mismatch) y PBS (duración de job, dedup ratio, verify errors, pruebas de restore).
El PVE puede enviar métricas a sistemas externos, con amplia integración con Zabbix, Prometheus/InfluxDB vía exporters y Grafana, además de mantener historial RRD nativo para gráficos operacionales.
Como SLO operativo sugerido: quórum en el 100% de los períodos de producción (excluyendo mantenimiento planificado); Ceph en HEALTH_OK como estado esperado, con warning generando ticket; éxito de backup medido por RPO, no solo "job ejecutado"; pruebas automatizadas de restore con RTO medido; y alertas de capacidad antes del 70–75% de RAM/storage en clústeres sin gran holgura.
Licenciamiento y suscripción comercial
Proxmox VE es software libre bajo GNU AGPLv3. No existe una edición "capada" sin subscription: las funciones de HA, live migration, clúster, backup, storage y networking están disponibles independientemente del nivel de suscripción — la suscripción comercial diferencia principalmente el repositorio enterprise, el soporte y el SLA.
| Plan | €/socket/año | Tickets / respuesta publicada | Uso típico |
|---|---|---|---|
| Community | 120 | Sin tickets de soporte | Lab, capacitación y no crítico |
| Basic | 370 | 3 / 1 día hábil | Producción menor, equipo autónomo |
| Standard | 550 | 10 / 4 horas | Producción enterprise con escalamiento |
| Premium | 1.100 | Ilimitados / 2 horas | Misión crítica y mayor cobertura |
Reglas importantes: se cuenta el socket físico ocupado (la cantidad de cores no altera el precio), todos los nodes de un mismo clúster deben mantener el mismo nivel de subscription, la suscripción es anual, y los planes Basic/Standard/Premium incluyen el Enterprise Repository y soporte comercial. El PDM es open source — para soporte enterprise del PDM, los remotes con suscripciones activas calificadas dan cobertura sin una clave separada.
El 02 de septiembre de 2026, Proxmox anunció soporte enterprise 24/7 global a partir del 19 de octubre de 2026: Premium tendrá 24/7 desde el inicio, Standard entra en ventana de onboarding en el cuarto trimestre y Basic mantiene el SLA existente. En la fecha de corte de este material, el cambio había sido anunciado, pero aún no estaba vigente.
Desempeño: benchmark, red, storage y latencia
El desempeño en virtualización es una cadena: guest → hipervisor → kernel → red/storage → hardware. En el benchmark 2023/12 de un clúster hiperconvergente con SSDs rápidos, Proxmox reportó 10 Gb/s fácilmente saturado, 25 Gb/s también pudiendo convertirse en cuello de botella, y en 100 Gb/s un cliente alcanzando hasta aproximadamente 6.000 MiB/s de escritura y 7.000 MiB/s de lectura — con múltiples clientes en paralelo, hasta aproximadamente 9.800 MiB/s de escritura y 19.500 MiB/s de lectura.
Estos números son resultados de laboratorio publicados, no una especificación del producto: una VM individual puede quedar muy por debajo del throughput agregado del Ceph por límites de cola, iodepth, CPU, RBD, filesystem, bloque y aplicación.
Cada perfil de workload prioriza métricas diferentes: las bases OLTP priorizan latencia p99 y fsync en 4K random; VDI prioriza IOPS/latencia en boot storm; el backup prioriza throughput secuencial y CPU de deduplicación; las cargas de IA/datos priorizan throughput, NIC y GPU passthrough/vGPU; y las aplicaciones web generales priorizan CPU scheduler y latencia moderada.
Sizing: CPU, RAM, storage, red y reserva N-1
No existe un ratio universal de vCPU:pCPU. Como regla de ingeniería (no límite del PVE), workloads críticos y sensibles a la latencia pueden acercarse a 1:1 a 2:1, servidores generales frecuentemente aceptan mayor oversubscription, y entornos de dev/test pueden ir más allá — el indicador decisivo es la latencia del workload observada bajo contención real.
La memoria de guest es más rígida que la CPU: el overcommit excesivo fuerza ballooning/swap y produce una degradación abrupta. En clústeres HA, es necesario calcular el node más cargado fallando y redistribuir sus VMs en los supervivientes:
| Ítem | 3 nodes | Tras falla de 1 node |
|---|---|---|
| RAM física | 3 × 512 GiB = 1.536 GiB | 1.024 GiB disponibles |
| Reserva host/Ceph | ~64 GiB por node (ejemplo) | ~128 GiB en los 2 restantes |
| RAM útil aproximada | 1.344 GiB en estado normal | ~896 GiB tras la falla |
| Meta de guests para N-1 | ≤ ~896 GiB | Cabe en los 2 supervivientes |
Para storage, considere capacidad (raw × eficiencia de protección × headroom), desempeño (IOPS y throughput por device, multiplicados de forma realista por la topología RAID/Ceph), latencia (medida en p95/p99 bajo carga y en recovery, no solo el promedio), endurance (DWPD/TBW de SSDs enterprise) y failure domain (chasis, node, rack, switch, PDU y site).
Para red en entornos hiperconvergentes, sume tráfico de cliente, réplica, recovery y migración: un clúster con 25 GbE por node puede tener excelente desempeño normal y aun así sufrir durante backfill, live migration y backup coexistiendo — QoS, redes separadas o 100 GbE pueden ser económicamente justificables en ese escenario.
Arquitecturas de referencia
Tres diseños ayudan a transformar requisitos en componentes concretos. El Escenario A, 3 nodes hiperconvergentes para producción, combina 3 servidores con RAM ECC y fuentes redundantes, boot en SSDs en espejo, 4–8 SSD/NVMe enterprise por node para Ceph en modo JBOD/HBA IT, redes de 2×25 GbE o 2×100 GbE para datos con gestión separada, enlaces Corosync redundantes, PBS externo al clúster con copia off-site y capacidad N-1 validada para los guests críticos en HA.
El Escenario B, 5 nodes con SAN enterprise, usa el PVE como compute cluster manteniendo el storage compartido en array HA Fibre Channel/iSCSI — reduce la complejidad de operar Ceph y puede ser ideal cuando la empresa ya domina SAN, tiene inversiones existentes y exige funciones específicas del array.
El Escenario C, 2 nodes con qdevice en el edge, resuelve el quórum pero no crea capacidad mágica: exige storage compartido redundante o ZFS replication con RPO explícito — útil en filiales/edge cuando tres servidores completos son económicamente inviables.
Para operaciones multi-site, mantenga clústeres locales por site (latencia y quórum), use el PDM para visión y operaciones globales, PBS Sync para copias off-site y, cuando corresponda, cross-cluster migration. No trate dos sites distantes como un único clúster solo para "tener HA geográfico".
Migración de VMware/Hyper-V y modernización
Migrar no es solo convertir disco: involucra red, drivers, CPU, backup, observabilidad y rollback. El PVE posee mecanismos de importación de guests ESXi/OVA en versiones recientes, pero la estrategia de producción aún debe mapear vNICs, VLANs, storage, snapshots, el cambio de VMware Tools por QEMU Guest Agent/VirtIO, BIOS/UEFI y tipos de controladora.
Las VMs de Hyper-V normalmente requieren conversión/importación de discos VHD/VHDX y ajuste de drivers/controladoras — para Windows, es necesario preparar VirtIO y validar boot, red, activación y aplicaciones antes de la primera ventana de producción.
Las fases recomendadas siguen: discovery (inventario, dependencias, RTO/RPO, VLANs, storage y licencias); landing zone (clúster PVE, redes, storage, DNS/NTP, identidad, backup y observabilidad); pilot (workloads no críticos y pruebas de desempeño/rollback); waves (migración por grupos de dependencia, con ventana y criterios de éxito); optimization (CPU models, VirtIO, cache, backup, HA y rightsizing); y decommission (solo después de la retención/rollback y validación de negocio).
Runbook operacional, pruebas de falla y checklist
La producción madura transforma operaciones raras en procedimientos ensayados. La prueba de aceptación de un clúster debe cubrir: apagar un enlace Corosync (el clúster debe mantener membership por el enlace redundante), apagar un node (el quórum debe permanecer y los guests HA deben recuperarse según la política), fallar un OSD (el Ceph debe permanecer disponible e iniciar recovery), fallar un switch de datos (el bond/red redundante debe mantener el tráfico), migrar en vivo una VM crítica (sin pérdida de sesión más allá del comportamiento esperado de la aplicación), restaurar vía PBS (la VM restaurada debe validarse dentro del RTO) y simular la indisponibilidad del proveedor de identidad (la cuenta local break-glass debe seguir administrando el entorno).
El flujo de patching recomendado es: validar el backup y la salud del clúster/Ceph; migrar/evacuar workloads del node; entrar en maintenance workflow cuando aplique; aplicar updates y reiniciar si es necesario; validar NICs, Corosync, storage, HA y versiones; reintroducir el node observando recovery/rebalance; y repetir node por node — nunca "todo de una vez" sin un diseño específico.
Para cambios de configuración: recuerde que el snapshot no es un rollback universal (los cambios de red/clúster/storage pueden quedar fuera de la VM), mantenga change ticket, diff de configuración y plan de retorno, automatice la repetición pero conserve gates humanos para cambios de alto riesgo, y guarde export/backup de configuración junto con la documentación de switch/SAN/BMC.
Errores comunes y decisiones de proyecto
Los incidentes más costosos suelen comenzar con una premisa demasiado simplificada. Entre los errores más frecuentes: asumir que "clúster = HA" (sin storage y configuración de HA, el guest no se recupera solo); usar 2 nodes sin qdevice (la pérdida de un voto elimina la mayoría); ejecutar Ceph en red de 1/10 GbE con NVMe (la red se convierte en cuello de botella y el recovery compite con la producción); tratar Ceph como backup (la replicación también propaga eliminación accidental, ransomware o corrupción); operar normalmente al 80–90% de RAM (la capacidad N-1 no cabe tras una falla); implementar SSO sin break-glass (la falla del proveedor de identidad bloquea la administración); mezclar IaC con cambios manuales (genera drift y resultados no deterministas); y considerar un job de backup exitoso como garantía de recuperabilidad, sin nunca probar el restore.
La pregunta que debe anteceder la elección de la tecnología es simple: ¿qué falla exige el negocio sobrevivir — disco, node, switch, rack, site, operador, ransomware — y en cuánto tiempo? La respuesta define el diseño más que el nombre del hipervisor.
Conclusión
Un entorno Proxmox robusto no es "tres servidores con una interfaz bonita". Es un sistema distribuido con dependencias explícitas: quórum, red, storage, identidad, backup, capacidad de failover, observabilidad y procesos. La ganancia es flexibilidad — la misma plataforma puede operar con ZFS local, SAN tradicional o Ceph hiperconvergente, en x86-64 o Arm64 soportado, administrada por GUI, API o Infrastructure as Code.
Como resumen de decisiones: 3 o más nodes para producción con HA es la referencia más simple, siendo que 2 nodes exigen qdevice y un diseño cuidadoso; el Ceph es excelente cuando hay escala, red rápida, discos adecuados y capacidad operativa; el storage compartido tradicional puede ser la mejor solución cuando la simplicidad y una SAN madura pesan más; el Datacenter Manager añade gestión multi-site sin convertirse en dependencia para la ejecución de las VMs; Entra ID vía OIDC moderniza el SSO, pero RBAC/ACL y break-glass siguen siendo indispensables; las suscripciones se cobran por socket y no bloquean funcionalidades, por lo que la elección del nivel debe seguir el soporte/SLA necesario; y los benchmarks publicados deben convertirse en pruebas locales de aceptación, incluso en estado degradado.
Este contenido es un resumen técnico consolidado a partir de la documentación y los materiales oficiales de Proxmox, con fecha de corte el 02 de septiembre de 2026. Precios, SLA y versiones deben revalidarse antes de cualquier contratación o proyecto de implementación.